1. 本章目标 #
第 8~9 章已经能做出多工具办公助理:工具定义清楚、系统提示有策略、还能按角色动态过滤工具。 离「能给真人用」还差一层:出错会不会重试、会不会烧费用、会不会泄露隐私、危险操作有没有人点头。
这类横切能力,官方建议用 Middleware 叠在驾驭层(create_agent)上,而不是把 if 散落在每个工具里。
一句话对照:
| 第 8~9 章偏 | 本章偏 |
|---|---|
| 业务能力(工具、提示、动态选型) | 生产护栏(稳定、节省费用、安全、审批) |
自定义钩子(@dynamic_prompt 等) |
内置中间件(Retry 重试 / Limit 限流 / PII 脱敏 / HITL 人机协同) |
本章目标:
用内置 Middleware 给 Agent 加上重试、限流、PII 处理与人机协同(HITL),组装带护栏的生产 Agent。
学完你应能:
- 理解 middleware 在 Agent 循环中的挂载位置与组合方式
- 配置
ModelRetryMiddleware/ToolRetryMiddleware做瞬态失败重试 - 用
ModelCallLimitMiddleware/ToolCallLimitMiddleware做调用限流 - 用
PIIMiddleware检测与脱敏敏感信息 - 用
HumanInTheLoopMiddleware+ checkpointer 做危险工具审批 - 识别护栏之间的冲突——这是本章最容易被忽略、后果也最严重的一类问题(§6.4)
- 产出一套带护栏的生产办公 Agent
护栏有个特点:配错了往往不报错,只是不起作用,或者悄悄把功能弄坏。 本章有几条实测结论,建议先看一眼:
| 你可能以为 | 实际情况 | 见 |
|---|---|---|
| 对邮箱脱敏是纯收益 | 装了 PIIMiddleware("email") 的发信 Agent,会把邮件发给字符串 [REDACTED_EMAIL] |
§6.4 |
| PII 只改模型看到的输入 | 连 messages 状态一起改写,原文在轨迹里就没了 |
§6.3 |
exit_behavior="end" 是优雅收尾 |
用户会收到一句 Model call limits exceeded: run limit (1/1) 当作回答 |
§5.3 |
默认 retry_on 够用 |
默认是 (Exception,),连 401 认证失败都会老实重试三遍 |
§4.3 |
| HITL 不配 checkpointer 会立刻报错 | 第一跳照常返回 interrupts,直到 resume 才炸 |
§7.5 |
resume 时 thread_id 写错会报错 |
静默开一段新对话,待审的邮件永远发不出去 | §7.5 |
version="v2" 是 HITL 的必需项 |
v1 也能用,读 result["__interrupt__"] 即可;v2 只是更清晰 |
§7.2 |
参考文档:
第 9 章的 @dynamic_prompt / @wrap_model_call / @wrap_tool_call 是自定义钩子;本章以内置护栏中间件为主,二者可以叠在同一个 middleware=[...] 里。
2. 为什么需要护栏 Middleware #
没有护栏时,常见事故:
| 事故 | 后果 |
|---|---|
| 模型 / 工具偶发超时直接失败 | 用户直观感受「助手时好时坏、不可靠」 |
| Agent 死循环狂调模型 | 费用与延迟暴涨 |
| 用户把邮箱、卡号贴进对话 | 日志与轨迹里明文泄露 |
| 模型自行「发邮件 / 删数据」 | 不可逆副作用 |
容易走偏的两种写法:
- 全写进工具函数——每个工具里手写重试、脱敏、审批,复制粘贴、漏改、难测
- 全写进系统提示——「请勿泄露隐私」「发信前请确认」只是软约束,模型仍可能违抗
Middleware 的价值在于:把横切策略收成可插拔、可组合、与业务工具解耦的一层。
护栏的原则:
可预期业务错误靠工具返回说明;瞬态故障靠重试;预算靠限流;敏感数据靠 PII;不可逆操作靠 HITL。
对照记忆:
| 问题类型 | 谁来管 | 例子 |
|---|---|---|
| 业务可知失败 | 工具 return "错误:..." |
订单号不存在 |
| 偶发基础设施失败 | Retry(重试) | 超时、429 |
| 调用过多 | Limit(限流) | 死循环、贵 API 刷爆 |
| 敏感原文 | PII(脱敏) | 邮箱、卡号 |
| 不可逆副作用 | HITL(人工审批) | 发信、转账、删库 |
它们都是驾驭层的插件:业务工具函数尽量保持「只做一件事」,策略与安全交给 middleware。
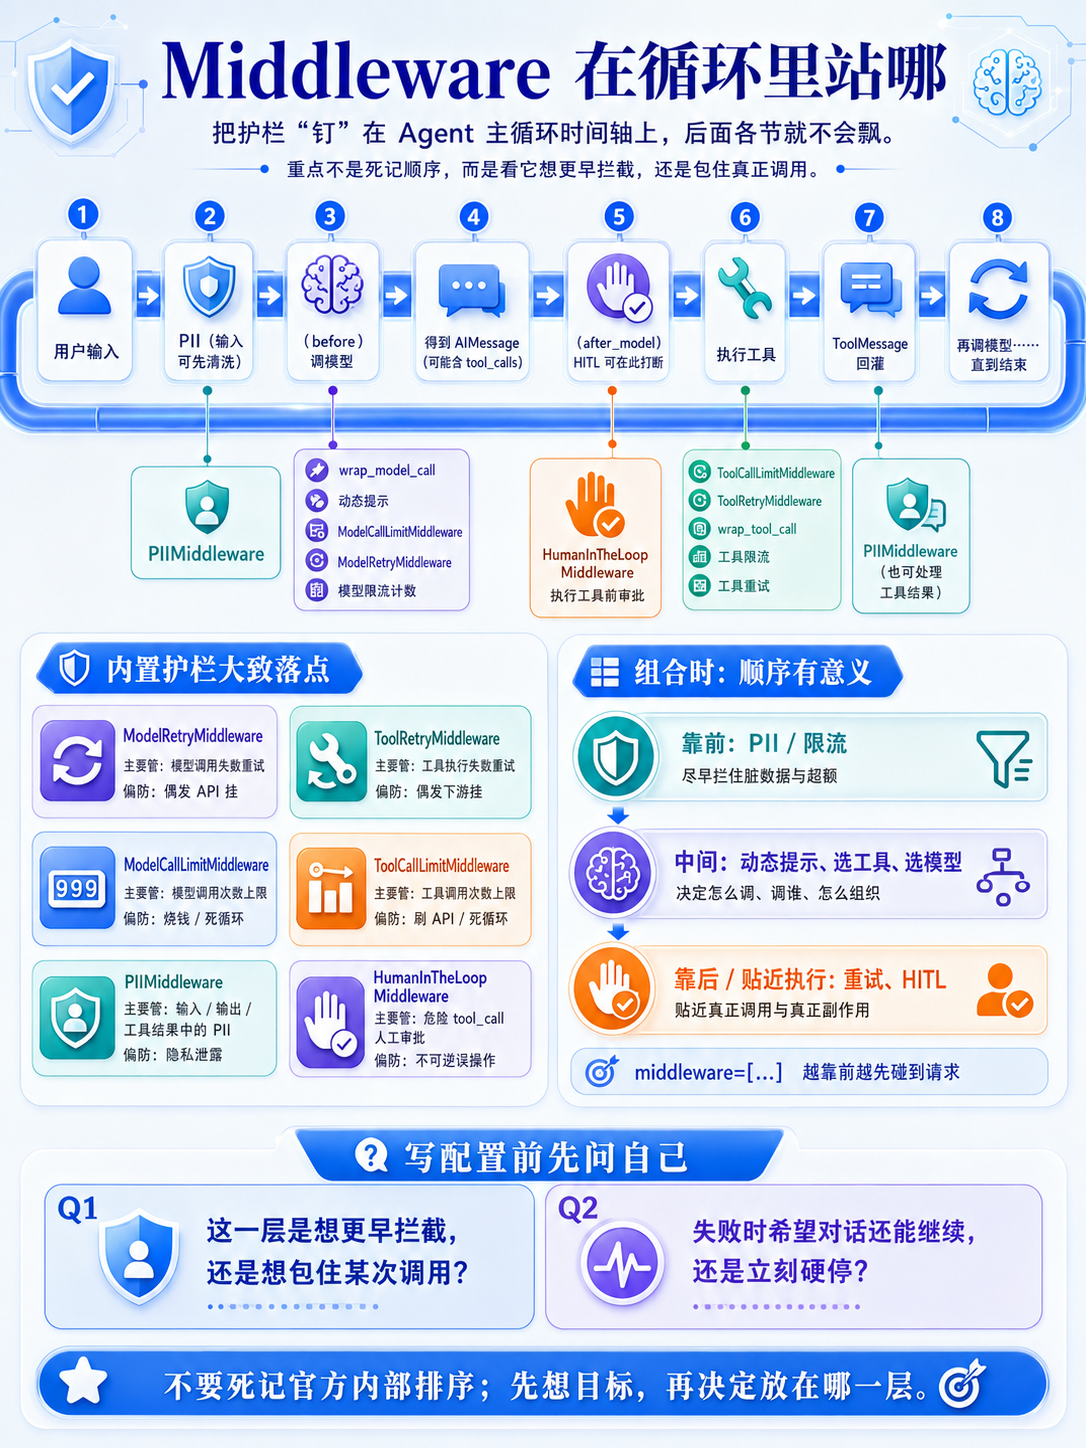
3. Middleware 在循环里的位置 #
回顾 Agent 主循环,把护栏「钉」在时间轴上:
用户输入
  → PII(可先清洗输入)
  →(before)调模型 ← wrap_model_call / 动态提示 / 模型限流计数 / 模型重试
  → 得到 AIMessage(可能含 tool_calls)
  →(after_model)HITL 可在此打断(执行工具前)
  → 执行工具 ← 工具限流 / 工具重试 / wrap_tool_call
  → ToolMessage 回灌(PII 也可处理工具结果)
  → 再调模型……直到结束
内置护栏大致落点:
| 中间件 | 主要管什么 | 「防什么」 |
|---|---|---|
ModelRetryMiddleware |
模型调用失败重试 | 偶发 API 挂 |
ToolRetryMiddleware |
工具执行失败重试 | 偶发下游挂 |
ModelCallLimitMiddleware |
模型调用次数上限 | 烧钱 / 死循环 |
ToolCallLimitMiddleware |
工具调用次数上限 | 刷 API / 死循环 |
PIIMiddleware |
输入 / 输出 / 工具结果中的 PII | 隐私泄露 |
HumanInTheLoopMiddleware |
危险 tool_call 人工审批 | 不可逆误操作 |
ModelFallbackMiddleware |
主模型失败时切换备用模型 | 单供应商故障 |
官方 Guardrails 页把 PII、限流、HITL 等归为同一套「生产护栏」思路;本章按「重试 → 限流 → PII → HITL」顺序展开。模型降级可在主模型 Retry 仍失败时叠加 ModelFallbackMiddleware(与第 9 章动态选模型互补:一个管故障切换,一个管策略分流)。
组合时:middleware=[...] 顺序有意义——越靠前越先碰到请求。可以这样记顺序:
靠前:PII / 限流(尽早拦住脏数据与超额)
中间:动态提示、选工具、选模型(第 9 章)
靠后或贴近执行:重试、HITL(与「真正调用 / 真正副作用」相关)
不必死记官方内部排序的每个细节;写配置时问自己两句:
- 这一层是想更早拦截,还是想包住某次调用?
- 失败时希望对话还能继续,还是立刻硬停?
第 9 章 §2.2 讲过 middleware 的执行是洋葱式嵌套(列表越靠前越在外层);本章内置护栏遵守同一套规则。
3.1. 同一种中间件能挂几个?看它的 name #
第 9 章提过一个坑:重复挂同一个 middleware 会报 AssertionError: Please remove duplicate middleware instances.。
到了本章,这条规则变得很实际——我们经常要给不同工具配不同限额,也就是挂多个 ToolCallLimitMiddleware。
框架靠 name 属性判断是否重复。实测几个内置中间件的 name:
# 导入两个会用到的限流中间件
from langchain.agents.middleware import ModelCallLimitMiddleware, ToolCallLimitMiddleware
# 导入 PII 中间件
from langchain.agents.middleware import PIIMiddleware

# 不带 tool_name 的全局工具限额
print(ToolCallLimitMiddleware(run_limit=10).name)
# 带 tool_name 的单工具限额
print(ToolCallLimitMiddleware(tool_name="search_docs", run_limit=3).name)
# 模型限额没有细分维度
print(ModelCallLimitMiddleware(run_limit=5).name)
# PII 按类型细分
print(PIIMiddleware("email").name)
print(PIIMiddleware("credit_card").name)
输出:
ToolCallLimitMiddleware
ToolCallLimitMiddleware[search_docs]
ModelCallLimitMiddleware
PIIMiddleware[email]
PIIMiddleware[credit_card]规律很清楚:带区分维度的中间件会把维度写进 name,因此可以并存。
| 组合 | 结果 | 原因 |
|---|---|---|
一个全局 + 一个 tool_name="a" 的工具限额 |
可以 | name 不同 |
两个不同 tool_name 的工具限额 |
可以 | name 不同 |
两个都不带 tool_name 的工具限额 |
AssertionError |
name 都是 ToolCallLimitMiddleware |
PIIMiddleware("email") + PIIMiddleware("credit_card") |
可以 | 按类型区分 |
两个 PIIMiddleware("email")(想叠两种策略) |
AssertionError |
name 都是 PIIMiddleware[email] |
最后一条值得记住:同一种 PII 类型只能配一个策略,不能既 redact(遮盖) 又 hash。
4. 重试:模型与工具 #
重试针对的是瞬态失败(超时、429、偶发网络错误),不是业务上的「订单不存在」。
| 业务错误 | 瞬态错误 | |
|---|---|---|
| 再试一次有用吗 | 通常没用(单号还是没有) | 往往有用 |
| 推荐做法 | 工具内 return "错误:..." |
Retry 中间件 |
| 重试耗尽后 | — | continue 回灌 或 error 抛出 |
指数退避(exponential backoff)可以这样理解:第 1 次等 initial_delay,之后按 backoff_factor 拉长,并可用 max_delay 封顶、jitter 加随机抖动,避免大量客户端同一秒重试把服务端打挂。
第 n 次重试前的基础等待(不含抖动)可写成:
$$ t_n = \min(\text{max_delay}, \text{initial_delay} \times \text{backoff_factor}^{n-1}) $$
例如 initial_delay=1.0、backoff_factor=2.0、max_delay=10.0:
| 重试次序 | 计算 | 等待(秒) |
|---|---|---|
| 第 1 次 | min(10, 1 × 2⁰) |
1 |
| 第 2 次 | min(10, 1 × 2¹) |
2 |
| 第 3 次 | min(10, 1 × 2²) |
4 |
| 第 4 次 | min(10, 1 × 2³) |
8 |
| 第 5 次 | min(10, 1 × 2⁴)=16 → 封顶 |
10 |
开启 jitter 后,实际等待会在 t_n 附近再乘一个随机因子(常见落在约 [0.5, 1.5]),让各客户端错开同一秒的重试洪峰。
4.1. ModelRetryMiddleware #
模型 API 偶发失败时自动重试,带指数退避。 正常路径下你几乎感觉不到它;只有供应商偶发超时或 5xx 时,它会在背后多试几次。
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 从 middleware 导入模型重试中间件
from langchain.agents.middleware import ModelRetryMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 一个普通只读工具,用来构造一次正常调用
@tool
def lookup_policy(topic: str) -> str:
    """查询公司制度摘要。"""
    # 演示用固定返回
    return "差旅报销需在返程 7 日内提交。"


# 创建 Agent 并挂上模型重试
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 工具列表
    tools=[lookup_policy],
    # middleware 接收列表
    middleware=[
        # 模型调用失败时自动重试
        ModelRetryMiddleware(
            # 初始调用失败后再重试的次数(默认 2)
            max_retries=2,
            # 退避倍数,每次等待时间乘以它
            backoff_factor=2.0,
            # 首次重试前等待秒数
            initial_delay=1.0,
            # 重试耗尽后:continue=把错误交给后续逻辑;error=抛出
            on_failure="continue",
        ),
    ],
    # 引导模型调用工具
    system_prompt="问制度时调用 lookup_policy,不要编造。",
)

# 正常路径下这次调用不会触发任何重试
result = agent.invoke(
    {"messages": [{"role": "user", "content": "报销怎么走?"}]}
)
# 打印最终回答
print(result["messages"][-1].content)
关键参数:
| 参数 | 默认值 | 含义 |
|---|---|---|
max_retries |
2 |
失败后再试几次(不含首次调用) |
retry_on |
(Exception,) |
哪些异常才重试;默认几乎全捕获,见 §4.3 |
on_failure |
"continue" |
耗尽后 continue 或 error |
backoff_factor |
2.0 |
退避倍数 |
initial_delay |
1.0 |
首次重试前等待秒数 |
max_delay |
60.0 |
等待上限 |
jitter |
True |
是否加抖动,避免多客户端同时重试踩踏 |
注意 max_retries=2 意味着总共尝试 3 次(1 次初始 + 2 次重试)。这一点在读错误信息时很重要,框架的报错原文用的是 attempts(尝试次数),不是 retries。
模型侧重试不太好在本地复现,因为得让 API 真的失败。一个取巧办法是故意用错的 key,观察耗时:
# 从 time 导入计时函数
import time

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入模型重试中间件
from langchain.agents.middleware import ModelRetryMiddleware
# init_chat_model 用于显式传入错误的 api_key
from langchain.chat_models import init_chat_model
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载环境变量
load_dotenv(override=True)


# 占位工具
@tool
def lookup_policy(topic: str) -> str:
    """查询公司制度摘要。"""
    # 返回模拟制度
    return "差旅报销需在返程 7 日内提交。"


# 故意用一个无效 key,让每次模型调用都以 401 失败
bad_model = init_chat_model("deepseek:deepseek-v4-flash", api_key="sk-invalid-key-for-test")

# 记录开始时间
t0 = time.time()

# 挂上重试:0.5s 起,倍数 2,关掉抖动方便算账
agent = create_agent(
    # 传入上面构造的坏模型
    model=bad_model,
    # 工具列表
    tools=[lookup_policy],
    # 配置模型重试
    middleware=[
        ModelRetryMiddleware(
            # 重试 2 次
            max_retries=2,
            # 首次重试等 0.5 秒
            initial_delay=0.5,
            # 之后翻倍
            backoff_factor=2.0,
            # 关掉抖动,让等待时间可预测
            jitter=False,
            # 耗尽后直接抛错,方便观察
            on_failure="error",
        )
    ],
)

# 捕获最终抛出的异常并打印耗时
try:
    agent.invoke({"messages": [{"role": "user", "content": "你好"}]})
except Exception as e:
    # 打印异常类型与总耗时
    print(f"{type(e).__name__},耗时 {time.time() - t0:.2f}s")
输出:
AuthenticationError,耗时 2.05s0.5 + 1.0 = 1.5s 的额外等待说明重试确实发生了。但请注意这个例子暴露的问题——401 认证失败重试再多次也不会成功,却白白等了 1.5 秒。这正是下面 §4.3 要解决的事。
4.2. ToolRetryMiddleware #
工具调外部 API 时同样需要重试。可限定只对部分工具生效——贵或稳的工具别一刀切。
这次让工具真的失败,便于看清重试的每一步。下面的工具前两次抛超时、第三次才成功:
# 从 time 导入计时函数
import time

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入工具重试中间件
from langchain.agents.middleware import ToolRetryMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载 .env 中的 API key
load_dotenv(override=True)

# 用字典记录工具被真实调用了几次(闭包里改整数不方便,用字典)
attempts = {"n": 0}
# 记录每次调用发生的时间戳,用来反推退避间隔
stamps = []


# 一个「前两次必失败」的工具,模拟偶发超时
@tool
def flaky_order(order_id: str) -> str:
    """查询订单状态(模拟偶发超时)。"""
    # 计数加一
    attempts["n"] += 1
    # 记录本次调用时刻
    stamps.append(time.time())
    # 前两次抛超时异常,触发重试
    if attempts["n"] < 3:
        raise TimeoutError(f"第 {attempts['n']} 次调用超时")
    # 第三次返回成功结果
    return f"订单 {order_id}:运输中(第 {attempts['n']} 次尝试成功)。"


# 创建 Agent 并挂上工具重试
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 只有这一个工具
    tools=[flaky_order],
    # 配置重试策略
    middleware=[
        ToolRetryMiddleware(
            # 最多再试 3 次
            max_retries=3,
            # 只对这些工具重试;None 表示全部工具
            tools=["flaky_order"],
            # 退避倍数
            backoff_factor=2.0,
            # 首次重试前等 0.5 秒
            initial_delay=0.5,
            # 关掉抖动,让间隔可预测(生产建议保持默认 True)
            jitter=False,
            # 重试耗尽后把错误写成 ToolMessage,让模型改口
            on_failure="continue",
        ),
    ],
    # 引导模型调用工具
    system_prompt="查订单必须调用 flaky_order。",
)

# 发起一次查询
result = agent.invoke({"messages": [{"role": "user", "content": "查一下 A1001"}]})

# 打印工具实际被调用的次数
print(f"工具被实际调用 {attempts['n']} 次")
# 计算相邻两次调用的时间差,验证退避是否生效
gaps = [round(stamps[i + 1] - stamps[i], 2) for i in range(len(stamps) - 1)]
print(f"两次尝试之间的间隔(秒): {gaps}")
# 打印最终回答
print(f"最终回答: {result['messages'][-1].content}")
输出:
工具被实际调用 3 次
两次尝试之间的间隔(秒): [0.5, 1.0]
最终回答: 订单 **A1001** 当前状态:**运输中**(第 3 次尝试成功获取)。
间隔 [0.5, 1.0] 与公式一致(0.5 × 2⁰ = 0.5,0.5 × 2¹ = 1.0)。整个重试过程对模型是透明的——轨迹里只有一条成功的 ToolMessage,模型不知道底层试了三次。
4.3. on_failure:重试耗尽之后怎么办 #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 从 middleware 导入模型重试中间件
from langchain.agents.middleware import ToolRetryMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 工具:无论调用多少次都抛出超时异常
@tool
def search_order(order_id: str) -> str:
    """查询订单信息"""
    raise TimeoutError("连接下游超时.")


agent = create_agent(
    model="deepseek-v4-flash",  # 修改为 deepseek-v4-flash
    tools=[search_order],
    # 只挂模型重试中间件,失败 3 次不再重试
    middleware=[
        ToolRetryMiddleware(
            max_retries=3, tools=["search_order"], on_failure="continue"
        )
    ],
)
# 调用 agent,试图查单
messages = [{"role": "user", "content": "查订单 A1001"}]
try:
    r = agent.invoke({"messages": messages})
    # 打印节点对话内容
    for i, msg in enumerate(r["messages"]):
        content = getattr(msg, "content", "")
        msg_type = type(msg).__name__
        print(f"[{i}] {msg_type}: {repr(content)}")
except Exception as e:
    print(f"Agent 执行时抛出异常: {type(e).__name__}: {e}")
[0] HumanMessage: '查订单 A1001'
[1] AIMessage: ''
[2] ToolMessage: "Tool 'search_order' failed after 4 attempts with TimeoutError: 连接下游超时.. Please try again."
[3] AIMessage: '抱歉,查询订单 A1001 时遇到了超时问题(连接下游服务超时),暂时无法获取订单信息。\n\n建议您可以:\n- **稍后重试**:可能是系统暂时繁忙,过一会儿再试一次\n- **确认订单号**:确保订单号无误\n\n需要我现在再帮您重试一次查询吗?'框架把异常转成了一条模型能读懂的 ToolMessage,注意结尾那句 Please try again. 是框架加的引导语。模型据此给出了得体的解释,对话没有中断。
换成 on_failure="error":
agent = create_agent(
    model="deepseek-v4-flash",  # 修改为 deepseek-v4-flash
    tools=[search_order],
    # 只挂模型重试中间件,失败 3 次不再重试
    middleware=[
        ToolRetryMiddleware(max_retries=3, tools=["search_order"], on_failure="error")
    ],
)
Agent 执行时抛出异常: TimeoutError: 连接下游超时.invoke() 直接抛出原始异常(不是包装过的),整个 Agent 停止。
| 值 | 行为 | 更适合 |
|---|---|---|
"continue"(默认) |
失败写成模型可读观察,对话可继续 | 查单、搜索等可降级场景 |
"error" |
抛出原始异常,Agent 停 | 本地调试、或失败必须硬停的流水线 |
4.4. retry_on:别让不该重试的异常也白等 #
默认值是 (Exception,)——几乎所有异常都会被重试。§4.1 那个 401 的例子就是后果:认证失败重试三次注定还是失败,只是把错误延后 1.5 秒返回。参数校验错误(ValueError)、权限错误(403)同理。
正确做法是收窄到「重试才有意义」的异常类型:
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 从 middleware 导入模型重试中间件
from langchain.agents.middleware import ToolRetryMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 工具:无论调用多少次都抛出 ValueError
@tool
def value_error_tool(order_id: str) -> str:
    """查询订单信息"""
    print("value_error_tool")
    raise ValueError("参数不合法(不该重试)")


agent = create_agent(
    model="deepseek-v4-flash",  # 修改为 deepseek-v4-flash
    tools=[value_error_tool],
    middleware=[
        # 只对超时类异常重试;ValueError 不重试
        ToolRetryMiddleware(
            max_retries=3,
            tools=["value_error_tool"],
            retry_on=(TimeoutError,),
            initial_delay=0.1,
            jitter=False,
        )
    ],
)

# 工具被调用 1 次,抛出 ValueError:参数不合法(不该重试)
try:
    agent.invoke({"messages": [{"role": "user", "content": "查订单 A1001"}]})
except Exception as e:
    print(f"工具被调用 1 次,抛出 {type(e).__name__}: {e}")
实测一个抛 ValueError 的工具,配上面这个策略:
工具被调用 1 次,抛出 ValueError: 参数不合法(不该重试)调用了 1 次就停,没有白等。
但请留意:被 retry_on 排除的异常是直接向上抛出的,会让 invoke() 崩掉。所以收窄 retry_on 之后,通常还需要一层错误兜底来接住这些异常——可以用第 8 章的 @wrap_tool_call,也可以用内置的 ToolErrorMiddleware:
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 从 middleware 导入模型重试中间件
from langchain.agents.middleware import ToolRetryMiddleware, ToolErrorMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 工具:无论调用多少次都抛出 ValueError
@tool
def value_error_tool(order_id: str) -> str:
    """查询订单信息"""
    print("value_error_tool")
    raise ValueError("参数不合法(不该重试)")


# on_error 可以是一段字符串,也可以是接收异常并返回文案的函数
error_guard = ToolErrorMiddleware(
    # 把任何未被重试消化的异常,转成给模型看的说明
    on_error=lambda exc, request: f"工具执行失败:{type(exc).__name__}。请向用户说明并建议稍后再试。",
    # 只对这些工具兜底
    tools=["value_error_tool"],
)
agent = create_agent(
    model="deepseek-v4-flash",  # 修改为 deepseek-v4-flash
    tools=[value_error_tool],
    middleware=[
        error_guard,
        # 只对超时类异常重试;ValueError 不重试
        ToolRetryMiddleware(
            max_retries=3,
            tools=["value_error_tool"],
            retry_on=(TimeoutError,),
            initial_delay=0.1,
            jitter=False,
        ),
    ],
)

# 工具被调用 1 次,抛出 ValueError:参数不合法(不该重试)
try:
    result = agent.invoke({"messages": [{"role": "user", "content": "查订单 A1001"}]})
    # 打印节点对话内容
    for i, msg in enumerate(result["messages"]):
        content = getattr(msg, "content", "")
        msg_type = type(msg).__name__
        print(f"[{i}] {msg_type}: {repr(content)}")
except Exception as e:
    print(f"工具被调用 1 次,抛出 {type(e).__name__}: {e}")
注意:工具里 return "错误:..." 不是异常。 那是成功返回一个字符串,Retry 完全不会介入。实测给一个返回错误字符串的工具配 max_retries=3:
工具被调用 1 次一次就结束。Retry 管的只有 raise 出来的失败。
这也再次印证 §2 的分工表:业务上「查无此单」应该 return 说明,交给模型改口;只有基础设施抖动才交给 Retry。
5. 限流:别让 Agent 烧干预算 #
限流解决的是死循环、过度工具调用、单次对话成本失控。
「限流」在内置中间件里对应:模型调用上限 + 工具调用上限。
先分清两层「限流」,避免和运维概念混淆:
| 层 | 谁做 | 例子 |
|---|---|---|
| Agent 中间件(本章) | LangChain middleware | 本轮最多调模型 8 次 |
| 基础设施 | API 网关 / 云厂商配额 | 每分钟 100 QPS |
本章只解决前者。Agent 一旦陷入「调工具 → 不满意 → 再调」的循环,没有 run_limit 时,单次对话的模型与工具调用次数会失控,费用和延迟都会快速上升。
两个维度也要分清:
| 维度 | 含义 | 典型用途 |
|---|---|---|
run_limit |
一次 invoke(一轮用户请求)内的上限 |
防单轮死循环(最常用) |
thread_limit |
同一 thread_id 跨多次 invoke 累计 | 防整段会话刷爆(需 checkpointer) |
5.1. checkpointer 与 InMemorySaver #
run_limit 只盯当前这一次 invoke,Agent 内部就能计数,不必配 checkpointer。thread_limit 要统计同一条会话线里、跨多次 invoke 的累计调用——中间可能隔了用户好几轮提问,计数器不能随进程内存随便丢。这就需要 checkpointer(检查点存储):
| 概念 | 作用 |
|---|---|
checkpointer |
按 thread_id 读写 Agent 状态(含 messages、中间件累计计数等) |
thread_id |
会话线程标识;同一 id 的多次 invoke 视为同一段对话 |
InMemorySaver() |
checkpointer 的内存实现:数据存在当前 Python 进程里 |
三者关系可以记成:
create_agent(..., checkpointer=InMemorySaver())
        │
        ▼
每次 invoke(..., config={"configurable": {"thread_id": "某会话"}})
        │
        ▼
Limit 中间件在该 thread 上累计 model/tool 调用次数
        │
        ▼
触顶 → exit_behavior="end" 或 "error"
为什么示例里要写 checkpointer=InMemorySaver()?
thread_limit依赖持久化的 thread 状态——没有 checkpointer,跨轮累计无从谈起,设了thread_limit也起不到预期作用。InMemorySaver是最小可跑方案——从langgraph.checkpoint.memory导入,零外部依赖,本地立刻能测限流。- 必须与
thread_id成对出现——配了 checkpointer 却不传thread_id,不是「落到默认线程」,而是直接报错:
ValueError: Checkpointer requires one or more of the following 'configurable' keys:
thread_id, checkpoint_ns, checkpoint_id
反过来,只传 thread_id 却不配 checkpointer,则不会报错,但 thread_limit 无处累计,等于白设。
| 场景 | 要不要 checkpointer | 推荐实现 |
|---|---|---|
只设 run_limit |
否 | — |
设 thread_limit |
是 | InMemorySaver();上线:Postgres 等(第 11 章) |
| HITL 暂停 / 恢复(§7) | 是 | 同上——暂停期间状态必须能存住 |
InMemorySaver 的局限要心里有数:进程重启即丢、不能多实例共享。
生产限流 + 多轮 + HITL 应换持久 checkpointer;本章与 §7、§8 的组合示例为可读性仍用内存,当作「本地调试模板」即可。
对 HITL 尤其要紧——进程一重启,所有等待审批的动作都会消失。
与前面章节的衔接:第 4 章 §5.2 已从「多轮记忆」角度预览过 checkpointer;这里从 限流累计 角度再碰一次——同一套机制,不同 middleware 都会用到。完整选型见第 11 章。
5.2. ModelCallLimitMiddleware #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入模型调用限额中间件
from langchain.agents.middleware import ModelCallLimitMiddleware
# InMemorySaver 是最简单的 checkpointer 实现
from langgraph.checkpoint.memory import InMemorySaver
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 一个最简单的回声工具
@tool
def ping(x: str) -> str:
    """回声工具。"""
    # 原样返回
    return x


# 创建带模型限额的 Agent
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 工具列表
    tools=[ping],
    # thread_limit 跨多次 invoke 累计,需要 checkpointer + thread_id
    checkpointer=InMemorySaver(),
    # 配置限额
    middleware=[
        ModelCallLimitMiddleware(
            # 同一 thread 累计最多调模型多少次
            thread_limit=20,
            # 单次 invoke(一轮用户请求)最多多少次
            run_limit=8,
            # 触顶:end=图正常收尾但末条消息是英文提示(见 §5.3);error=抛异常
            exit_behavior="end",
        ),
    ],
)

# 调用时必须带 thread_id,否则有 checkpointer 会直接报错
result = agent.invoke(
    # 消息字典
    {"messages": [{"role": "user", "content": "打个招呼"}]},
    # thread_id 标识这是哪一条会话线
    config={"configurable": {"thread_id": "limit-demo"}},
)
# 打印最终回答
print(result["messages"][-1].content)| 参数 | 默认值 | 含义 |
|---|---|---|
thread_limit |
None |
同一 thread 跨轮累计上限(需 checkpointer) |
run_limit |
None |
单次 invoke 内模型调用上限(防单轮死循环) |
exit_behavior |
"end" |
"end" 优雅收尾 / "error" 直接抛错 |
只关心单轮时,可以只设 run_limit,不必上 checkpointer(见上文对照)。
上了 thread_limit 却忘了 checkpointer + thread_id 任一侧,累计语义都会对不上——这是本章限流最常见的坑。
5.3. 触顶时到底发生什么:end 并不「优雅」 #
「优雅结束」这个说法容易让人掉以轻心。把 run_limit 调到 1 实测一下就清楚:
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入模型调用限额中间件
from langchain.agents.middleware import ModelCallLimitMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载环境变量
load_dotenv(override=True)


# 一个会被模型调用的工具,用来凑出「第二次模型调用」
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    # 返回模拟天气
    return f"{city} 晴,25°C。"


# 把上限压到 1 次模型调用,必然触顶
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个工具
    tools=[get_weather],
    # 配置模型限额
    middleware=[
        # run_limit=1 意味着只允许调一次模型
        ModelCallLimitMiddleware(run_limit=1, exit_behavior="end")
    ],
    # 引导模型调用工具,制造第二次模型调用
    system_prompt="查天气必须调用 get_weather。",
)

# 这个问题需要「调模型→调工具→再调模型」,第二次会被拦
res = agent.invoke({"messages": [{"role": "user", "content": "北京天气怎么样?"}]})

# 逐条打印轨迹,看触顶时留下了什么
for i, m in enumerate(res["messages"]):
    # 打印序号、消息类型与内容
    print(f"[{i}] {type(m).__name__}: {str(getattr(m, 'content', ''))!r}")
输出:
[0] HumanMessage: '北京天气怎么样?'
[1] AIMessage: ''
[2] ToolMessage: '北京 晴,25°C。'
[3] AIMessage: 'Model call limits exceeded: run limit (1/1)'
注意最后一条。 图确实「优雅」地停下来了(没抛异常、状态完整),但最终那条 AIMessage 的内容是一句英文框架内部提示。如果你直接把 result["messages"][-1].content 渲染给用户,他看到的就是 Model call limits exceeded: run limit (1/1)。
所以 exit_behavior="end" 的正确用法是:你必须自己识别这种收尾并替换文案。比如:
# 承接上面的 res

# 取出最后一条消息的文本
last = str(res["messages"][-1].content)

# 框架触顶时会以这句英文开头,据此判断是否被限流截断
if last.startswith("Model call limits exceeded"):
    # 换成对用户友好的中文说明
    print("这个问题比较复杂,我暂时没能处理完。可以拆成几个小问题再问我一次吗?")
else:
    # 正常回答直接展示
    print(last)
换成 exit_behavior="error" 则是抛出一个专门的异常,反而更容易在代码里处理:
ModelCallLimitExceededError: Model call limits exceeded: run limit (1/1)exit_behavior |
行为 | 你需要做什么 |
|---|---|---|
"end"(默认) |
图正常收尾,末条 AIMessage 是英文内部提示 |
必须检测并替换文案,否则用户看到内部信息 |
"error" |
抛 ModelCallLimitExceededError |
用 try/except 兜住,返回自定义提示 |
面向用户的服务,"error" + try/except 往往更好控制;"end" 更适合批处理场景(至少能拿到部分状态)。
5.4. ToolCallLimitMiddleware #
模型限额管「脑子转几圈」;工具限额管「手脚动几下」。
搜索、爬虫、计费 API 往往更需要按工具名单独收紧。
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入工具调用限额中间件
from langchain.agents.middleware import ToolCallLimitMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 假设这是一个按次计费的贵工具
@tool
def search_docs(query: str) -> str:
    """搜索内部文档(模拟;真实场景可能按次计费)。"""
    # 返回模拟结果
    return f"与「{query}」相关的 3 条结果。"


# 一个便宜的只读工具
@tool
def lookup_policy(topic: str) -> str:
    """查询制度。"""
    # 返回模拟制度
    return "请假需提前申请。"


# 创建 Agent,同时挂全局限额和单工具限额
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 两个工具
    tools=[search_docs, lookup_policy],
    # 两个限额实例能共存,因为 name 不同(见 §3.1)
    middleware=[
        # 全局:单轮最多 10 次工具调用
        ToolCallLimitMiddleware(run_limit=10),
        # 针对贵工具:单轮最多搜 3 次
        ToolCallLimitMiddleware(tool_name="search_docs", run_limit=3),
    ],
    # 提示里也加一层软约束,减少无意义重复
    system_prompt="搜文档用 search_docs;问制度用 lookup_policy。不要无意义重复搜索。",
)

# 正常提问,不会触顶
result = agent.invoke(
    {"messages": [{"role": "user", "content": "报销制度要点?"}]}
)
# 打印最终回答
print(result["messages"][-1].content)
参数与模型限额几乎一致,多一个 tool_name:
| 参数 | 默认值 | 含义 |
|---|---|---|
tool_name |
None |
限定某个工具;None 表示所有工具共享这个额度 |
thread_limit |
None |
同一 thread 跨轮累计上限(需 checkpointer) |
run_limit |
None |
单次 invoke 内上限 |
exit_behavior |
"continue" |
注意默认值和模型限额不同 |
可以挂多个 ToolCallLimitMiddleware:一个全局,若干个 tool_name=...(原理见 §3.1,name 里带了工具名所以不冲突)。但两个都不带 tool_name 会报 AssertionError。
触顶时的行为比模型限额温和得多。 实测:限额 1 次,却问了两个城市的天气:
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 导入工具调用限额中间件
from langchain.agents.middleware import ToolCallLimitMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 一个会被模型调用的工具,用来凑出「第二次模型调用」
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    # 返回模拟天气
    return f"{city} 晴,25°C。"


# 单工具限额压到 1 次
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个工具
    tools=[get_weather],
    # 配置单工具限额
    middleware=[
        # 只允许 get_weather 被调用 1 次
        ToolCallLimitMiddleware(tool_name="get_weather", run_limit=1)
    ],
    # 故意引导模型为每个城市单独调用一次,制造 2 次调用
    system_prompt="查天气必须调用 get_weather,每个城市单独调用一次。",
)

# 一句话问两个城市
res = agent.invoke(
    # 输入需要两次工具调用
    {"messages": [{"role": "user", "content": "北京和上海的天气分别怎么样?"}]}
)

# 打印轨迹观察超额的那次被怎么处理了
for i, m in enumerate(res["messages"]):
    # 取出可能存在的工具调用意图
    tc = getattr(m, "tool_calls", None)
    # 打印消息类型与内容
    print(f"[{i}] {type(m).__name__}: {str(getattr(m, 'content', ''))[:70]!r}")
    # 有工具调用则逐个打印
    if tc:
        # 遍历本条消息里的所有调用
        for c in tc:
            # 打印工具名与参数
            print(f"     -> {c['name']}({c['args']})")
输出:
[0] HumanMessage: '北京和上海的天气分别怎么样?'
[1] AIMessage: ''
     -> get_weather({'city': '北京'})
     -> get_weather({'city': '上海'})
[2] ToolMessage: "Tool call limit exceeded. Do not call 'get_weather' again."
[3] ToolMessage: '北京 晴,25°C。'
[4] AIMessage: '北京的天气是:晴,25°C。☀️
                上海的天气查询没有成功返回结果(调用次数受限),暂时无法获取。
                你可以稍后再问我一次,我再帮你查上海的天气。'
三个观察:
- 模型一次并行发出了 2 个调用,其中 1 个被放行、1 个被拦。 超额的那个没有静默丢弃,而是回了一条
ToolMessage。 - 拦截文案是写给模型看的指令:
Do not call 'get_weather' again.——它在直接命令模型别再试了,避免模型反复重试撞墙。 - 模型的收尾很得体,如实说明了哪项没查到、为什么。这就是默认
exit_behavior="continue"的价值:对话降级但不崩,也不会像模型限额那样把英文内部提示当成最终回答。
贵 API / 写操作工具建议单独加更严的限额,并配合系统提示「不要无意义重复搜索」。
6. PII:敏感信息怎么处理 #
PII(Personally Identifiable Information)= 能识别到个人的信息:邮箱、信用卡号、IP 等。 对话里用户随手粘贴很常见;若不处理,轨迹、日志、LangSmith,甚至模型上下文里都会留下明文。
PII 中间件在做什么(直观理解):
用户原文(可能含邮箱/卡号)
        │
        ▼
PIIMiddleware(PII中间件)按类型检测 → redact(脱敏) / mask(遮罩) / hash(哈希) / block(拦截)
        │
        ▼
再进入模型 / 日志视角下的「相对干净」文本它降低的是「用户乱贴」与「轨迹留存」的风险,不能替代:密钥进 .env、最小权限、合规审计流程。
6.1. PIIMiddleware 基础 #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入 PII 处理中间件
from langchain.agents.middleware import PIIMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 一个只读工具
@tool
def lookup_policy(topic: str) -> str:
    """查询制度摘要。"""
    # 返回模拟制度
    return "咨询类问题请联系 HR 邮箱(制度原文不含个人邮箱)。"


# 创建 Agent 并挂上两种 PII 处理
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 工具列表
    tools=[lookup_policy],
    # 一种类型一个实例;两种类型 name 不同所以能共存
    middleware=[
        # 内置类型:email / credit_card / ip / mac_address / url
        PIIMiddleware("email", strategy="redact", apply_to_input=True),
        # 卡号用部分遮罩,保留后四位
        PIIMiddleware("credit_card", strategy="mask", apply_to_input=True),
    ],
    # 提示层再加一句软约束
    system_prompt="你是办公助手。不要主动索要银行卡号;问制度用 lookup_policy。",
)

# 输入里故意带上邮箱
result = agent.invoke(
    {
        # 消息列表
        "messages": [
            {
                # 角色为用户
                "role": "user",
                # 演示:输入里带邮箱;中间件会按策略改写后再进模型
                "content": "我的邮箱是 alice@example.com,报销流程是什么?",
            }
        ]
    }
)
# 打印最终回答
for i, msg in enumerate(result["messages"]):
    content = getattr(msg, "content", "")
    msg_type = type(msg).__name__
    print(f"[{i}] {msg_type}: {repr(content)}")
一种类型通常对应一个 PIIMiddleware(...) 实例;要管邮箱又管卡号,就挂两个(同一类型不能挂两个,见 §3.1)。
6.2. 四种策略的实测效果 #
光看「部分遮罩」「哈希」这些描述,很难判断该选哪个。下面用同一句输入跑一遍四种策略,输入是:
我的邮箱是 alice@example.com,卡号 4111 1111 1111 1111,IP 是 192.168.1.7,报销流程是什么?实测结果:
strategy |
改写后的样子 | 适用 |
|---|---|---|
redact |
我的邮箱是 [REDACTED_EMAIL],... |
默认推荐,最彻底 |
mask |
卡号 **** **** **** 1111 |
需保留尾号供用户确认时 |
hash |
我的邮箱是 <email_hash:ff8d9819>,... |
需要关联同一实体又不存明文 |
block |
抛出 PIIDetectionError |
高合规、不允许继续 |
三种类型一起挂时效果叠加:
我的邮箱是 [REDACTED_EMAIL],卡号 **** **** **** 1111,IP 是 [REDACTED_IP],报销流程是什么?两个容易踩的点:
第一,block 不是「拦下来返回一句提示」,而是直接抛异常。 实测报错:
PIIDetectionError: Detected 1 instance(s) of email in text contentinvoke() 会崩掉,所以用 block 必须自己接住:
# PIIDetectionError 需要从 middleware 模块导入
from langchain.agents.middleware import PIIDetectionError

user_text = "我的邮箱是 alice@example.com,卡号 4111 1111 1111 1111,IP 是 192.168.1.7,报销流程是什么?"
# 用 try/except 包住调用,把技术异常转成用户能懂的话
try:
    # 正常发起调用
    result = agent.invoke({"messages": [{"role": "user", "content": user_text}]})
    # 成功则打印回答
    print(result["messages"][-1].content)
# 捕获 PII 拦截异常
except PIIDetectionError as e:
    # 给用户一句友好提示,同时把细节记进日志而不是抛给前端
print("为保护隐私,请不要在对话中提供邮箱、银行卡号等个人信息。")第二,hash 的输出形如 <email_hash:ff8d9819>,同一个邮箱每次都得到同一个哈希。 这正是它的用途:你能在日志里看出「这两条记录是同一个人」,却拿不到原始邮箱。代价是它比 redact 多泄露一点信息(可被字典攻击反查常见邮箱)。
6.3. 作用范围,以及一个重要更正 #
| 参数 | 默认值 | 含义 |
|---|---|---|
apply_to_input |
True |
处理用户输入 |
apply_to_output |
False |
处理模型输出 |
apply_to_tool_results |
False |
处理工具返回 |
注意 apply_to_input 默认就是 True,所以 PIIMiddleware("email") 已经在处理输入了,示例里写出来只是为了显式表达意图。
更正一个容易误导的说法。 你可能听过「PII 只改模型看到的那一份请求,messages 里还是原文」。实测并非如此:
# ModelRequest 与 wrap_model_call 来自第 9 章介绍的自定义钩子
from langchain.agents.middleware import ModelRequest, PIIMiddleware, wrap_model_call


# 用一个观察器拦在模型调用前,看清模型真正收到的消息
@wrap_model_call
def spy(request: ModelRequest, handler):
    # 打印本次请求里的消息内容
    print("模型收到:", [str(m.content) for m in request.messages])
    # 交还控制权,让流程继续
    return handler(request)


# 挂上 PII 与观察器;PII 在前,所以它先改写再被 spy 看到
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个只读工具
    tools=[lookup_policy],
    # 顺序:先脱敏,后观察
    middleware=[PIIMiddleware("email", strategy="redact"), spy],
    # 简单提示
    system_prompt="你是办公助手。",
)

# 发起一次带邮箱的调用
res = agent.invoke(
    # 输入里含真实邮箱
    {"messages": [{"role": "user", "content": "我的邮箱是 alice@example.com,报销流程?"}]}
)
# 打印状态里的第一条消息,与模型收到的那份对比
print("状态首条:", repr(str(res["messages"][0].content)))
输出:
模型收到: ['我的邮箱是 [REDACTED_EMAIL],报销流程?']
状态首条: '我的邮箱是 [REDACTED_EMAIL],报销流程?'
两者完全一致——PII 把 Agent 状态本身也改写了。 用户的原始邮箱在 messages 里已经不存在了。
这是好事(轨迹、checkpoint、日志里都不会留明文),但有两个后果要知道:
- 原文不可恢复。 如果业务上后续还需要那个邮箱,你必须在进 Agent 之前自己存一份,不能指望从
messages里捞回来。 - 工具也拿不到原文。 这直接引出了 §6.4 那个坑。
工具返回值里的 PII 同样能处理,需要显式开 apply_to_tool_results=True。实测对比一个会返回客户邮箱的工具:
不开启:       ToolMessage: '客户 C001 邮箱:vip@example.com,电话记录见系统。'
开启后:       ToolMessage: '客户 C001 邮箱:[REDACTED_EMAIL],电话记录见系统。'
6.4. 最大的坑:PII 和「需要这个 PII 的工具」互相冲突 #
这是本章最值得记住的一条:它不报错,只是让功能悄悄失效。
设想一个很自然的组合:办公助手既能发邮件,又对邮箱脱敏。
# 看起来很合理的两件事凑在一起
middleware=[
    # 保护隐私:把输入里的邮箱抹掉
    PIIMiddleware("email", strategy="redact", apply_to_input=True),
    # 业务能力:允许发邮件
    HumanInTheLoopMiddleware(interrupt_on={"send_email": {...}}),
]
用户说「给 team@example.com 发邮件,主题「值班提醒」」,实测发生了什么:
状态首条: '给 [REDACTED_EMAIL] 发邮件,主题「值班提醒」,正文写明天值班表已更新。'
待审 args: {"to": "[REDACTED_EMAIL]", "subject": "值班提醒", "body": "明天值班表已更新。"}
实际发信: [('[REDACTED_EMAIL]', '值班提醒')]
邮件被「发送」给了字符串 [REDACTED_EMAIL]。 而且整条链路没有任何异常:
- PII 中间件正常工作了
- 模型正常填参了(它看到的地址就是那个占位符)
- HITL 正常暂停了,审批界面上显示的收件人也是占位符
- 工具正常执行了,还返回了「已发送」
如果 send_email 背后接的是真实邮件服务,你会得到一堆投递失败;如果它写的是数据库,你会存进一批垃圾数据。审批环节也救不了你——人看到的就是脱敏后的地址,根本无从判断对不对。
根因不复杂:apply_to_input 改写的是状态,模型和工具看到的都是改写后的文本,脱敏后的信息不可能再还原成有效参数。
怎么办?先判断这个 PII 类型是不是「业务必需」:
| 情况 | 做法 |
|---|---|
| 工具需要这类 PII 才能工作(发信要邮箱、退款要卡号) | 不能对输入脱敏。 保护手段换成:工具侧做白名单校验、HITL 人审、日志层单独脱敏 |
| 工具不需要,只是用户随手贴的 | 放心 apply_to_input 脱敏 |
| 只担心 PII 被模型复述出去 | 用 apply_to_output=True,输入保持原样 |
| 只担心下游系统回传的 PII 进日志 | 用 apply_to_tool_results=True |
所以本章 §8 的实战里,发信 Agent 只对 credit_card 脱敏,不对 email 脱敏——没有工具需要卡号,邮箱却是 send_email 的命脉。改成这样之后实测:
状态首条: '给 team@example.com 发邮件,主题「值班提醒」,正文写明天值班表已更新。'
待审 args: {"to": "team@example.com", "subject": "值班提醒", "body": "明天值班表已更新。"}
实际发信: [('team@example.com', '值班提醒')]
同时卡号仍然被挡住:
状态首条: '我的卡号是 **** **** **** 1111,顺便查下订单 A1001。'一条通用经验:
上 PII 之前,先列一遍工具的参数表,看有没有哪个参数正好是你要脱敏的类型。
6.5. 自定义检测器 #
内置只有 email / credit_card / ip / mac_address / url 五种。要管公司内部的工号、合同号、身份证号,就得自己写 detector。
从源码签名可以看到它接受的类型:
detector: Callable[[str], list[PIIMatch]] | str | None = None也就是只有两种能传:正则字符串,或者可调用对象。
6.5.1 正则字符串 #
# 从 re 导入正则模块
import re

# 从 langchain.agents.middleware 导入 PII 中间件
from langchain.agents.middleware import PIIMiddleware
from langchain.agents import create_agent
from langchain.tools import tool
from dotenv import load_dotenv

load_dotenv(override=True)


@tool
def lookup_policy(name: str) -> str:
    """查找策略。"""
    return f"策略 {name} 的描述。"


# 写法一:直接给正则字符串,最省事
guard_a = PIIMiddleware(
    # 自定义类型名,会出现在占位符里([REDACTED_STAFF_ID])
    "staff_id",
    # 传字符串,由框架自己编译
    detector=r"\bE\d{6}\b",
    # 替换成占位符
    strategy="redact",
)

# 挂上 PII 与观察器;PII 在前,所以它先改写再被 spy 看到
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个只读工具
    tools=[lookup_policy],
    # 顺序:先脱敏,后观察
    middleware=[guard_a],
    # 简单提示
    system_prompt="你是办公助手。",
)

# 发起一次带邮箱的调用
res = agent.invoke(
    # 输入里含真实邮箱
    {"messages": [{"role": "user", "content": "我是 E123456,报销流程是什么?"}]}
)
# 打印状态里的第一条消息,与模型收到的那份对比
print("状态首条:", repr(str(res["messages"][0].content)))
得到:
我是 [REDACTED_STAFF_ID],报销流程是什么?占位符名字由你传的类型名决定:"staff_id" → [REDACTED_STAFF_ID]。
6.5.2 函数 #
什么时候值得用函数版?当规则不是纯正则能表达时,比如要校验身份证校验位、要排除白名单编号:
# 从 re 导入正则模块
import re

# 从 langchain.agents.middleware 导入 PII 中间件
from langchain.agents.middleware import PIIMiddleware
from langchain.agents import create_agent
from langchain.tools import tool
from dotenv import load_dotenv

load_dotenv(override=True)


@tool
def lookup_policy(name: str) -> str:
    """查找策略。"""
    return f"策略 {name} 的描述。"


# 写法二:包成函数,适合需要额外过滤逻辑时
# 预编译正则,避免每次调用重复编译
_STAFF_ID_PATTERN = re.compile(r"\bE\d{6}\b")


# 函数签名固定:接收文本,返回匹配列表
def detect_staff_id(content: str) -> list[dict]:
    """自定义 detector:返回 PIIMiddleware 可识别的 match 字典列表。"""
    # 每个匹配需要 text / start / end 三个键
    return [
        {"text": m.group(), "start": m.start(), "end": m.end()}
        # finditer 遍历所有匹配
        for m in _STAFF_ID_PATTERN.finditer(content)
    ]


# 把函数传进去
guard_b = PIIMiddleware("staff_id", detector=detect_staff_id, strategy="redact")

# 挂上 PII 与观察器;PII 在前,所以它先改写再被 spy 看到
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个只读工具
    tools=[lookup_policy],
    # 顺序:先脱敏,后观察
    middleware=[guard_b],
    # 简单提示
    system_prompt="你是办公助手。",
)

# 发起一次带邮箱的调用
res = agent.invoke(
    # 输入里含真实邮箱
    {"messages": [{"role": "user", "content": "我是 E123456,报销流程是什么?"}]}
)
# 打印状态里的第一条消息,与模型收到的那份对比
print("状态首条:", repr(str(res["messages"][0].content)))
自定义时注意误伤:正则太宽会把正常业务编号也抹掉(比如 \bE\d{6}\b 会命中订单号 E202401);太窄又会漏检。先在离线样本上跑 detector 统计命中率,再挂进 Agent。
PII 中间件是防护层,不能替代:最小权限、日志脱敏规范、密钥不进提示词。它显著降低「用户乱贴」带来的风险,但如 §6.4 所示,用错位置反而会破坏业务功能。
7. 人机协同(HITL) #
高风险工具(发邮件、转账、删数据、改权限)不能只靠系统提示「请谨慎」。HumanInTheLoopMiddleware 会在工具执行前打断,等人类 approve / edit / reject(或 respond)后再继续。
可以把它想成登机安检:
模型已经「想好」要发邮件(发出 tool_calls)
        │
        ▼
HITL:先别执行,把动作递给人类
        │
approve / edit / reject / respond
        │
        ▼
真正执行或回灌反馈,再继续对话
硬性前提(缺一不可):
- 配置
checkpointer(暂停期间要持久化状态,否则无法恢复) invoke时传thread_id(同一线程才能 resume)
这两条都成立,但失败时机不一样,而且都很隐蔽——§7.5 会用实测说明:忘了 checkpointer 时第一跳照常成功,忘了对齐 thread_id 时压根不报错。
只读工具务必 interrupt_on=False(或不列入打断策略),否则审批人会因「查个制度也要点批准」而关掉护栏。
HumanInTheLoopMiddleware 的参数只有两个,很好记:
| 参数 | 默认值 | 含义 |
|---|---|---|
interrupt_on |
必填 | 字典:工具名 → False(不拦)或配置字典(要拦) |
description_prefix |
"Tool execution requires approval" |
审批说明的前缀,建议改成中文 |
7.1. 决策类型 #
| 决策 | 含义 | 什么时候用 |
|---|---|---|
approve |
按模型原参数执行 | 草稿正确,放行 |
edit |
改工具名 / 参数后再执行 | 收件人写错,人改一下 |
reject |
不执行,把拒绝原因回给模型 | 明确否决副作用 |
respond |
人类直接充当工具结果 | ask_user 类占位工具 |
reject 与 respond 的区别值得用实测说清楚——选错了,模型会撒谎。同一次发信请求,分别用两种决策:
# reject,message="该收件人不在白名单,不允许发送"
ToolMessage: '该收件人不在白名单,不允许发送'
AIMessage:   '邮件未能发送成功。原因是:bob@example.com 不在发件白名单中...'
工具实际执行: []          ← 没发

# respond,message="邮件已由人工在系统外发送完毕"
ToolMessage: '邮件已由人工在系统外发送完毕'
AIMessage:   '邮件已发送给 bob@example.com,主题为「周会提醒」。'
工具实际执行: [] ← 也没发两种情况下工具都没有真的执行,但模型的反应截然不同:reject 让它如实说明失败,respond 让它相信「已经办好了」。
这就是为什么不能用 respond 去拒绝操作:respond 的语义是「工具的返回值由人来提供」,模型会把你的文字当成工具成功的结果。如果你用 respond 传「不允许发送」,模型很可能理解成「工具返回了一句话」,然后照样告诉用户邮件已发出。
否决副作用用
reject;把人当工具答案用respond。
7.2. 两跳调用:version 与 Command #
HITL 不是「一次 invoke 跑到底」,而是典型的两跳调用:
第一次 invoke(用户消息)     → 图跑到危险 tool_call 前 pause → 看 interrupts
第二次 invoke(Command(...)) → 带上人类决策 resume          → 继续执行到结束
要读懂 §7.3 的代码,先弄清下面两个参数各自管什么。
version="v2":不是必须,但更清晰 #
version 是 invoke 的一个真实参数,签名里写着 version: Literal['v1', 'v2'] = 'v1'。它决定返回值的形态:
默认(v1) |
version="v2" |
|
|---|---|---|
| 返回类型 | dict |
GraphOutput 包装对象(只有 interrupts 和 value 两个属性) |
| 正常结束 | result["messages"] |
result.value["messages"] |
| 被 HITL 打断 | 多出一个 "__interrupt__" 键 |
result.interrupts 非空 |
先更正一个说法:v1 并不是「无法判断有没有暂停」。 实测 v1 被打断时的返回值如下:
返回类型: dict, 键: ['messages', '__interrupt__']多出来的 __interrupt__ 键就是明确信号,用它照样能走完整个 HITL 流程(实测 v1 下 Command(resume=...) 也完全正常)。所以两种写法都可行:
# v1 写法:不传 version,返回值是普通 dict
result = agent.invoke({...}, config=config)
# "__interrupt__" 出现在键里,说明还在等人审
if "__interrupt__" in result:
    # 取出待审内容,结构与 v2 的 interrupts[0].value 相同
    print(result["__interrupt__"][0].value)
# 没有这个键说明已经跑完
else:
    # 直接从 messages 取最终回答
    print(result["messages"][-1].content)


# v2 写法:返回 GraphOutput 对象,语义更直白
result = agent.invoke({...}, config=config, version="v2")
# interrupts 非空说明还在等人审
if result.interrupts:
    # 属性访问,不需要记特殊键名
    print(result.interrupts[0].value)
# 为空说明正常结束
else:
    # 正常结束时状态在 .value 里
    print(result.value["messages"][-1].content)
推荐 v2 的理由是可读性:result.interrupts 比 "__interrupt__" in result 更直观,而且 GraphOutput 只有两个属性,不容易用错。本章后面统一用 v2。
不管用哪个版本,有一点相同:第一次调用命中审批时,不要指望 messages[-1] 是最终答复——那时图还停在工具执行前,最后一条是模型发出 tool_calls 的空 AIMessage。
interrupts[0].value 的完整结构:
{
  "action_requests": [
    {
      "name": "send_email",
      "args": {
        "to": "bob@example.com",
        "subject": "周会提醒"
      },
      "description": "工具执行待审批\n\nTool: send_email\nArgs: {'to': 'bob@example.com', 'subject': '周会提醒'}"
    }
  ],
  "review_configs": [
    {
      "action_name": "send_email",
      "allowed_decisions": ["approve", "edit", "reject", "respond"]
    }
  ]
}| 字段 | 含义 |
|---|---|
action_requests[].name |
待执行的工具名 |
action_requests[].args |
模型填好的参数(注意键名是 args,不是 arguments) |
action_requests[].description |
拼好的审批说明,前缀来自 description_prefix |
review_configs[].action_name |
对应的工具名 |
review_configs[].allowed_decisions |
这个动作允许哪些决策 |
做审批界面时,args 和 description 是你要展示给人看的内容,allowed_decisions 决定该给出哪几个按钮。
Command:第二次 invoke 传什么? #
Command 来自 langgraph.types,表示给 LangGraph 的控制指令,不是一条新的用户聊天消息。
# Command 从 langgraph.types 导入
from langgraph.types import Command

# 第二次调用:传控制指令而不是消息字典
final = agent.invoke(
    # resume 的内容是一个含 decisions 列表的字典
    Command(resume={"decisions": [{"type": "approve"}]}),
    # 必须与第一次相同的 thread_id
    config=config,
    # 保持与第一次一致的返回形态
    version="v2",
)| 要点 | 说明 |
|---|---|
Command(resume=...) |
从上次 interrupt 点恢复执行,而不是新开一轮对话 |
decisions |
人类决策列表;顺序必须与 action_requests 一一对应 |
同一 config |
thread_id 相同,checkpointer 才能把暂停前的状态接回来 |
不是 messages |
第二次不要传 {"messages": [...]},否则等于另起炉灶 |
decisions 里每条是一个 dict,至少含 "type":
type |
resume 里还要带什么 |
|---|---|
approve |
通常只要 {"type": "approve"} |
edit |
edited_action: {"name": "...", "args": {...}},args 必须完整 |
reject |
可选 message:拒绝原因,回灌给模型 |
respond |
message:人类直接充当工具返回值(见 §7.1) |
一次 interrupt 里若暂停了多个工具,就要给多条 decision,顺序不能乱:
# 两个待审动作 → 两条决策,按 action_requests 的顺序排
Command(
    resume={
        # 决策列表长度必须与 action_requests 一致
        "decisions": [
            # 第一个动作放行
            {"type": "approve"},
            # 第二个动作否决,并给出原因
            {"type": "reject", "message": "该 SQL 不允许执行"},
        ]
    }
)数量不匹配会明确报错——这是「响亮失败」,比较好查:
ValueError: Number of human decisions (0) does not match number of hanging tool calls (1).整体时序(与 §5 checkpointer 同一套机制):
checkpointer + thread_id(会话线固定)
        │
invoke(用户消息, version="v2")
        │
   interrupts 非空? ──否──► final.value["messages"] 即结果
        │
       是
        │
展示 action_requests 给人审
        │
invoke(Command(resume={decisions}), 同一 config, version="v2")
        │
继续执行工具 / 回灌拒绝 → 直到 final.value 或再次 interrupts
7.3. hitl_email.py #
下面示例用同一 thread_id 走完「打断 → 批准」两跳。读代码时对照 §7.2:version="v2"、paused.interrupts、Command(resume=...)。
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入人机协同中间件
from langchain.agents.middleware import HumanInTheLoopMiddleware
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# HITL 必须配 checkpointer,这里用最简单的内存实现
from langgraph.checkpoint.memory import InMemorySaver
# Command 用于第二跳恢复执行
from langgraph.types import Command
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 只读工具:不需要审批
@tool
def lookup_policy(topic: str) -> str:
    """查询制度(只读,可自动执行)。"""
    # 返回模拟制度
    return "对外发信需主管审批(模拟制度)。"


# 有副作用的工具:必须审批
@tool
def send_email(to: str, subject: str) -> str:
    """发送电子邮件(有副作用,需人工审批)。"""
    # 真实场景这里会调用邮件服务
    return f"已发送至 {to},主题:{subject}。"


# 创建 Agent
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个只读工具 + 一个危险工具
    tools=[lookup_policy, send_email],
    # 暂停期间的状态要存下来,否则无法 resume
    checkpointer=InMemorySaver(),
    # 挂上 HITL
    middleware=[
        HumanInTheLoopMiddleware(
            # 按工具名逐个声明是否需要打断
            interrupt_on={
                # 配置字典:打断,并声明允许哪些决策
                "send_email": {
                    "allowed_decisions": ["approve", "edit", "reject"],
                },
                # False:不打断,自动执行
                "lookup_policy": False,
            },
            # 审批说明的前缀,改成中文便于人审
            description_prefix="工具执行待审批",
        ),
    ],
    # 提示层强调不要假装发信
    system_prompt=(
        "你是办公助手。问制度用 lookup_policy;发邮件必须调用 send_email,不要假装已发送。"
    ),
)

# thread_id 固定这段会话,两跳必须用同一个
config = {"configurable": {"thread_id": "hitl-demo-1"}}

# 第一次:跑到 send_email 前会 pause
paused = agent.invoke(
    {
        # 用户请求发信
        "messages": [
            {
                "role": "user",
                "content": "给 bob@example.com 发一封主题为「周会提醒」的邮件。",
            }
        ]
    },
    # 带上 thread_id
    config=config,
    # 用 v2 形态,方便读 interrupts
    version="v2",
)

# interrupts 非空说明确实停在了工具执行前
print("是否打断:", bool(paused.interrupts))
# 打印待审内容,真实场景这里是渲染审批界面
if paused.interrupts:
    print("待审批:", paused.interrupts[0].value)

# 第二次:同一 thread_id,用 Command resume 批准
final = agent.invoke(
    # 一个待审动作对应一条决策
    Command(resume={"decisions": [{"type": "approve"}]}),
    # 必须是同一个 config
    config=config,
    # 保持 v2
    version="v2",
)

# v2 正常结束时看 .value;若仍打断则继续有 .interrupts
payload = final.value if hasattr(final, "value") else final
# 取出消息列表
messages = payload["messages"]
# 打印最终回复
print("最终回复:", messages[-1].content)
真实运行结果:
是否打断: True
待审批: {'action_requests': [{'name': 'send_email', 'args': {'to': 'bob@example.com',
         'subject': '周会提醒'}, 'description': "工具执行待审批\n\nTool: send_email\n
         Args: {'to': 'bob@example.com', 'subject': '周会提醒'}"}],
         'review_configs': [{'action_name': 'send_email',
         'allowed_decisions': ['approve', 'edit', 'reject']}]}
最终回复: 邮件已发送至 bob@example.com,主题为「周会提醒」。如果需要补充正文内容或调整收件人,请告诉我。
批准后的完整轨迹:
[0] HumanMessage: '给 bob@example.com 发一封主题为「周会提醒」的邮件。'
[1] AIMessage:    ''                                    ← 发出 tool_calls 的那条,content 为空
[2] ToolMessage:  '已发送至 bob@example.com,主题:周会提醒。'
[3] AIMessage:    '邮件已发送至 bob@example.com...'
流程记忆(细节见 §7.2):
invoke(..., version="v2") → 命中危险工具 → result.interrupts 非空(暂停)
        │
人类审阅 action_requests(interrupts[0].value)
        │
invoke(Command(resume={"decisions":[...]}), 同一 thread_id, version="v2")
        │
继续执行 / 回灌拒绝原因 → final.value["messages"] 或再次 interrupts
若第二次仍返回 interrupts,说明还有未审动作或再次触发了 HITL——后者比你想象的常见,下一节专门讲。
7.4. edit 的两个陷阱 #
edit 看起来最实用(「收件人写错了,我改一下」),实际上是四种决策里最容易出意外的。
7.4.1 陷阱一:args 必须写完整,不是打补丁 #
send_email(to, subject) 有两个必填参数。如果 edited_action.args 只给 to:
# 第二次:同一 thread_id
# 错误示范:只想改收件人,就只写了 to
command = Command(
    # resume 里放决策列表
    resume={
        # 一个待审动作对应一条决策
        "decisions": [
            {
                # 决策类型为编辑
                "type": "edit",
                # 被编辑后的动作
                "edited_action": {
                    # 工具名必须带上
                    "name": "send_email",
                    # 少了 subject,框架不会拿原值补上
                    "args": {"to": "dave@example.com"},
                },
            }
        ]
    }
)

final = agent.invoke(
    # 一个待审动作对应一条决策
    command,
    # 必须是同一个 config
    config=config,
    # 保持 v2
    version="v2",
)
# v2 正常结束时看 .value;若仍打断则继续有 .interrupts
payload = final.value if hasattr(final, "value") else final
# 取出消息列表
messages = payload["messages"]
# 打印最终回复
print("最终回复:", messages[-1].content)实测结果:工具没有执行,图又回到了打断状态。 args 是整体替换,不是增量合并。正确写法是把原参数取出来改一处、其余照抄:
# 从第一跳的 interrupts 里取出模型原本填的参数
original_args = paused.interrupts[0].value["action_requests"][0]["args"]

# 基于原参数复制一份再改,保证字段完整(** 展开原字典,后面的键覆盖同名项)
edited_args = {**original_args, "to": "dave@example.com"}
# 控制指令而非新消息
command = Command(
    # resume 里放决策列表
    resume={
        # 决策数量要与 action_requests 一致
        "decisions": [
            {
                # 决策类型为编辑
                "type": "edit",
                # name 也要带上;args 用上面拼好的完整参数
                "edited_action": {"name": "send_email", "args": edited_args},
            }
        ]
    }
)
final = agent.invoke(
    # 一个待审动作对应一条决策
    command,
    # 必须是同一个 config
    config=config,
    # 保持 v2
    version="v2",
)
# v2 正常结束时看 .value;若仍打断则继续有 .interrupts
payload = final.value if hasattr(final, "value") else final
# 取出消息列表
messages = payload["messages"]
# 打印最终回复
print("最终回复:", messages[-1].content)
7.4.2 陷阱二:改参可能与用户原意冲突 #
这个现象很典型。用户说「发给 bob@example.com」,审批时人把收件人改成了 `carol@example.com`。实测三跳的轨迹:
第 1 跳:interrupts → args = {'to': 'bob@example.com', 'subject': '周会提醒'}

第 2 跳:提交 edit,改成 carol@example.com
        工具实际执行: [('carol@example.com', '周会提醒(已修正)')]     ← 编辑生效了
        还有 interrupts 吗: True                                       ← 但又停住了!
        [2] ToolMessage: '已发送至 carol@example.com...'
        [3] AIMessage:   '抱歉,我刚才发送错了收件人和主题。我现在重新发送到正确的邮箱:'

第 3 跳:再次 approve
        工具执行: [('carol@example.com', ...), ('bob@example.com', '周会提醒')]  ← 发了两封!
        [5] AIMessage: '已发送邮件至 bob@example.com。之前误发到 carol@example.com 的邮件请忽略。'
编辑确实生效了,但模型看到 ToolMessage 里的地址和用户要求不符,自己判断「我发错了」,于是又发起了一次 send_email。 这次新调用又触发 HITL,所以出现了第二次打断。如果你无脑 approve,结果就是发出两封邮件。
这不是框架 bug,而是 Agent 自主性的正常表现——模型在努力完成用户的原始意图。但它意味着:
| 编辑类型 | 风险 |
|---|---|
修正明显笔误(`bob@exmaple.com→bob@example.com`) |
低,模型认为目标一致 |
| 补充模型漏填的可选参数 | 低 |
| 改成用户没提过的值(换收件人、改金额) | 高,模型可能反复尝试「纠正」 |
应对办法:
- 第二跳返回
interrupts时不要无脑 approve,先看action_requests是不是模型在重复上一个动作。 - 需要实质性改变意图时,用
reject+ 说明更安全——明确告诉模型「不允许发给这个地址」,让它停下来问用户,而不是偷偷替它改。 - 结合
ToolCallLimitMiddleware(tool_name="send_email", run_limit=1)兜底,物理上限制重复副作用。
7.5. HITL 的两个静默坑 #
前面说 checkpointer 和 thread_id「缺一不可」,但它们缺失时的表现完全不同。
7.5.1 坑一 #
忘了 checkpointer——第一跳会骗过你,第二跳才炸。
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 导入人机协同中间件
from langchain.agents.middleware import HumanInTheLoopMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# HITL 必须配 checkpointer,这里用最简单的内存实现
from langgraph.checkpoint.memory import InMemorySaver

# Command 用于第二跳恢复执行
from langgraph.types import Command

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


@tool
def send_email(to: str, subject: str) -> str:
    """发送邮件(模拟实现)"""
    print(f"模拟发信: {to=} {subject=}")
    return f"已发送至 {to},主题:{subject}。"


PAYLOAD = {
    "messages": [
        {
            "role": "user",
            "content": "给 test@example.com 发一封主题为「测试邮件」的邮件。",
        }
    ]
}
# 故意不传 checkpointer,模拟最常见的配置遗漏
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 只挂危险工具
    tools=[send_email],
    # HITL 照常配置
    middleware=[
        HumanInTheLoopMiddleware(
            # 声明发信需要审批
            interrupt_on={"send_email": {"allowed_decisions": ["approve"]}}
        )
    ],
    # 引导模型调用工具
    system_prompt="发邮件必须调用 send_email。",
    # 注意:这里没有 checkpointer=...
)

# 第一跳:正常返回 interrupts,看起来一切正常
r1 = agent.invoke(PAYLOAD, version="v2")
# 打印结果,你会看到 True,从而误以为配置没问题
print("第1跳 interrupts:", bool(r1.interrupts))
# 第二跳:这里才暴露问题
r2 = agent.invoke(Command(resume={"decisions": [{"type": "approve"}]}), version="v2")
实测:
第1跳 interrupts: True
RuntimeError: Cannot use Command(resume=...) without checkpointer第一跳完全正常——打断了、interrupts 里内容齐全,你会以为配好了。只有 resume 时才报错。如果你在写审批界面,别只测第一跳。好在错误信息很直白,看到就知道怎么修。
7.5.2 坑二 #
resume 时 thread_id 写错——完全不报错。
这个才是真正危险的。第一跳用 tid-A 打断,第二跳误用 tid-B 恢复:
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# 导入人机协同中间件
from langchain.agents.middleware import HumanInTheLoopMiddleware

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# HITL 必须配 checkpointer,这里用最简单的内存实现
from langgraph.checkpoint.memory import InMemorySaver

# Command 用于第二跳恢复执行
from langgraph.types import Command

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


@tool
def send_email(to: str, subject: str) -> str:
    """发送邮件(模拟实现)"""
    print(f"模拟发信: {to=} {subject=}")
    return f"已发送至 {to},主题:{subject}。"


PAYLOAD = {
    "messages": [
        {
            "role": "user",
            "content": "给 test@example.com 发一封主题为「测试邮件」的邮件。",
        }
    ]
}
# 正确的会话线
cfgA = {"configurable": {"thread_id": "tid-A"}}
# 错误的会话线(比如从请求里取错了字段、或前端传了新 id)
cfgB = {"configurable": {"thread_id": "tid-B"}}
# 故意不传 checkpointer,模拟最常见的配置遗漏
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 只挂危险工具
    tools=[send_email],
    # HITL 照常配置
    middleware=[
        HumanInTheLoopMiddleware(
            # 声明发信需要审批
            interrupt_on={"send_email": {"allowed_decisions": ["approve"]}}
        )
    ],
    # 引导模型调用工具
    system_prompt="发邮件必须调用 send_email。",
    checkpointer=InMemorySaver(),
)
# 第一跳:在 A 线程上打断,待审动作留在 A 上
agent.invoke(PAYLOAD, config=cfgA, version="v2")

# 第二跳:thread_id 写成了 B,B 上并没有待恢复的中断
result = agent.invoke(
    Command(resume={"decisions": [{"type": "approve"}]}), config=cfgB, version="v2"
)
print(result["messages"][-1].content)
实测:
换 thread_id 后:工具执行=[], interrupts=False
value.messages 条数: 1
  [0] AIMessage: '你好,我是办公助手。请问有什么可以帮您?如果需要发送邮件,请告诉我收件人、主题和内容...'
没有任何异常。 实际发生的是:tid-B 上没有待恢复的中断,于是 Command(resume=...) 被当作一次全新的空调用,模型收到一段没有用户消息的上下文,礼貌地打了个招呼。
后果非常隐蔽:
- 你的代码拿到了一个「成功」的响应,
interrupts是空的 - 从返回值看好像审批通过、流程走完了
- 但邮件永远没有发出去,
tid-A上那个中断还挂着,无人认领
这类 bug 在生产里极难发现,因为监控看到的是 200 成功。防御办法:
# 恢复之前,先确认这个 thread 上真的有待审动作
snapshot = agent.get_state(cfgB)

# next 非空说明图确实停在某个节点上等待恢复
if not snapshot.next:
    # 主动报错,而不是让它静默变成一次新对话
    raise RuntimeError(
        f"thread {cfgB['configurable']['thread_id']} 没有待恢复的中断,拒绝 resume"
    )

# 第二跳:thread_id 写成了 B,B 上并没有待恢复的中断
result = agent.invoke(
    Command(resume={"decisions": [{"type": "approve"}]}), config=cfgB, version="v2"
)
print(result["messages"][-1].content)
另外,有 checkpointer 但完全不传 thread_id 反而是响亮失败,容易发现:
ValueError: Checkpointer requires one or more of the following 'configurable' keys:
thread_id, checkpoint_ns, checkpoint_id
小结这三种情况:
| 配置错误 | 何时暴露 | 严重程度 |
|---|---|---|
| 没有 checkpointer | 第二跳 RuntimeError |
好查 |
完全不传 thread_id |
第一跳 ValueError |
好查 |
resume 时 thread_id 不匹配 |
不报错,静默变成新对话 | 危险,需主动校验 |
生产环境把 InMemorySaver 换成 Postgres 等持久 checkpointer(第 11 章)——否则进程一重启,所有待审批的动作全部丢失。
更多决策样例见 Human-in-the-loop。
8. 实战:带护栏的生产向 Agent #
把只读办公能力 + 危险发信 + 重试 / 限流 / PII / HITL 装进同一 Agent。 目标不是把所有中间件都开到最大,而是演示:按风险分级上护栏。
设计取舍:
| 能力 | 护栏 | 为什么 |
|---|---|---|
lookup_policy / lookup_order |
工具重试;HITL 关闭 | 只读,可自动;偶发下游失败值得重试 |
send_email |
HITL 必批;单独工具调用限额 | 有副作用,必须人审;防止连发 |
| 全对话 | 卡号 PII;模型与工具 run 限额 | 防泄露与防死循环 |
| 模型 / 工具瞬态错 | Model + Tool retry | 提升韧性 |
注意第三行只写了「卡号」,没有「邮箱」。 这不是漏配,而是 §6.4 那个冲突的直接结果:这个 Agent 的核心能力之一是发邮件,send_email(to=...) 需要真实地址。一旦对邮箱脱敏,邮件就会被发往字符串 [REDACTED_EMAIL],而且从代码到审批界面都看不出问题。
卡号则完全不同——三个工具里没有任何一个需要银行卡号,对它脱敏是纯收益。这就是「上 PII 前先对一遍工具参数表」的实际应用。
中间件列表按「先清洗与限流 → 再重试 → 最后 HITL」排列,便于阅读;你可按自己的观测结果微调。
8.1. guarded_office_agent.py #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 一次性导入本章用到的全部内置护栏中间件
from langchain.agents.middleware import (
    # 危险工具人工审批
    HumanInTheLoopMiddleware,
    # 模型调用限额
    ModelCallLimitMiddleware,
    # 模型调用重试
    ModelRetryMiddleware,
    # 敏感信息处理
    PIIMiddleware,
    # 工具调用限额
    ToolCallLimitMiddleware,
    # 工具调用重试
    ToolRetryMiddleware,
)
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# HITL 与 thread 累计限额都需要 checkpointer
from langgraph.checkpoint.memory import InMemorySaver
# Command 用于审批后恢复执行
from langgraph.types import Command
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 用字典模拟订单数据库
ORDERS = {
    # 订单号 -> 状态
    "A1001": "已发货",
    "A1002": "运输中",
}


# 只读工具一:查订单
@tool
def lookup_order(order_id: str) -> str:
    """按订单号查询状态。订单号形如 A1001。"""
    # 归一化输入,容忍空格与小写
    key = order_id.strip().upper()
    # 查表,查不到返回 None
    status = ORDERS.get(key)
    # 业务可知失败:返回字符串说明,不抛异常(不会触发 Retry)
    if not status:
        return f"错误:未找到订单 {order_id}。"
    # 正常返回状态
    return f"订单 {key} 状态:{status}。"


# 只读工具二:查制度
@tool
def lookup_policy(topic: str) -> str:
    """查询公司制度摘要。"""
    # 简单关键词匹配
    if "报销" in topic:
        return "差旅报销需在返程 7 日内提交。"
    # 未命中同样返回说明,并提示可用取值
    return "错误:未匹配制度。可尝试:报销。"


# 危险工具:有不可逆副作用
@tool
def send_email(to: str, subject: str, body: str) -> str:
    """发送工作邮件(有副作用,必须人工审批后才执行)。"""
    # 真实场景这里会调用邮件服务;正文只回摘要避免日志过长
    return f"已发送至 {to}|主题:{subject}|正文摘要:{body[:40]}。"


# 用函数封装构造过程,方便测试里反复创建
def build_guarded_agent():
    # 返回配置好全套护栏的 Agent
    return create_agent(
        # 模型标识
        model="deepseek:deepseek-v4-flash",
        # 两个只读工具 + 一个危险工具
        tools=[lookup_order, lookup_policy, send_email],
        # HITL 暂停需要持久化状态;生产请换 Postgres
        checkpointer=InMemorySaver(),
        # 顺序:先清洗与限流,再重试,最后 HITL
        middleware=[
            # 1) 输入侧 PII
            # 只 mask 卡号:没有任何工具需要卡号,脱敏是纯收益
            # 刻意不对 email 脱敏——send_email 需要真实地址,详见 §6.4
            PIIMiddleware("credit_card", strategy="mask", apply_to_input=True),
            # 2) 限流(单轮)
            # 模型最多调 10 次,防死循环
            ModelCallLimitMiddleware(run_limit=10, exit_behavior="end"),
            # 所有工具合计最多 12 次
            ToolCallLimitMiddleware(run_limit=12),
            # 发信单独收紧到 2 次,物理上防止重复副作用(见 §7.4)
            ToolCallLimitMiddleware(tool_name="send_email", run_limit=2),
            # 3) 重试
            # 模型偶发失败重试 2 次
            ModelRetryMiddleware(max_retries=2, initial_delay=0.5),
            # 只对两个只读工具重试;发信绝不自动重试,避免重复投递
            ToolRetryMiddleware(
                # 再试 2 次
                max_retries=2,
                # 白名单:不含 send_email
                tools=["lookup_order", "lookup_policy"],
                # 首次重试等 0.3 秒
                initial_delay=0.3,
                # 耗尽后转成 ToolMessage,让对话继续
                on_failure="continue",
            ),
            # 4) HITL:只拦发信
            HumanInTheLoopMiddleware(
                # 逐个工具声明策略
                interrupt_on={
                    # 危险工具:打断并允许三种决策
                    "send_email": {
                        "allowed_decisions": ["approve", "edit", "reject"],
                    },
                    # 只读工具明确不打断,避免人审疲劳
                    "lookup_order": False,
                    "lookup_policy": False,
                },
                # 中文前缀,审批界面更友好
                description_prefix="生产护栏:待审批",
            ),
        ],
        # 提示层约束:工具选择 + 禁止编造 + 禁止假装已发信
        system_prompt=(
            "你是带护栏的办公助手。"
            "查单用 lookup_order;制度用 lookup_policy;发信必须调用 send_email。"
            "禁止编造订单与制度;禁止声称已发信除非工具已执行。"
        ),
    )


# 作为脚本直接运行时演示两条路径
if __name__ == "__main__":
    # 构造 Agent
    agent = build_guarded_agent()
    # 只读路径用独立 thread,避免与发信状态缠在一起
    config = {"configurable": {"thread_id": "prod-guard-demo"}}

    # A. 只读路径:不应打断
    r1 = agent.invoke(
        # 一句话同时问订单和制度,观察并行工具调用
        {"messages": [{"role": "user", "content": "订单 A1001 到哪了?报销怎么走?"}]},
        # 带上 thread_id
        config=config,
        # v2 形态便于判断是否打断
        version="v2",
    )
    # 只读工具设了 False,这里出现打断就说明配错了
    if r1.interrupts:
        print("意外打断:", r1.interrupts)
    else:
        # 正常结束时从 .value 取状态
        print("只读回复:", r1.value["messages"][-1].content)

    # B. 发信路径:应打断 → 批准
    # 换一个 thread_id,让演示轨迹更干净
    config2 = {"configurable": {"thread_id": "prod-guard-mail"}}
    # 第一跳:跑到 send_email 前暂停
    paused = agent.invoke(
        {
            "messages": [
                {
                    "role": "user",
                    "content": "给 team@example.com 发邮件,主题「值班提醒」,正文写明天值班表已更新。",
                }
            ]
        },
        # 使用发信专用 thread
        config=config2,
        # 保持 v2
        version="v2",
    )
    # 这里应为 True
    print("发信打断:", bool(paused.interrupts))
    # 有待审动作则展示并批准
    if paused.interrupts:
        # 真实场景这里渲染审批界面
        print(paused.interrupts[0].value)
        # 第二跳:同一 thread_id 提交 approve
        done = agent.invoke(
            # 一个待审动作对应一条决策
            Command(resume={"decisions": [{"type": "approve"}]}),
            # 必须与第一跳一致
            config=config2,
            # 保持 v2
            version="v2",
        )
        # 批准后取最终回复
        print("批准后:", done.value["messages"][-1].content)
8.2. 真实运行结果 #
A. 只读路径——两个工具并行调用,全程无打断:
有打断: False
[0] HumanMessage: '订单 A1001 到哪了?报销怎么走?'
[1] AIMessage: '我来帮您查询订单状态和报销制度。'
     -> lookup_order({'order_id': 'A1001'})
     -> lookup_policy({'topic': '报销'})
[2] ToolMessage: '订单 A1001 状态:已发货。'
[3] ToolMessage: '差旅报销需在返程 7 日内提交。'
[4] AIMessage: '查询结果如下:
                📦 订单 A1001:状态为已发货
                💰 报销制度:差旅报销需在返程 7 日内提交。'
模型一次并行发出两个 tool_calls,因为两个只读工具都配了 False,没有任何审批摩擦。
B. 发信路径——正确保留了邮箱地址:
有打断: True
状态首条: '给 team@example.com 发邮件,主题「值班提醒」,正文写明天值班表已更新。'
待审 args: {"to": "team@example.com", "subject": "值班提醒", "body": "明天值班表已更新。"}
批准后仍打断: False
实际发信: [('team@example.com', '值班提醒')]
最终回复: '邮件已发送至 team@example.com,主题为「值班提醒」,正文为「明天值班表已更新。」'
对比 §6.4 那个错误版本(to 变成 [REDACTED_EMAIL]),差别就在于去掉了 email 的 PII 规则。
C. 卡号仍然被挡住——脱敏能力没有削弱:
状态首条: '我的卡号是 **** **** **** 1111,顺便查下订单 A1001。'D. 拒绝路径——reject 时模型如实说明,不会撒谎:
实际发信: []
最终回复: '邮件未能发送成功。
          系统提示:收件人 team@example.com 不在白名单中,禁止发送。
          因此我没有发出这封「值班提醒」邮件,也不会假装它已发出。
          如需继续,您可以:1. 提供一个在白名单内的收件人地址;2. 或确认是否更换其他处理方式。'
注意最后那句「也不会假装它已发出」——系统提示里那条约束起作用了。
8.3. 验收清单 #
- 查单 / 制度一次问完,无
interrupts - 发信出现
interrupts,approve后轨迹含工具成功结果 - 检查
action_requests里的to是真实邮箱而不是占位符——这是 §6.4 那个冲突的直接验收点 - 输入含卡号时被 mask 成
**** **** **** 1111 - 故意把
run_limit调极低,确认限流会提前结束而不是无限转,并确认你处理了Model call limits exceeded那句英文文案(§5.3) - 试一次
reject,确认模型没有谎称已发送 - 发信与只读用不同 thread_id 演示时更清晰,避免会话状态缠在一起不好读
version="v2" 下:看打断用 .interrupts,看正常结束状态用 .value。
9. 实用约定与坑 #
下面几条能避开大多数「护栏配了却不像护栏」的翻车,按「会不会静默出错」分成两类。
一、静默类:不报错,但护栏没起作用或把功能弄坏了
- PII 与需要该 PII 的工具互斥:给发信 Agent 装
PIIMiddleware("email"),邮件会发给字符串[REDACTED_EMAIL],全链路无异常(§6.4) - 上 PII 前先对一遍工具参数表:只脱敏「没有任何工具需要」的类型
- PII 会改写状态本身:原文在
messages里就没了,需要留档得在进 Agent 前自己存(§6.3) - resume 时
thread_id不匹配 = 静默开新对话:待审动作永远悬着,接口却返回成功。恢复前用get_state(config).next校验(§7.5) exit_behavior="end"会把英文内部提示当成回答:必须检测Model call limits exceeded并替换文案(§5.3)edit改成用户没提过的值,模型可能反复「纠正」:第二跳又出现interrupts时别无脑 approve(§7.4)
二、响亮类:会报错,知道错误信息就好查
retry_on默认是(Exception,):连 401 都会重试三遍白等;收窄后被排除的异常会直接抛出,需要ToolErrorMiddleware或@wrap_tool_call兜底(§4.3)- 重试只对瞬态错:业务「查无」用返回字符串,别靠无限重试碰运气
- 工具
return错误 ≠ 异常:Retry 只接住raise;字符串错误走业务回灌,实测只调用 1 次 max_retries=2是总共 3 次尝试:错误文案里用的是attempts- 同一种中间件挂两个会
AssertionError:靠name判重,ToolCallLimitMiddleware[工具名]、PIIMiddleware[类型]带维度所以能并存,不带维度的两个则不行(§3.1) - 同一 PII 类型不能配两种策略:
name相同会判重 thread_limit必须配 checkpointer +thread_id;只防单轮用run_limit即可- HITL 没有 checkpointer:第一跳正常,第二跳才
RuntimeError——别只测第一跳(§7.5) edit的args是整体替换:漏字段会导致工具不执行并重新打断(§7.4)decisions数量必须与action_requests一致:否则ValueErrorstrategy="block"是抛PIIDetectionError,不是返回提示,必须自己try/except(§6.2)
三、设计类:不报错也不算 bug,但会影响体验
- 只读工具
interrupt_on=False,避免人审疲劳 - 否决副作用用
reject,别用respond:后者会让模型以为工具成功了(§7.1 有实测对比) - 危险工具不要配自动重试:重试等于重复副作用
- PII 不能替代密钥管理:API Key 永远进
.env,不要进提示词 - middleware 顺序要可解释:PII / 限流靠前,HITL 对着执行侧
- 自定义钩子与内置护栏可并存:第 9 章动态提示/过滤 + 本章护栏
- 内存 checkpointer 仅 Demo:进程一重启,所有待审批动作全部丢失
口诀:
能自动重试的别人工盯;能限流的别靠自觉;能脱敏的别存明文;能审批的别直接放行。
再补一句本章特有的:
护栏之间会打架——装之前先问一句「这条规则会不会挡住我自己的工具」。
10. 练习 #
每题改完都对照「有没有打断 / 有没有重试意义 / 有没有超额」三类现象来验收,不要只看最后一句是否通顺。前四题是机制验证,做完你对护栏的边界会清楚很多。
- 复现 PII 冲突:给 §8 的实战加回
PIIMiddleware("email", strategy="redact"),走一次发信流程,打印action_requests里的to,亲眼看到[REDACTED_EMAIL]被当作收件人(§6.4)。 - 触顶文案:把
ModelCallLimitMiddleware的run_limit改成 1,打印messages[-1].content,确认用户会看到英文内部提示;然后写一段判断把它换成中文(§5.3)。 - thread_id 静默坑:第一跳用
tid-A打断,第二跳故意用tid-Bresume,确认没有任何异常且邮件没发出;再用get_state().next加上校验(§7.5)。 retry_on收窄:写一个抛ValueError的工具,对比retry_on=(Exception,)与retry_on=(TimeoutError,)两种配置下的调用次数(§4.3)。- 收紧发信:把
send_email的allowed_decisions改成只允许approve/reject,测一次reject并观察模型后续话术。 - 贵工具限流:给
lookup_order加ToolCallLimitMiddleware(tool_name=..., run_limit=1),一次提问要求查两个订单,看拦截文案怎么写给模型。 - PII block:对
credit_card使用strategy="block",输入带卡号的句子,用try/except PIIDetectionError接住并给出友好提示。 - HITL edit:在 resume 时用
edit把收件人改成另一个地址,观察模型是否会试图「纠正」你,以及一共发了几封(§7.4)。 - 叠第 9 章:给护栏 Agent 再加上按
role过滤工具(员工不能看到send_email),注意动态过滤与 HITL 的先后顺序。
11. 本章小结 #
- 生产向 Agent = 业务能力 + 护栏 middleware(重试、限流、PII、HITL)。
ModelRetry/ToolRetry对付瞬态失败;业务错误仍回灌说明。默认retry_on=(Exception,)太宽,生产要收窄并配错误兜底。ModelCallLimit/ToolCallLimit控制成本与死循环;thread_limit依赖 checkpointer。两者触顶行为不同:模型限额会留下英文内部提示,工具限额会给模型一条「别再调了」的指令。PIIMiddleware对输入(及可选输出/工具结果)做 redact/mask/hash/block,并且会改写状态本身;block是抛异常。HumanInTheLoopMiddleware在危险工具执行前暂停;version="v2"读GraphOutput.interrupts(v1 读__interrupt__键也可以),Command(resume=...)同thread_id恢复。四种决策里reject与respond语义完全不同,edit需要完整参数。- 靠
name判重决定同种中间件能否并存:带维度的([工具名]、[类型])可以,不带的会AssertionError。 - 护栏按风险分级:只读自动、副作用人审、贵调用单独限额。
- 护栏之间可能冲突,最典型的是 PII 与需要该 PII 的工具——本章实战因此刻意不对邮箱脱敏。
- 本章产出:带护栏的生产向办公 Agent(只读自动 + 发信审批)。
下一章:Memory 短期记忆与会话——线程、checkpoint、多轮上下文,做出带记忆的客服 Agent。