1. 扇出是什么 #
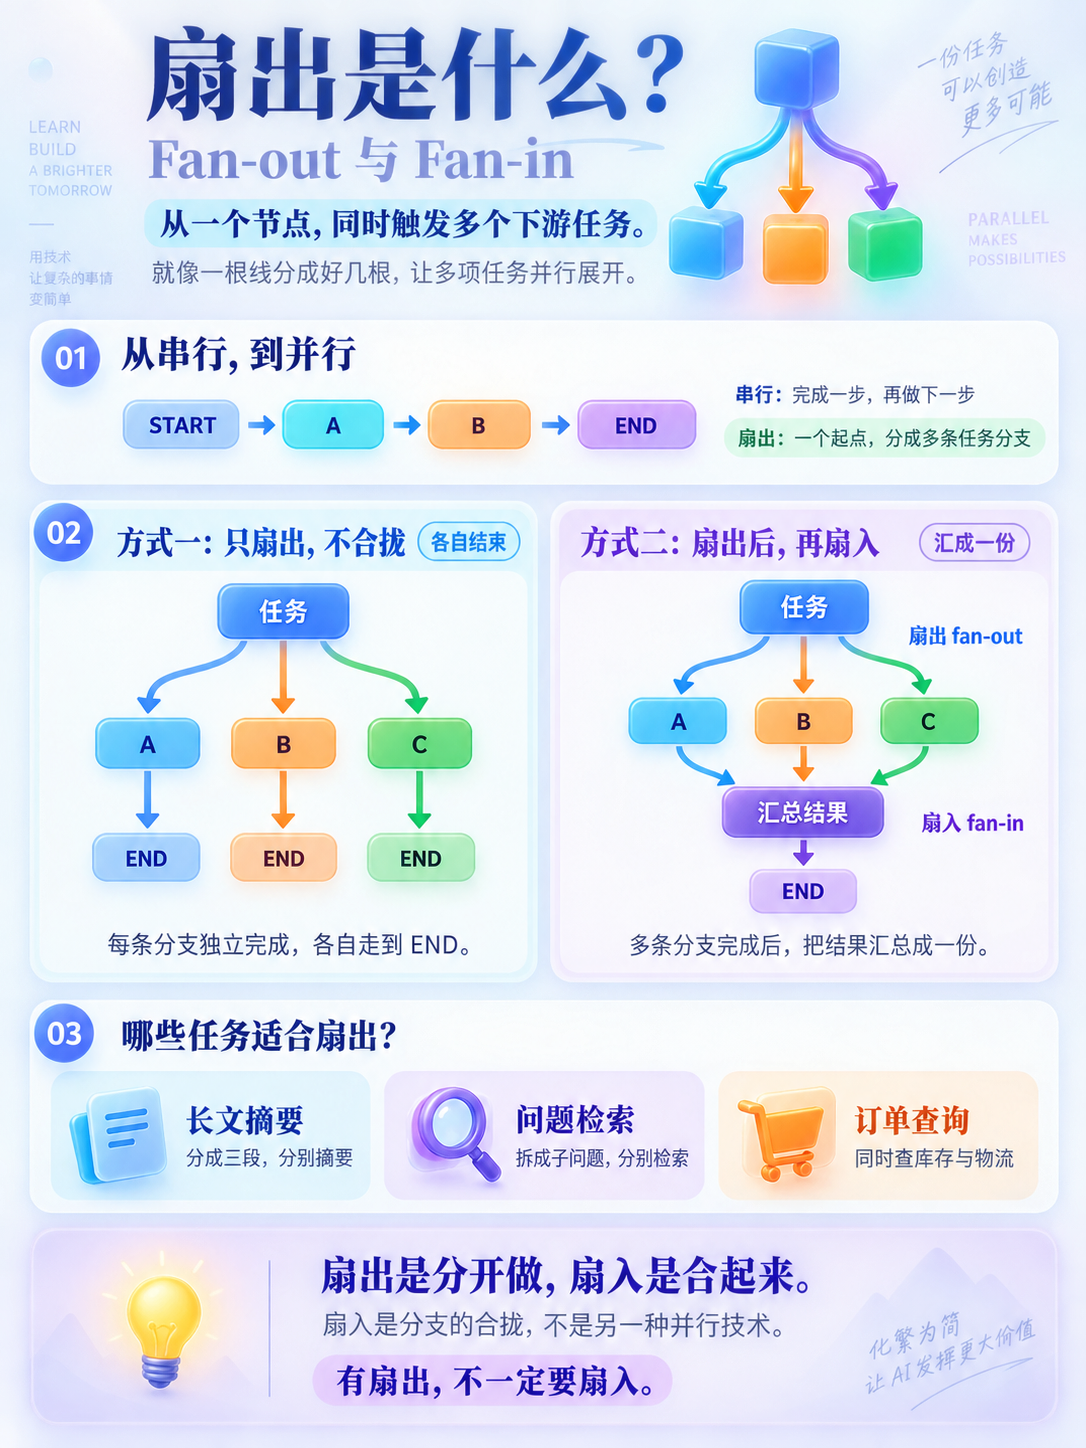
日常写图,最开始都是一条直线:START → A → B → END。真实任务却经常是「同一件事要同时干好几份」——一篇长文切成三段各自摘要、一个问题拆成三个子问题分别检索、一份订单同时去查库存和查物流。
这种「从一个节点同时触发多个下游」的结构,就叫扇出(fan-out)。名字来自电路:一根线分成好几根。
拆开之后,你有两种收场:
- 各干各的,每条线自己走到
END(只扇出、不合拢) - 几根线再并回一个节点,把结果收成一份(这后半步叫扇入 / fan-in)
所以扇入不是另一种并行技术,只是扇出的合拢。没有扇出,谈扇入没有意义;有扇出,却不一定非要扇入。
1.1. 你学完能做什么 #
学完你应该能亲手写出三种由易到难的扇出,并且说清它们各自解决什么问题:
- 静态扇出:分支写死在图上,
add_edge连两次就行 - 列表扇出:运行时才决定这次并行跑几个节点,但每个节点看到的仍是同一份状态
Send扇出:运行时既决定跑几个,又给每个工人一份不同的输入(map-reduce)
另外两件配套的事必须一起会:
- 并行节点写同一个字段时,怎么用 reducer 合并,而不是报错
- 怎么用
stream亲眼看到「它们属于同一个超步」
2. 前置知识 #
扇出本身只是「边怎么连」。真正卡住的,往往是三个配角:图怎么搭、什么叫同时、并行写入怎么合并。先把这三块补上,后面的扇出代码才读得懂。
2.1. 图的三件套:状态、节点、边 #
LangGraph 的核心概念只有三个:
| 概念 | 一句话 | 对应代码 |
|---|---|---|
| 状态 State | 一个字典,整张图运行期间所有节点共享它 | class Mini(TypedDict): ... |
| 节点 Node | 一个普通函数:读状态,返回要改的字段 | def greet(state) -> dict: ... |
| 边 Edge | 规定「这个节点跑完,下一个跑谁」 | builder.add_edge("a", "b") |
用一句话串起来:
图 = 一堆函数(节点) + 它们的执行顺序(边) + 它们之间传递的数据(状态)。
可以把它想成工厂流水线:节点是工位上的工人,边是传送带,状态是那个一路传下去的托盘。工人不直接把零件递给下一个人,而是放回托盘——所以后面要并行时,多个工人可以同时从托盘上取东西。
下面是一张最小的图:入口进 greet,它读到名字,写回一句问候,然后结束。
# TypedDict 用来声明「状态这个字典里有哪些键、各是什么类型」
from typing import TypedDict

# END 是终点哨兵,START 是入口哨兵,StateGraph 是图的构建器
from langgraph.graph import END, START, StateGraph


# 状态里只有一个字符串字段
class Mini(TypedDict):
    # 用户名,后面会被改写成问候语
    text: str


# 节点就是普通函数:参数是当前状态,返回「要改哪些字段」
def greet(state: Mini) -> dict:
    # 只返回要更新的部分,图会把它合并进完整状态
    return {"text": f"你好,{state['text']}"}


# 新建一张未编译的图,绑定状态类型
builder = StateGraph(Mini)
# 把 greet 函数注册成名叫 "greet" 的节点
builder.add_node("greet", greet)
# 入口:图一开始就跑 greet
builder.add_edge(START, "greet")
# greet 跑完就结束
builder.add_edge("greet", END)
# 编译成可以 invoke 的对象
graph = builder.compile()
# 传入初始状态,打印最终状态
print(graph.invoke({"text": "小明"}))
运行输出:
{'text': '你好,小明'}记住一件事就够:节点返回的是「增量」,不是完整状态。 greet 只返回 {"text": ...},图负责把它合并回去。扇出时多个节点各自返回增量,图再在同一步里把它们合在一起——这就是下一节 reducer 要管的事。
2.2. 超步:什么叫「同时跑」 #
LangGraph 不是「一个函数 return 了立刻跑下一个」。它按超步(superstep)往前推:
- 找出这一步该跑的所有节点
- 把它们都跑完(每个节点看到的都是这一步开始前的状态)
- 把所有返回值合并进状态
- 根据边决定下一步跑谁
所以「并行」在这里有一个非常具体的含义:
同一超步里的节点,彼此看不见对方刚刚写下的值。
这和「两个函数真的在两个 CPU 上同时跑」不是一回事。默认用普通 def 时,LangGraph 仍可能一个接一个调用它们,只是合并发生在全部跑完之后。想靠扇出缩短墙钟时间,节点得写成 async def,那是后话。这篇用同步函数,方便你用 print 看清结构。
怎么亲眼看见「同一超步」?用 stream_mode="debug",看每个任务的 step 编号。具体数字放到 §4.2 再跑。现在只要记住:
- 串行
A → B:A 是第 1 步,B 是第 2 步 - 扇出
A → B、A → C:A 是第 1 步,B 和 C 都是第 2 步
2.3. Reducer:并行写入怎么合成一份 #
节点返回增量之后,图要决定「新值和旧值怎么合」。默认规则是覆盖:后来的整份换掉原来的。
串行时覆盖往往看不出来问题——A 写完,B 再写,本来就有先后。并行时两个节点在同一超步里写同一个键,图不知道该听谁的,会直接抛 InvalidUpdateError。
解决办法是给这个字段挂一个 reducer:一个「旧值 + 新值 → 合并结果」的函数。列表最常用的是 operator.add,效果就是拼接:
旧值 ["start"] + 新值 ["天气好"] → ["start", "天气好"]写法是 Python 自带的 Annotated:在类型右边贴一张便签,便签上写合并规则。
# operator.add 对列表的含义是拼接,不是算术加法
import operator
# Annotated 用来给类型附加额外信息,这里附加的是 reducer
from typing import Annotated, TypedDict

# END / START / StateGraph 是搭图的三件套
from langgraph.graph import END, START, StateGraph


# 状态:一个会累加的日志字段
class S(TypedDict):
    # 挂了 operator.add:每个节点返回的列表都会被拼到后面
    log: Annotated[list[str], operator.add]


# 第一个节点往 log 里追加一条
def a(state: S) -> dict:
    # 返回单元素列表,reducer 负责拼到已有 log 后面
    return {"log": ["A 来过"]}


# 第二个节点也往 log 里追加一条
def b(state: S) -> dict:
    # 同样返回单元素列表
    return {"log": ["B 来过"]}


# 新建图
builder = StateGraph(S)
# 注册节点 a
builder.add_node("a", a)
# 注册节点 b
builder.add_node("b", b)
# 入口进 a
builder.add_edge(START, "a")
# a 跑完接着 b(这是串行,用来先看清 reducer 的效果)
builder.add_edge("a", "b")
# b 跑完结束
builder.add_edge("b", END)
# 编译
graph = builder.compile()
# 初始 log 是空列表,最终应看到两条
print(graph.invoke({"log": []}))
运行输出:
{'log': ['A 来过', 'B 来过']}如果这里不写 Annotated[..., operator.add],b 返回的 ["B 来过"] 会把 ["A 来过"] 整段盖掉,最后只剩 B。扇出时两个节点同时写,连盖掉的机会都没有,直接报错。并行写入的字段必须有 reducer,这是扇出能跑通的前提。
3. 扇出是什么 #
前置知识齐了,可以给「扇出」下定义了。
3.1. 一个生活里的类比 #
点外卖时,商家不会先炒完菜再去做饮料:后厨和饮品台同时开工,都好了才装袋给你。
- 扇出:订单进来,同时派给后厨和饮品台
- 扇入:两样都好了,在出餐口汇总装袋
对应到图上:
              ┌─ weather ─┐
START → start ┤           ├→ merge → END
              └─ news ────┘
start 是接单,weather 和 news 是两个同时干活的工位,merge 是出餐口。
3.2. 扇出、分支、扇入差在哪 #
这三个词很容易混,差在「下一步跑几个」以及「要不要再合回来」:
| 下一步跑几个 | 典型问法 | 怎么连边 | |
|---|---|---|---|
| 分支 | 只跑 1 个 | 「退货走 A,否则走 B」 | 条件边返回一个节点名 |
| 扇出 | 同时跑 N 个 | 「库存和物流一起查」 | 从同一点连出多条边,或返回一个列表 |
| 扇入 | N 个都跑完再跑 1 个 | 「两份结果收拢成一份报告」 | 多条边指向同一个下游节点 |
对照着记:
- 分支是「二选一」
- 扇出是「都要做」(1 变 N)
- 扇入是「都做完再收拢」(N 变 1)
扇入没有单独的函数。你只要写两次 add_edge("weather", "merge") 和 add_edge("news", "merge"),LangGraph 就会等两边都到齐再跑 merge。§4.1 是只扇出不合拢,§4.3 才把扇入接上。
3.3. 三种实现,由易到难 #
后面三节按这个顺序讲,建议不要跳:
- 静态扇出(§4):编译前就知道有哪几条并行边,
add_edge写死 - 列表扇出(§6):运行时才知道这次要跑哪几个节点,但大家看到同一份状态
Send扇出(§7):运行时才知道跑几个,而且每人一份不同输入
选型很简单:
- 分支固定 → 静态
- 分支数量会变、但工人不需要不同输入 → 列表
- 「把清单里每一项交给一个工人」→
Send
4. 静态扇出:边写死,分支固定 #
最简单的扇出不需要条件边,也不需要 Send。从同一个节点连出两条(或更多)固定边,下游就会进入同一个超步。
4.1. 从同一个节点连出两条边 #
场景:用户给一个城市名,同时去「查天气」和「查新闻」。两个节点各往 log 里记一条,最后一起出现在结果里。
# operator.add 给 log 做列表拼接
import operator
# Annotated 挂 reducer,TypedDict 声明状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 状态:城市名 + 一条会累加的日志
class S(TypedDict):
    # 普通字段,谁后写谁覆盖;这里只读不抢着写
    topic: str
    # 并行节点都往这里追加,所以必须挂 reducer
    log: Annotated[list[str], operator.add]


# 起点:只记一笔「开始了」
def start_node(state: S) -> dict:
    # 打印出来,方便对照执行顺序
    print("   [start] 执行")
    # 往 log 追加一条
    return {"log": ["start"]}


# 并行工人甲:根据城市写一条天气
def weather(state: S) -> dict:
    # 打印,证明这个节点确实跑了
    print("   [weather] 执行")
    # 读的是 start 跑完之后的状态,topic 还在
    return {"log": [f"天气:{state['topic']} 今天晴"]}


# 并行工人乙:根据城市写一条新闻
def news(state: S) -> dict:
    # 打印
    print("   [news] 执行")
    # 同样读 topic,往 log 追加
    return {"log": [f"新闻:{state['topic']} 有新进展"]}


# 新建图
builder = StateGraph(S)
# 注册起点
builder.add_node("start", start_node)
# 注册天气节点
builder.add_node("weather", weather)
# 注册新闻节点
builder.add_node("news", news)
# 入口进 start
builder.add_edge(START, "start")
# 从 start 连到 weather:第一条扇出边
builder.add_edge("start", "weather")
# 从 start 再连到 news:第二条扇出边。两条都连上,就是扇出
builder.add_edge("start", "news")
# weather 自己结束后去 END
builder.add_edge("weather", END)
# news 自己结束后去 END
builder.add_edge("news", END)
# 编译
graph = builder.compile()
# 跑一次,看 log 里是否两条都在
print("结果:", graph.invoke({"topic": "北京", "log": []}))
运行输出:
   [start] 执行
   [news] 执行
   [weather] 执行
结果: {'topic': '北京', 'log': ['start', '新闻:北京 有新进展', '天气:北京 今天晴']}
两件事值得看:
- 你没有写任何「并行」关键字。 并行完全来自「同一个节点连出了两条边」。
news可能出现在weather前面。 同一超步内的顺序不稳定,不要依赖「先注册的先跑」。要稳定顺序,就不要扇出,改回串行。
4.2. 用 stream 看见同一超步 #
invoke 只给你最终状态。想看中间发生了什么,用 stream:默认每个节点产出一个 chunk。再打开 debug 模式,就能看到超步编号。
# operator.add 给 log 做列表拼接
import operator
# Annotated 挂 reducer,TypedDict 声明状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 和上一节相同的状态
class S(TypedDict):
    # 城市名
    topic: str
    # 累加日志
    log: Annotated[list[str], operator.add]


# 起点节点
def start_node(state: S) -> dict:
    # 追加一条 start
    return {"log": ["start"]}


# 天气节点
def weather(state: S) -> dict:
    # 追加天气
    return {"log": [f"天气:{state['topic']} 今天晴"]}


# 新闻节点
def news(state: S) -> dict:
    # 追加新闻
    return {"log": [f"新闻:{state['topic']} 有新进展"]}


# 新建图,结构与上一节完全一样
builder = StateGraph(S)
# 注册三个节点
builder.add_node("start", start_node)
# 注册天气
builder.add_node("weather", weather)
# 注册新闻
builder.add_node("news", news)
# 入口
builder.add_edge(START, "start")
# 扇出边 1
builder.add_edge("start", "weather")
# 扇出边 2
builder.add_edge("start", "news")
# 天气出口
builder.add_edge("weather", END)
# 新闻出口
builder.add_edge("news", END)
# 编译
graph = builder.compile()

# 先用默认 stream:每个节点一个 chunk
print("=== 默认 stream ===")
# 每循环一次就是一个节点刚刚写下的增量
for chunk in graph.stream({"topic": "北京", "log": []}):
    # 打印节点名和它返回的字典
    print("  ", chunk)

# 再用 debug 模式看超步编号
print("=== debug 超步 ===")
# stream_mode="debug" 会打出更细的事件
for chunk in graph.stream({"topic": "北京", "log": []}, stream_mode="debug"):
    # 只看 task 事件,它告诉你「这一步要跑哪个节点」
    if chunk["type"] == "task":
        # step 是超步号,name 是节点名
        print(f"   step={chunk['step']} node={chunk['payload']['name']}")
运行输出:
=== 默认 stream ===
   {'start': {'log': ['start']}}
   {'news': {'log': ['新闻:北京 有新进展']}}
   {'weather': {'log': ['天气:北京 今天晴']}}
=== debug 超步 ===
   step=1 node=start
   step=2 node=news
   step=2 node=weather
start 的 step 是 1,news 和 weather 的 step 都是 2。编号相同就是同一超步,这就是扇出的实证。
默认 stream 里,并行的两个节点各出一个 chunk,不会合成一个。这也说明:观察进度时按「节点」看,不要指望一步只出现一条。
4.3. 扇入:两条线再汇合 #
上一节两个工人各自走到 END,图在两边都结束时收工。更常见的是:两边都跑完,再进一个汇总节点。做法是让 weather 和 news 都连到同一个 merge。
LangGraph 会等两条边都到达,再跑 merge。merge 读到的 log,已经包含两个工人追加的内容。
# operator.add 给 log 做列表拼接
import operator
# Annotated 挂 reducer,TypedDict 声明状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 状态不变
class S(TypedDict):
    # 城市名
    topic: str
    # 累加日志
    log: Annotated[list[str], operator.add]


# 起点
def start_node(state: S) -> dict:
    # 记一笔
    print("   [start] 执行")
    # 追加 start
    return {"log": ["start"]}


# 天气工人
def weather(state: S) -> dict:
    # 记一笔
    print("   [weather] 执行")
    # 追加天气
    return {"log": [f"天气:{state['topic']} 今天晴"]}


# 新闻工人
def news(state: S) -> dict:
    # 记一笔
    print("   [news] 执行")
    # 追加新闻
    return {"log": [f"新闻:{state['topic']} 有新进展"]}


# 汇总节点:等两个工人都到齐再跑
def merge(state: S) -> dict:
    # 打印此时已经攒下的 log,证明扇入发生在合并之后
    print("   [merge] 执行, 此时 log =", state["log"])
    # 再追加一条 merge,表示汇总完成
    return {"log": ["merge"]}


# 新建图
builder = StateGraph(S)
# 注册四个节点
builder.add_node("start", start_node)
# 注册天气
builder.add_node("weather", weather)
# 注册新闻
builder.add_node("news", news)
# 注册汇总
builder.add_node("merge", merge)
# 入口
builder.add_edge(START, "start")
# 扇出到天气
builder.add_edge("start", "weather")
# 扇出到新闻
builder.add_edge("start", "news")
# 天气跑完去 merge(扇入的一条边)
builder.add_edge("weather", "merge")
# 新闻跑完也去 merge(扇入的另一条边)
builder.add_edge("news", "merge")
# 汇总完结束
builder.add_edge("merge", END)
# 编译
graph = builder.compile()
# 跑一次
print("结果:", graph.invoke({"topic": "北京", "log": []}))
运行输出:
   [start] 执行
   [news] 执行
   [weather] 执行
   [merge] 执行, 此时 log = ['start', '新闻:北京 有新进展', '天气:北京 今天晴']
结果: {'topic': '北京', 'log': ['start', '新闻:北京 有新进展', '天气:北京 今天晴', 'merge']}
merge 打印的时候,两条工人日志已经在了。执行顺序一定是:先 start,再两个工人(顺序不定),最后才是 merge。这就是扇出 + 扇入的完整形状。
5. 没配 reducer 会怎样 #
静态扇出看起来太顺利了。下面把 log 换成一个没有 reducer 的普通字段,让两个工人同时写它。这是扇出里最常见的报错,建议自己跑一次,下次看见 InvalidUpdateError 就知道该往哪改。
# TypedDict 声明状态,这次故意不引入 Annotated
from typing import TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 两个并行节点都要写 note,但 note 没有 reducer
class Plain(TypedDict):
    # 城市名,只读
    topic: str
    # 普通字符串:同一超步里只能被写一次
    note: str


# 新建图
builder = StateGraph(Plain)
# 起点随便写一下 note,不参与冲突
builder.add_node("start", lambda s: {"note": "start"})
# 天气工人写 note
builder.add_node("weather", lambda s: {"note": "天气好"})
# 新闻工人也写 note,和天气抢同一个键
builder.add_node("news", lambda s: {"note": "有新闻"})
# 入口
builder.add_edge(START, "start")
# 扇出
builder.add_edge("start", "weather")
# 扇出第二条
builder.add_edge("start", "news")
# 天气出口
builder.add_edge("weather", END)
# 新闻出口
builder.add_edge("news", END)
# 编译能通过:compile 不检查「会不会并行抢键」
graph = builder.compile()
# 运行时才会爆
try:
    # 同一超步里 weather 和 news 都返回 note
    print(graph.invoke({"topic": "北京", "note": ""}))
except Exception as e:
    # 打印异常类型和第一行信息
    print(type(e).__name__, str(e).splitlines()[0])
运行输出:
InvalidUpdateError At key 'note': Can receive only one value per step. Use an Annotated key to handle multiple values.报错已经把做法写在脸上了:Use an Annotated key。把 note 改成列表并挂 operator.add,或者改成两个工人写不同的键(一个写 weather_note,一个写 news_note),都可以。
对照记一句:
| 串行写同一字段 | 并行写同一字段 | |
|---|---|---|
| 没 reducer | 后写的盖掉先写的(不报错) | 直接报错 |
| 有 reducer | 按规则合并 | 按规则合并 |
扇出出问题,第一反应永远是:他们是不是在抢同一个没配 reducer 的键?
6. 列表扇出:这次跑几个可以变 #
静态扇出的边是写死的:每次都是天气 + 新闻。如果用户有时只要天气、有时三个都要,编译期就没法把边画死。这时让条件边返回一个节点名列表,列表里的节点会进入同一个超步。
6.1. 运行时决定跑哪几个 #
路由函数读状态里的 tasks,把它翻译成节点名。出口表(path_map)列出所有可能的下游;返回值是这一次的子集。
# operator.add 给 log 做列表拼接
import operator
# Annotated 挂 reducer,TypedDict 声明状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 状态:用户点了哪些任务 + 日志
class BranchS(TypedDict):
    # 用户勾选的任务名,比如 ["天气", "路况"]
    tasks: list[str]
    # 累加日志,用来观察实际跑了谁
    log: Annotated[list[str], operator.add]


# 分发节点:本身不决定去哪,只记一笔
def dispatch(state: BranchS) -> dict:
    # 追加 dispatch,证明分发节点跑过了
    return {"log": ["dispatch"]}


# 路由函数:根据 tasks 翻译出节点名列表
def pick(state: BranchS) -> list[str]:
    # 中文任务名 → 节点名
    mapping = {"天气": "weather", "新闻": "news", "路况": "traffic"}
    # 只保留认识的任务,翻译成节点名
    return [mapping[t] for t in state["tasks"] if t in mapping]


# 天气节点
def weather(state: BranchS) -> dict:
    # 记下自己的名字
    return {"log": ["weather"]}


# 新闻节点
def news(state: BranchS) -> dict:
    # 记下自己的名字
    return {"log": ["news"]}


# 路况节点
def traffic(state: BranchS) -> dict:
    # 记下自己的名字
    return {"log": ["traffic"]}


# 新建图
builder = StateGraph(BranchS)
# 注册分发节点
builder.add_node("dispatch", dispatch)
# 注册三个候选工人
builder.add_node("weather", weather)
# 注册新闻
builder.add_node("news", news)
# 注册路况
builder.add_node("traffic", traffic)
# 入口进分发
builder.add_edge(START, "dispatch")
# 条件边:pick 返回列表;第三个参数是出口全集
builder.add_conditional_edges("dispatch", pick, ["weather", "news", "traffic"])
# 三个工人跑完都结束
builder.add_edge("weather", END)
# 新闻出口
builder.add_edge("news", END)
# 路况出口
builder.add_edge("traffic", END)
# 编译
graph = builder.compile()
# 三个都要
print("三项:", graph.invoke({"tasks": ["天气", "新闻", "路况"], "log": []}))
# 只要两个
print("两项:", graph.invoke({"tasks": ["天气", "路况"], "log": []}))
运行输出:
三项: {'tasks': ['天气', '新闻', '路况'], 'log': ['dispatch', 'news', 'traffic', 'weather']}
两项: {'tasks': ['天气', '路况'], 'log': ['dispatch', 'traffic', 'weather']}
第二次没有 news。出口表是可能的全集,返回值是这一次的子集。 三个候选节点都要先 add_node 注册好,不能在运行时发明一个没注册的名字。
和静态扇出比,列表扇出多出来的能力只有一句:分支集合可以随输入变。每个工人看到的仍是同一份状态(都看得到完整的 tasks)。一人一份不同输入,是下一节 Send 的事。
6.2. 返回空列表会悄悄结束 #
tasks 若是空的,pick 就返回 []。空列表的含义是「一个下游都不触发」,图就此结束,不报错。
# operator.add 给 log 做列表拼接
import operator
# Annotated 挂 reducer,TypedDict 声明状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph


# 复用上一节的状态
class BranchS(TypedDict):
    # 任务清单
    tasks: list[str]
    # 累加日志
    log: Annotated[list[str], operator.add]


# 分发节点
def dispatch(state: BranchS) -> dict:
    # 记一笔
    return {"log": ["dispatch"]}


# 路由:空 tasks 就会得到空列表
def pick(state: BranchS) -> list[str]:
    # 翻译表
    mapping = {"天气": "weather", "新闻": "news", "路况": "traffic"}
    # 空输入 → 空列表
    return [mapping[t] for t in state["tasks"] if t in mapping]


# 三个工人(这次一个都不会跑,但图上必须注册)
def weather(state: BranchS) -> dict:
    # 若被调用会记一笔
    return {"log": ["weather"]}


# 新闻工人
def news(state: BranchS) -> dict:
    # 记一笔
    return {"log": ["news"]}


# 路况工人
def traffic(state: BranchS) -> dict:
    # 记一笔
    return {"log": ["traffic"]}


# 新建图
builder = StateGraph(BranchS)
# 注册分发
builder.add_node("dispatch", dispatch)
# 注册天气
builder.add_node("weather", weather)
# 注册新闻
builder.add_node("news", news)
# 注册路况
builder.add_node("traffic", traffic)
# 入口
builder.add_edge(START, "dispatch")
# 条件边,出口表仍是三个
builder.add_conditional_edges("dispatch", pick, ["weather", "news", "traffic"])
# 三个出口
builder.add_edge("weather", END)
# 新闻出口
builder.add_edge("news", END)
# 路况出口
builder.add_edge("traffic", END)
# 编译
graph = builder.compile()
# 传入空任务列表
print("空:", graph.invoke({"tasks": [], "log": []}))
运行输出:
空: {'tasks': [], 'log': ['dispatch']}只有 dispatch,三个工人都没跑,也没有任何异常。写「按条件过滤出要跑的分支」时要小心:过滤到一个都不剩,图就悄悄收工。 稳妥做法是空列表时返回一个兜底节点名,比如 "idle",在那里给用户一句「你没有勾选任何任务」。
7. Send:每个工人拿到不同的输入 #
列表扇出有一个限制:所有工人看到的是同一份状态。这在「天气 / 新闻 / 路况」这种「工种不同、输入相同」的场景刚好够用。换成「把 10 个问题分给 10 个工人,每人只处理一个」,同一份状态就不够了——每个工人需要自己那一条。
7.1. 为什么普通列表不够 #
假如状态是 {"questions": ["是什么", "怎么用", "注意什么"]},你返回 ["worker", "worker", "worker"],三个实例看到的仍是整份 questions。工人自己还得想办法知道「我是三个里的第几个」,既别扭又容易抢同一个字段。
Send 就是为这个场景准备的:每发一份,都带上这个工人该看到的那一小段数据。
7.2. Send 的两个参数 #
Send 来自 langgraph.types,长这样:
Send("节点名", {这个工人能看到的全部状态})两个要点,建议读两遍:
- 第二个参数就是工人眼里的全部状态。 主图里的其它字段,工人默认看不见。需要用的,必须亲手塞进这个字典。
- 工人返回的增量,仍按字段名合并回主图。 所以工人虽然输入是「一份专属小字典」,输出的键(比如
answers)必须在主状态里存在,并且并行写入时要有 reducer。
可以把它想成发快递:面单上写清送到哪个工位(节点名),箱子里只放这个工位需要的零件(专属输入)。工位干完把成品放回仓库里对应的货架(主状态的 reducer 字段)。
7.3. 完整的拆分 → 扇出 → 汇总 #
下面是一个不调模型的 map-reduce:
- Map / 拆分:把主题拆成三个子问题
- Fan-out / 扇出:每个子问题一份
Send,三个worker实例并行 - Reduce / 扇入:
worker都连到reduce,把答案拼成一段报告
工人函数读的是 WorkerIn(只有 question 和 topic),不是主状态。这正是 Send 的意义。
# operator.add 用来把每个工人返回的 answers 拼成一张大列表
import operator
# Annotated 挂 reducer,TypedDict 声明两种状态
from typing import Annotated, TypedDict

# 搭图用的三件套
from langgraph.graph import END, START, StateGraph
# Send 表示「派一个节点实例去处理这一小段数据」
from langgraph.types import Send


# 主图状态:主题、子问题清单、并行答案、最终报告
class MapState(TypedDict):
    # 用户给的大主题
    topic: str
    # 拆分出来的子问题
    questions: list[str]
    # 每个工人追加一条答案,必须有 reducer
    answers: Annotated[list[str], operator.add]
    # 汇总后的完整报告
    report: str


# 工人看到的输入:只有 Send 里塞进来的字段
class WorkerIn(TypedDict):
    # 自己负责的那一个子问题
    question: str
    # 主题也带上,写答案时用得着
    topic: str


# 拆分节点:根据主题造三个子问题
def split_topic(state: MapState) -> dict:
    # 演示用:固定拆成三个问法,真实项目里这里可以调模型
    qs = [
        # 第一个子问题
        f"{state['topic']}:是什么",
        # 第二个子问题
        f"{state['topic']}:怎么用",
        # 第三个子问题
        f"{state['topic']}:注意什么",
    ]
    # 写入 questions;report 先清空
    return {"questions": qs, "report": ""}


# 路由函数:为每个子问题构造一份 Send
def fan_out(state: MapState) -> list:
    # 列表推导:一个问题对应一个 Send
    return [
        # 目标节点都叫 worker;第二参数是这个实例能看到的全部内容
        Send("worker", {"question": q, "topic": state["topic"]})
        # 遍历拆分结果
        for q in state["questions"]
    ]


# 工人:只处理自己那一个问题
def worker(state: WorkerIn) -> dict:
    # 打印工人实际看到的字典,方便确认「看不见主状态里的其它键」
    print(f"   [worker] 看到 {state}")
    # 模拟回答:真实项目里这里调模型或检索
    return {"answers": [f"{state['question']} → 模拟回答"]}


# 汇总:等所有工人到达后再跑
def reduce(state: MapState) -> dict:
    # 把多条答案拼成一段话
    body = ";".join(state["answers"])
    # 写入报告字段
    return {"report": f"关于「{state['topic']}」的汇总:{body}"}


# 新建图,绑定的是主状态
builder = StateGraph(MapState)
# 注册拆分
builder.add_node("split", split_topic)
# 注册工人(会被 Send 多次进入)
builder.add_node("worker", worker)
# 注册汇总
builder.add_node("reduce", reduce)
# 入口先进拆分
builder.add_edge(START, "split")
# 拆分完由 fan_out 动态扇出;出口表里写出 worker
builder.add_conditional_edges("split", fan_out, ["worker"])
# 每个工人实例跑完都去 reduce,reduce 会等全部到齐
builder.add_edge("worker", "reduce")
# 汇总完结束
builder.add_edge("reduce", END)
# 编译
graph = builder.compile()
# 造一份完整初始状态:reducer 字段给空列表,普通字段给空字符串
print(
    "结果:",
    graph.invoke(
        {
            # 大主题
            "topic": "扇出",
            # 子问题待拆分节点填写
            "questions": [],
            # 答案从空列表开始累加
            "answers": [],
            # 报告待汇总节点填写
            "report": "",
        }
    ),
)
运行输出:
   [worker] 看到 {'question': '扇出:是什么', 'topic': '扇出'}
   [worker] 看到 {'question': '扇出:怎么用', 'topic': '扇出'}
   [worker] 看到 {'question': '扇出:注意什么', 'topic': '扇出'}
结果: {'topic': '扇出', 'questions': ['扇出:是什么', '扇出:怎么用', '扇出:注意什么'], 'answers': ['扇出:是什么 → 模拟回答', '扇出:怎么用 → 模拟回答', '扇出:注意什么 → 模拟回答'], 'report': '关于「扇出」的汇总:扇出:是什么 → 模拟回答;扇出:怎么用 → 模拟回答;扇出:注意什么 → 模拟回答'}
对照着看三处:
- 每个工人打印出来的字典只有两个键,没有
questions、没有answers、没有report - 三个答案都进了主状态的
answers,靠的是operator.add reduce只跑一次,读到的是已经拼好的完整列表
这就是 map-reduce 在 LangGraph 里的最小形状。把 worker 里的「模拟回答」换成真正的检索或模型调用,就是生产里最常见的用法。
7.4. 漏带字段会立刻报错 #
Send 的第二参数漏了工人要用的键,工人一读就会 KeyError。这一点比「静默跑错」友好:漏了就炸,不会假装成功。
# operator.add 给 answers 做拼接
import operator
# Annotated / TypedDict
from typing import Annotated, TypedDict

# 搭图三件套
from langgraph.graph import END, START, StateGraph
# Send 用来投递专属输入
from langgraph.types import Send


# 主状态
class MapState(TypedDict):
    # 待处理条目
    items: list[str]
    # 并行结果
    answers: Annotated[list[str], operator.add]


# 工人故意同时读 item 和 topic,但 Send 只给了 item
def worker(state: dict) -> dict:
    # 这里访问 topic:Send 里没有就会 KeyError
    return {"answers": [state["item"] + "|" + state["topic"]]}


# 新建图
builder = StateGraph(MapState)
# 注册工人
builder.add_node("worker", worker)
# 从 START 直接扇出;每个 Send 只塞了 item,没塞 topic
builder.add_conditional_edges(
    START,
    # 路由:给每个 item 发一份残缺的 Send
    lambda s: [Send("worker", {"item": i}) for i in s["items"]],
    # 出口表
    ["worker"],
)
# 工人出口
builder.add_edge("worker", END)
# 编译
graph = builder.compile()
# 运行并抓异常
try:
    # items 有一条,足够触发工人
    print(graph.invoke({"items": ["a"], "answers": []}))
except Exception as e:
    # 打印类型和缺的那个键
    print(type(e).__name__, "|", e)
运行输出:
KeyError | 'topic'修好的方法只有一个:工人要用的字段,Send 里都带上。 不要指望它能「顺便」读到主状态。
8. 常见坑 #
前面的报错都见过了,这里收成一张对照表,方便出问题时对照。每一条都是扇出场景里会真实碰到的,不是边角知识。
| 现象 | 原因 | 怎么办 |
|---|---|---|
InvalidUpdateError: Can receive only one value per step |
同一超步里多个节点写同一个没 reducer 的字段 | 给该字段加 Annotated[..., operator.add],或改成写不同的键 |
| 最终列表少了某条 | 串行覆盖,或以为扇出会自动追加 | 并行字段必须有 reducer;串行覆盖是默认行为 |
KeyError: '某字段'(Send 场景) |
工人读了 Send 里没给的键 | 把该字段放进 Send 的第二个字典 |
| 工人一个都没跑,也不报错 | 路由函数返回了空列表 | 空列表时改返回一个兜底节点 |
| 并行节点的打印顺序每次不一样 | 同一超步不保证顺序 | 不要依赖顺序;要顺序就改串行 |
| 墙钟时间并没有变短 | 普通 def 仍是一个接一个调用 |
结构并行 ≠ 时间并行;要重叠耗时需 async def |
最后一条再强调一次。本教程所有例子都是同步函数:扇出改变的是合并语义(同一超步、彼此看不见对方的写入),不是自动让两个 time.sleep(1) 变成只等 1 秒。入门先把结构跑对,再考虑异步。
9. 动手练习 #
只看不改,印象留不住。下面五道都建立在已经能跑的代码上,改完对照 §8 那张表。
- 复现抢键。 把 §4.1 的
log改成普通str(去掉Annotated),跑一次,确认出现InvalidUpdateError。再改回来。 - 给静态扇出加第三个工人。 在
start上再连一个traffic节点,三路都扇入merge。看merge打印时 log 里是不是三条都在。 - 列表扇出返回空列表。 用 §6.2 的图,给
pick加一句:列表为空时返回"idle",并注册一个idle节点往 log 里写"请先勾选任务"。 - Send 漏字段。 把 §7.3 里
Send的"topic": state["topic"]删掉,看工人报什么错。改回去。 - 自己换一份清单。 把主题改成一篇文章的三个段落(用三个字符串模拟),工人返回「这一段的字数」,
reduce打印总字数。不调模型,纯 Python 就能做完。
10. 小结 #
扇出不是新 API,是一种连边方式:
- 从一个节点同时触发多个下游,它们进入同一个超步,彼此看不见对方刚写的值。
- 静态扇出用多次
add_edge;列表扇出用条件边返回节点名列表;Send扇出在列表的基础上给每个工人一份专属输入。 - 扇入就是多条边指向同一个下游。下游会等所有上游到齐,再读已经合并好的状态。
- 并行写入的字段必须有 reducer。 没有就
InvalidUpdateError。列表用operator.add就够入门。 Send的第二参数是工人能看到的全部状态。 漏带字段会KeyError,主图其它键不会自动出现。- 空列表等于一个下游都不走,图悄悄结束。过滤分支时要给空结果留兜底。
- 同步函数的扇出不保证更快,只保证合并语义正确。先把图画对,再谈异步加速。
三种写法怎么选:分支固定用静态;人数会变但输入相同用列表;「清单里每一项一个工人」用 Send。入门把 §4、§5、§7.3 三份代码跑通、改通,扇出就算学会了。