1. 本章目标 #
第 2 章跑通了最小 Agent;第 8 章把工具定义、schema 与错误回灌讲清楚,并产出了业务工具包。
到这一步,「会创建 Agent」通常已不是问题。真正卡住交付的,往往是配置与策略:
- 系统提示太虚,多工具时选型漂、乱编事实
- 一次用户问题要串多个工具,轨迹难读、协作不稳
- 不同角色 / 场景需要不同工具集或不同模型,却只会写死一份配置
本章要补的能力分三块:
| 块 | 解决什么 | 对应节 |
|---|---|---|
| 策略 | 人设、路由、禁令怎么写 | §3 |
| 协作 | 多意图一次问清、如何验收 | §4 |
| 动态 | 按人 / 角色 / 复杂度改提示、工具、模型 | §5~7 |
本章把驾驭层(create_agent)的可配置能力用起来:
深入
create_agent:写好系统提示、稳住多工具协作,并用 middleware 做动态提示 / 选工具 / 选模型,组装多工具办公助理。
学完你应能:
- 为 Agent 设计可维护的
system_prompt(与工具描述分工) - 组织和调试多工具协作(组合提问、读完整轨迹)
- 用
@dynamic_prompt按运行时上下文生成系统提示 - 用
@wrap_model_call动态过滤工具、切换模型 - 用
@wrap_tool_call执行动态新增工具(并理解与错误兜底的关系) - 说清 middleware 的执行顺序模型和调用次数——这两点决定了你写的策略会不会按预期生效
- 在 Agent 层用
response_format+ToolStrategy产出结构化终态(§7.2) - 产出完整的多工具办公助理
本章有几条实测结论和直觉相反,先预告,读到对应小节会有完整证据:
| 你可能以为 | 实际情况 | 见 |
|---|---|---|
middleware 每次 invoke 跑一遍 |
每次调模型跑一遍;一轮工具调用就是 2 次 | §2.1 |
middleware=[A, B] 是 A 跑完再跑 B |
是洋葱嵌套:A 包着 B,A 先进最后出 | §2.2 |
动态提示会和静态 system_prompt 合并 |
动态提示完全覆盖静态的,静态那段被丢弃 | §5.3 |
不传 context 时会用 dataclass 的默认值 |
runtime.context 直接是 None,默认值不生效 |
§5.1(4) |
| 只暴露不执行,会等模型选中它才报错 | 调模型前就预检失败,问一句无关的话也会炸 | §6.2 |
开了 response_format 后末条消息是自然语言 |
是一条 ToolMessage,内容为 Returning structured response: ... |
§7.2 |
参考文档:
本章会用到第 8 章的工具思路;示例内嵌完整工具定义,便于单文件运行。护栏 / HITL / 限流等放到第 10 章——那些是「能不能上生产」的硬闸;本章先把「策略与动态配置」做稳。
2. 再认识 create_agent #
回顾公式:Agent = Model + 驾驭层(Harness)。create_agent 是官方推荐入口:最小只要模型;再挂上工具、系统提示、middleware,就是可上线助理的骨架。
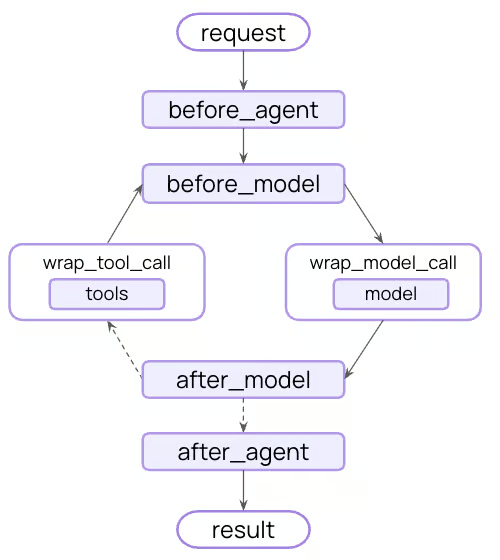
第 2 章的用法可记成「静态三件套」:
create_agent(model=..., tools=..., system_prompt=...)Demo 够用。业务一复杂就会发现:同一套 Agent 要服务不同角色、租户、复杂度——若每次复制粘贴新建,维护成本会迅速上升。middleware + context 正是为「同一底盘、不同策略」准备的。
常用参数(入门先抓住前四个,其余知道挂在哪):
| 参数 | 作用 | 本章是否深入 |
|---|---|---|
model |
模型字符串或已初始化实例 | 静态用 + §7 动态换 |
tools |
静态工具列表(可再被 middleware 收窄 / 增补) | 承接第 8 章 + §6 |
system_prompt |
静态系统提示(str 或 SystemMessage) |
§3;动态见 §5 |
middleware |
钩子链:改提示、改工具、改模型、处理错误等 | §5~7 重点 |
context_schema |
声明 invoke(..., context=...) 的上下文类型 |
§5~6、§8 |
response_format |
Agent 层结构化输出 | 第 6 章已预览 |
checkpointer |
会话持久化 | 第 11 章 |
心智图:
create_agent
├── 静态配置:model / tools / system_prompt     ← 底盘
├── 运行时输入:messages(± context)          ← 每次请求不同
└── middleware:在「调模型 / 调工具」前后改请求  ← 策略插槽
读代码时记住两层时间:
- 创建时:图结构、默认可执行工具集、middleware 列表被固定下来
- 调用时:
messages/context进来;middleware 可改「这一次」模型看到的提示与工具
第 2 章只用了静态三件套;本章重点是:系统提示策略 + 多工具协作 + middleware 动态性。
2.1. middleware 每次「调模型」跑一遍,不是每次 invoke 跑一遍 #
这是最容易想错的一点。写个计数器验证:
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# ModelRequest 是请求对象类型,wrap_model_call 是模型调用拦截装饰器
from langchain.agents.middleware import ModelRequest, wrap_model_call
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载 .env 中的 API key
load_dotenv(override=True)

# 用列表记录每次进入 middleware 时看到的消息条数
calls = []


# 注册一个天气工具,确保模型会发起工具调用
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    return f"{city} 晴,25°C。"


# 注册模型调用拦截器
@wrap_model_call
# 签名固定为 (request, handler)
def count_calls(request: ModelRequest, handler):
    # 每次被调用就记录一下当前状态里的消息条数
    calls.append(len(request.state["messages"]))
    # 必须把控制权交还给链路
    return handler(request)


# 创建 Agent 并挂上计数器
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 一个工具
    tools=[get_weather],
    # middleware 接收列表
    middleware=[count_calls],
    # 引导模型调用工具
    system_prompt="查天气必须调用 get_weather。",
)

# 只调用一次 invoke
res = agent.invoke({"messages": [{"role": "user", "content": "北京天气怎么样?"}]})

# 观察 middleware 实际被触发了几次
print(f"middleware 被调用 {len(calls)} 次,每次看到的消息条数: {calls}")
# 对比最终状态里的消息总数
print(f"最终 messages 条数: {len(res['messages'])}")
输出:
middleware 被调用 2 次,每次看到的消息条数: [1, 3]
最终 messages 条数: 4
一次 invoke,middleware 跑了 2 次。 因为一轮完整的工具调用需要两次模型调用:
第 1 次调模型(state 里 1 条消息:Human)
   → 模型发出 tool_calls
   → 执行工具,追加 AIMessage + ToolMessage
第 2 次调模型(state 里 3 条消息)
   → 模型给出最终回答
三个实际后果:
- 别在 middleware 里做「每次请求只该做一次」的事,比如写审计日志、扣配额、发通知。工具一多,它会跑很多次。
- 基于
len(messages)的判断会在一次invoke内部变化。§7 的动态换模就是这样:第 1 次调用时消息还短、用快模型,第 2 次可能已超阈值、换成强模型——同一次对话里换了模型。这未必是坏事,但你得知道。 - 调试时打印次数是有用信号。若以为只该调一次模型,却看到 middleware 跑了 5 次,说明模型在反复调工具,可能陷入了循环。
2.2. middleware 是洋葱式嵌套,第一个在最外层 #
middleware=[A, B, C] 不是「A 跑完跑 B,B 跑完跑 C」。实际是 A 包着 B、B 包着 C,C 里面才是真正的模型调用。
用三层拦截器实测:
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入请求类型与模型调用拦截装饰器
from langchain.agents.middleware import ModelRequest, wrap_model_call
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载环境变量
load_dotenv(override=True)

# 用列表按时间顺序记录进出
log = []


# 占位工具
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    return f"{city} 晴,25°C。"


# 第一层拦截器
@wrap_model_call
def layer_one(request: ModelRequest, handler):
    # 进入时记录
    log.append("第1个 进")
    # 调用下一层(可能是下一个 middleware,也可能是真正的模型)
    r = handler(request)
    # 下一层返回后记录
    log.append("第1个 出")
    # 把结果继续往上返回
    return r


# 第二层拦截器
@wrap_model_call
def layer_two(request: ModelRequest, handler):
    # 进入时记录
    log.append("第2个 进")
    # 调用下一层
    r = handler(request)
    # 返回后记录
    log.append("第2个 出")
    # 往上返回
    return r


# 第三层拦截器
@wrap_model_call
def layer_three(request: ModelRequest, handler):
    # 进入时记录
    log.append("第3个 进")
    # 这一层的 handler 才是真正调模型
    r = handler(request)
    # 返回后记录
    log.append("第3个 出")
    # 往上返回
    return r


# 按 1、2、3 的顺序挂上
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 工具列表
    tools=[get_weather],
    # 注意这个列表顺序
    middleware=[layer_one, layer_two, layer_three],
    # 一句简单提示,让模型不调工具,只产生一次模型调用
    system_prompt="你是助手。",
)

# 问一句不需要工具的话,保证只调一次模型
agent.invoke({"messages": [{"role": "user", "content": "你好"}]})

# 打印进出顺序
for line in log:
    print(line)
输出:
第1个 进
第2个 进
第3个 进
第3个 出
第2个 出
第1个 出
画成图就是标准洋葱:
middleware=[layer_one, layer_two, layer_three]

┌─ layer_one(最外层,最先进、最后出)
│  ┌─ layer_two
│  │  ┌─ layer_three(最内层,离模型最近)
│  │  │   ★ 真正调用 LLM
│  │  └─
│  └─
└─
记住一句话:列表里越靠前,层级越外。
这不是学术细节,直接决定策略能否生效。后面会碰到:若动态提示要写「你当前可用的工具有 X、Y」,它必须看到过滤之后的工具列表——也就是放在过滤器的内层(列表更靠后)。反过来放,看到的就是未过滤全集。§8.2 会用实测说明这个取舍。
顺便提一个小坑:同一个 middleware 不能挂两次,会在创建时报
AssertionError: Please remove duplicate middleware instances.。若同类逻辑要跑两遍,就定义两个不同名字的函数。
3. 系统提示:给 Agent 的策略层 #
工具 docstring 告诉模型「这个工具干什么」;system_prompt 告诉模型「你是谁、优先做什么、禁止做什么、多工具时怎么选」。
很多「工具明明挂了却不调 / 乱调」的问题,根因不在 @tool,而在策略层太糊:模型不知道何时必须动手、何时必须停。
两者同向才稳:
| 层 | 写什么 | 例子 | 偏软 / 偏硬 |
|---|---|---|---|
| 系统提示 | 角色、流程、禁令、路由策略 | 「查订单必须用 lookup_order,禁止编造」 | 软约束(靠模型遵守) |
| 工具描述 | 能力边界与参数含义 | 「订单号形如 A1001」 | 软约束(影响选型与填参) |
| 工具过滤(§6) | 本次根本不暴露某工具 | 员工看不到 lookup_order |
硬约束 |
权限类需求不要只写在提示里:提示负责「教」,过滤负责「锁」。
3.1. 建议结构 #
可按六段组织(不必每次写满,但别只写「你是助手」):
1. 角色:你是谁、服务谁
2. 目标:成功标准(简洁、可执行、有依据)
3. 工具策略:何时用哪个;能否并行;缺参怎么办
4. 禁令:不编造订单/制度/天气;不算心算
5. 输出风格:中文、条目、先结论后依据
6. 边界:超出范围时如何拒绝或转交
写的时候优先「可执行的短句」,少用空泛形容词:
- 好:
查订单进度 → lookup_order;没有订单号先追问 - 差:
请尽可能友好地帮助用户解决问题
3.2. system_prompt_office.py #
下面示例把「路由表 + 禁令 + 输出风格」写进同一段静态提示,先建立手感;§5 再改成按人动态生成。
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 注册查单工具
@tool
# 入参为订单号
def lookup_order(order_id: str) -> str:
    # 描述里说明订单号格式,帮助模型正确填参
    """按订单号查询物流状态。订单号形如 A1001。"""
    # 模拟订单库
    catalog = {"A1001": "已发货", "A1002": "运输中"}
    # 规范化输入:去空格并转大写,容忍模型的格式偏差
    key = order_id.strip().upper()
    # 查不到时返回错误说明而不是抛异常(第 8 章 §9 的做法)
    if key not in catalog:
        return f"错误:未找到订单 {order_id}。"
    # 查到则返回状态
    return f"订单 {key} 状态:{catalog[key]}。"


# 注册制度查询工具
@tool
# 入参为制度主题
def lookup_policy(topic: str) -> str:
    # 描述里列出可选主题
    """查询公司制度摘要。topic 可为报销、请假、加班。"""
    # 模拟制度库
    policies = {
        # 报销制度
        "报销": "差旅报销需在返程 7 日内提交。",
        # 请假制度
        "请假": "年假提前 3 天申请。",
    }
    # 遍历制度库做「关键词包含」的模糊匹配
    for k, v in policies.items():
        # 主题里含关键词就算命中,能容忍「报销流程」这类问法
        if k in topic:
            return v
    # 全部未命中时返回错误说明与可选项
    return "错误:未匹配到制度。请尝试:报销 / 请假。"


# 把系统提示抽成常量,便于单独维护与版本对比
SYSTEM_PROMPT = """你是公司办公助手,回答简洁、有依据。

工具策略:
- 查订单进度 → lookup_order
- 问制度规章 → lookup_policy
- 信息不足时先追问关键字段(如订单号),不要猜测

禁止:
- 编造订单状态或制度条文
- 在工具返回「错误:」时假装查到了结果

输出:先给结论,必要时再补一句依据。"""

# 创建 Agent,三件套齐全
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 两个工具
    tools=[lookup_order, lookup_policy],
    # 把上面那段提示传进去
    system_prompt=SYSTEM_PROMPT,
)

# 一句话里问两件事,观察模型是否都处理
result = agent.invoke(
    {"messages": [{"role": "user", "content": "A1001 到哪了?报销怎么走?"}]}
)
# 打印最终回答
print(result["messages"][-1].content)
完整轨迹(这才是验收依据):
[0] HumanMessage: 'A1001 到哪了?报销怎么走?'
[1] AIMessage: ''
     -> lookup_order({'order_id': 'A1001'})
     -> lookup_policy({'topic': '报销'})
[2] ToolMessage: '订单 A1001 状态:已发货。'
[3] ToolMessage: '差旅报销需在返程 7 日内提交。'
[4] AIMessage: '**订单 A1001**:已发货。\n\n**报销**:差旅报销需在返程 7 日内提交。'
最终输出:
**订单 A1001**:已发货。

**报销**:差旅报销需在返程 7 日内提交。
这段轨迹有两点值得注意:
- 一条
AIMessage同时带了 2 个tool_calls(第 8 章讲过的并行调用)。模型没有一件一件来,而是一次递出两个请求,所以只需 2 次模型调用,而不是 3 次。 - 提示里的「先给结论」真的生效了:回答直接给状态和条文,没有「让我帮您查一下」这类铺垫。这正是「可执行的短句」比空泛形容词更管用的地方。
提示写得再好,也要用完整 messages 验证是否真的调了工具(第 2 / 4 / 8 章同一习惯)。
若最终文案「看起来对」,但轨迹里没有 tool_calls,那只是模型在背训练语料——业务上不可接受。这类问题在「查天气」「算数」上尤其常见:模型确实「知道」一些常识答案,容易绕过工具直接编。
4. 多工具协作 #
真实用户很少一次只问一件事。多工具协作要同时稳住三件事:
- 选型:每个子问题落到正确工具
- 填参:订单号、城市名等抽干净
- 汇总:最终回答覆盖所有子问题,且依据工具结果
这三步任一失败,直观感受都是「助手不可靠」。
和 LCEL 固定流水线不同:Agent 的步骤顺序由模型临场决定,因此更依赖清晰路由 + 轨迹验收,不能假设它「应该会懂」。
一次成功协作的轨迹大致是:
HumanMessage(含多个子问题)
  → AIMessage(tool_calls: 天气 / 订单 / 计算 …)
  → ToolMessage × N
  → AIMessage(汇总,覆盖每一项)
中间可能再调几轮工具;别假设永远只有一轮。
4.1. 协作时系统提示怎么写 #
比「你有很多工具」更有效的是显式路由表 + 禁止项:
查天气 → get_weather
算术 → calculate(禁止心算)
查单 → lookup_order
制度 → lookup_policy
一次问题含多项时,按需依次或并行调用,最后统一回答
工具描述本身也要互斥,避免两个工具都写「获取信息」。
「多项都要处理」这句很关键:不少模型默认只答第一个子问题,需要在策略里点名。
4.2. multi_tool_collab.py #
用一句组合问题压测;重点看轨迹,别只盯着最终一段话是否通顺。
# 从 typing 导入 Literal,用于把参数取值限制在固定选项内
from typing import Literal
# 从 pydantic 导入 BaseModel 与 Field,用于声明入参 schema
from pydantic import BaseModel, Field
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 模拟订单库:键为订单号,值含状态与预计天数
ORDERS = {
    # 已发货订单
    "A1001": {"status": "已发货", "eta_days": 2},
    # 运输中订单
    "A1002": {"status": "运输中", "eta_days": 1},
}


# 用 Pydantic 声明天气工具入参(第 8 章 §5.2 的做法)
class WeatherInput(BaseModel):
    # 类 docstring 成为 schema 顶层描述
    """天气查询入参。"""

    # 必填字段,description 帮助模型正确填参
    city: str = Field(description="城市名,如上海")


# 挂上 Pydantic schema
@tool(args_schema=WeatherInput)
# 函数参数名要与 schema 字段一致
def get_weather(city: str) -> str:
    # 描述里写明「必须调用」,压制模型凭常识编造
    """查询城市当前天气。用户问天气时必须调用。"""
    # 返回模拟天气
    return f"{city} 当前晴,约 26°C。"


# 用 description 覆盖描述,明确禁止心算
@tool(description="四则运算。任何算术都请调用,不要心算。")
# op 用 Literal 锁定为四个运算符
def calculate(a: float, b: float, op: Literal["+", "-", "*", "/"]) -> str:
    # 已传 description,这句 docstring 对模型不可见
    """对 a、b 做四则运算。"""
    # 加法
    if op == "+":
        return str(a + b)
    # 减法
    if op == "-":
        return str(a - b)
    # 乘法
    if op == "*":
        return str(a * b)
    # 走到这里是除法,先挡住除零
    if b == 0:
        return "错误:除数不能为 0。"
    # 除法
    return str(a / b)


# 注册查单工具
@tool
# 入参为订单号
def lookup_order(order_id: str) -> str:
    # 描述里说明订单号格式
    """按订单号查询物流状态。订单号形如 A1001。"""
    # 规范化输入
    key = order_id.strip().upper()
    # 用 .get() 避免 KeyError
    row = ORDERS.get(key)
    # 未命中返回错误说明
    if not row:
        return f"错误:未找到订单 {order_id}。"
    # 命中则拼装状态文本
    return f"订单 {key}:{row['status']},预计 {row['eta_days']} 天相关节点完成。"


# 创建 Agent,三个工具一起挂上
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 三个工具覆盖三种意图
    tools=[get_weather, calculate, lookup_order],
    # 系统提示里写清路由表和禁令
    system_prompt=(
        "你是办公助手。"
        "查天气用 get_weather;算术用 calculate;查单用 lookup_order。"
        "一次问题含多项时都要处理;禁止编造与心算。"
    ),
)

# 用一句包含三个意图的话压测
result = agent.invoke(
    {
        # 输入是带 messages 键的字典
        "messages": [
            {
                # 角色为用户
                "role": "user",
                # 同时涉及天气、订单、算术
                "content": "上海天气如何?订单 A1001 到哪了?另外算一下 128+256。",
            }
        ]
    }
)

# 调试协作:看清调了哪些工具,而不只看最终一句
for i, msg in enumerate(result["messages"]):
    # 打印分隔线与消息类型
    print(f"\n===== [{i}] {type(msg).__name__} =====")
    # 用 getattr 安全取 content
    content = getattr(msg, "content", None)
    # 非空才打印,避免刷屏
    if content:
        print("content:", content)
    # tool_calls 只有 AIMessage 才有
    tool_calls = getattr(msg, "tool_calls", None)
    # 有调用意图时打印
    if tool_calls:
        print("tool_calls:", tool_calls)
真实轨迹:
[0] HumanMessage: '上海天气如何?订单 A1001 到哪了?另外算一下 128+256。'
[1] AIMessage: ''
     -> get_weather({'city': '上海'})
     -> lookup_order({'order_id': 'A1001'})
     -> calculate({'a': 128, 'b': 256, 'op': '+'})
[2] ToolMessage: '上海 当前晴,约 26°C。'
[3] ToolMessage: '订单 A1001:已发货,预计 2 天相关节点完成。'
[4] ToolMessage: '384.0'
[5] AIMessage: '为您查询到以下信息:...'
最终回答:
为您查询到以下信息:

1. **上海天气**:当前晴,约 26°C。
2. **订单 A1001**:已发货,预计 2 天内完成相关配送节点。
3. **算术 128+256**:结果为 **384**。

如还有其他需要,随时告诉我~
这是一次经典协作:三个意图一次并行发出、参数全对(含 op: '+' 枚举)、最终回答分点覆盖三项。成功靠三件事叠加:系统提示里的显式路由表 + 工具描述互斥 + Literal 锁死枚举取值。
顺便留意 [4] ToolMessage: '384.0'——因为 calculate 的参数声明成了 float,观察值带了 .0(第 8 章 §8 提过)。模型在最终回答里正确写成了「384」,但日志里的 .0 会一直留着。
验收时自己勾三项:
- 轨迹里出现过
get_weather/lookup_order/calculate(顺序可变) - 参数大致正确(城市=上海,订单=A1001,128 与 256)
- 最终回答三项都覆盖,且不与 ToolMessage 矛盾
三项里最容易漏的是第三项:模型有时工具都调对了,汇总时却漏掉一项。这时问题不在路由,而在输出要求——把「多项问题都要处理,最后统一回答」写进提示,或直接要求「分点回答,每项一行」。
4.3. 协作翻车怎么查 #
| 现象 | 先查什么 |
|---|---|
| 只答了天气,没查单 | 系统提示是否要求「多项都处理」;轨迹里有无对应 tool_calls |
| 算术被心算 | calculate 的 description / 系统提示是否禁止心算 |
| 订单号抽成整句 | 工具参数名与 Field(description=...) 是否够清楚 |
| 工具返回错误后仍编造 | 系统提示禁令 + 错误文案是否引导改口 |
| 调了工具但最终漏答一项 | 输出风格是否要求「统一覆盖」;可让提示要求分点回答 |
经验:
多工具问题先看轨迹里的 tool_calls 列表,再看最终文案是否覆盖每一项。
5. 动态系统提示:@dynamic_prompt #
静态 system_prompt 适合不变的人设。若提示依赖运行时上下文(用户名、租户、角色、语言),为每个用户复制一个 Agent 不现实。
@dynamic_prompt 的作用:在每次调用模型前,根据当前 ModelRequest 生成系统提示字符串(或 SystemMessage)。
它本质是 middleware 的语法糖,专管「只改提示」这类需求。
常见数据来源:
| 来源 | 适合读什么 |
|---|---|
request.runtime.context |
用户名、部门、角色、租户(本次 invoke 传入) |
request.state["messages"] |
对话轮数、最近用户原话、是否已有工具结果 |
与静态提示的分工建议:
- 不变的总原则 → 仍可写在动态函数返回的模板里(每次拼进去)
- 随人 / 随角色变化的句子 → 从
context读取后插入 - 入门阶段:动态与静态
system_prompt二选一,避免两套人设
写 @dynamic_prompt 时,函数签名几乎总是这一形:
# 固定签名:接收一个 ModelRequest,返回系统提示字符串
def office_prompt(request: ModelRequest) -> str:
    # 函数体里从 request 读上下文、拼提示、返回
    ...
下面四个概念搞清后,后面「动态选工具 / 选模型」会好读很多——它们读的也是同一份 ModelRequest。
5.1. ModelRequest #
可以把一次「即将调用模型」想成:框架先打好一包请求,再交给 middleware 改一改:
invoke(messages=..., context=...)
        │
        ▼
组装 ModelRequest
├── model / tools / system_message   ← 这次要发给模型的配置
├── messages                         ← 本次请求用的对话消息(一般不含 system)
├── state                            ← Agent 状态快照(含 messages 等)
└── runtime                          ← 运行时句柄(含 context、store 等)
        │
        ▼
@dynamic_prompt / @wrap_model_call 可读可 override
        │
        ▼
真正调用 LLM
(1)ModelRequest:这一次模型调用的请求对象 #
ModelRequest 是 middleware 在「调模型前」拿到的结构化请求。想确认有哪些字段,直接打印最可靠:
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入请求类型与模型调用拦截装饰器
from langchain.agents.middleware import ModelRequest, wrap_model_call
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载环境变量
load_dotenv(override=True)


# 占位工具
@tool
def lookup_policy(topic: str) -> str:
    """查询公司制度摘要。"""
    return "差旅报销需在返程 7 日内提交。"


# 注册拦截器用于观察请求对象
@wrap_model_call
def inspect_request(request: ModelRequest, handler):
    # dir() 列出所有公开属性,过滤掉下划线开头的私有成员
    print("字段:", [a for a in dir(request) if not a.startswith("_")])
    # state 的实际类型
    print("state 类型:", type(request.state).__name__)
    # state 里有哪些键
    print("state 键:", list(request.state.keys()))
    # 交还控制权
    return handler(request)


# 创建 Agent 并挂上观察器
agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    tools=[lookup_policy],
    middleware=[inspect_request],
    system_prompt="你是办公助手。",
)
# 触发一次调用
agent.invoke({"messages": [{"role": "user", "content": "报销流程?"}]})
输出(会打印两遍:模型调了一次工具,符合 §2.1):
字段: ['messages', 'model', 'model_settings', 'override', 'response_format',
       'runtime', 'state', 'system_message', 'system_prompt', 'tool_choice', 'tools']
state 类型: dict
state 键: ['messages']
常用字段:
| 字段 | 含义 | 常怎么用 |
|---|---|---|
model |
将要使用的聊天模型实例 | §7 里 override(model=...) |
tools |
本次暴露给模型的工具列表 | §6 里过滤 / 增补 |
system_prompt |
本次系统提示的纯字符串 | @dynamic_prompt 的返回值落在这里 |
system_message |
同一内容包装成的 SystemMessage 对象 |
override(system_message=...) 时用 |
messages |
本次送给模型的对话消息(不含 system) | 看最近用户话、轮数(也可用 state) |
state |
当前 Agent 状态,就是个普通 dict |
见下 |
runtime |
运行时对象 | 见下;读 context 走这里 |
response_format |
结构化输出配置(若有) | §7.2 |
tool_choice |
强制/限制模型选哪个工具 | 进阶 |
model_settings |
额外模型设置字典 | 进阶调参 |
system_prompt 和 system_message 是同一份内容的两种形态,实测对照:
system_prompt  = '我是静态提示。'
system_message = SystemMessage(content='我是静态提示。', additional_kwargs={}, response_metadata={})
(2)request.state:Agent 状态快照 #
state 是图里当前的 AgentState。上面实测过它就是普通 dict,下标和 .get() 都能用:
# 下标写法:键一定存在时用
messages = request.state["messages"]

# .get() 写法:带默认值更稳,state 被自定义扩展后尤其有用
messages = request.state.get("messages", [])
最常见、也最稳的键就是 messages。适合按「对话已经发生了什么」做决策:
| 读法 | 用途 |
|---|---|
len(request.state["messages"]) |
长对话换提示 / 换模型(§7) |
倒序找最近一条 HumanMessage |
按用户原话里的关键词改策略 |
是否已有 ToolMessage |
提示「已有工具结果,直接汇总」 |
注意三点:
request.state["messages"]与request.messages概念上都是对话侧消息;入门优先用state["messages"],和print(result["messages"])是同一条状态河。- 这个值在一次
invoke内会变。§2.1 实测过:第 1 次调模型时 1 条,第 2 次已是 3 条。凡按条数判断都要想到这一点。 state还可被自定义字段扩展(记忆、计数器等);本章先只用messages。更复杂的状态定制放到后续 Middleware / Memory 章节。
(3)request.runtime:运行时句柄 #
runtime 不是「又一份 messages」,而是这次执行环境的把手。入门最常用的是:
# 从运行时句柄里取出本次 invoke 传入的上下文对象
ctx = request.runtime.context
实测 runtime 上可用成员比文档常提的更多:
入门只需要认识三个:
runtime 上常见能力 |
含义 | 本章 |
|---|---|---|
context |
本次 invoke(..., context=...) 传入的对象 |
重点 |
store |
跨会话长期记忆存储 | 后续章节 |
stream_writer 等 |
流式进度、执行信息等 | 后续章节 |
记忆口诀:
state看「对话状态」;runtime.context看「这次是谁、什么角色」。
用户名、部门、租户、角色这类不是聊天记录本身的信息,应放进 context,别硬塞进 HumanMessage 假装用户说的。
(4)context_schema:给 context 做类型声明 #
只写 invoke(..., context=某个对象) 还不够:创建 Agent 时还要声明 context_schema=,告诉框架「上下文长什么样」。
from dataclasses import dataclass
from langchain.agents import create_agent
from langchain.agents.middleware import ModelRequest, wrap_model_call
from dotenv import load_dotenv

load_dotenv(override=True)


# 动态生成 system_prompt 的示例
@wrap_model_call
def office_prompt(request: ModelRequest, handler):
    """
    中间件:根据 context 里的 user_name 和 dept 动态生成 system_prompt
    """
    ctx = request.runtime.context
    # 根据上下文中的 user_name、dept 动态生成系统提示
    system_prompt = f"你是办公助手,为{ctx.dept}的{ctx.user_name}提供帮助。"
    # 覆盖系统提示
    updated = request.override(system_prompt=system_prompt)
    return handler(updated)


# 用 dataclass 声明 context 的结构
@dataclass
class OfficeContext:
    # 用户名,默认“同事”
    user_name: str = "同事"
    # 部门,默认“综合办”
    dept: str = "综合办"


# 简单模拟的工具函数
def lookup_policy(query: str) -> str:
    """
    工具函数:根据查询内容返回流程说明
    """
    if "报销" in query:
        return "报销流程:1. 提交申请;2. 审批;3. 财务打款。"
    return "未找到该流程。"


from langchain.tools import tool


@tool
def lookup_policy_tool(query: str) -> str:
    """
    查询并返回公司政策或流程信息
    """
    return lookup_policy(query)


# 创建 Agent,并声明 context 类型
agent = create_agent(
    model="deepseek:deepseek-v4-flash",  # 实际运行请确认相关依赖和模型
    tools=[lookup_policy_tool],
    middleware=[office_prompt],
    context_schema=OfficeContext,
    system_prompt="你是办公助手。",
)

# 调用时传入 context 示例
result = agent.invoke(
    {"messages": [{"role": "user", "content": "报销流程?"}]},
    context=OfficeContext(user_name="王敏", dept="财务部"),
)

# 输出结果
for i, msg in enumerate(result["messages"]):
    print(f"\n===== [{i}] {type(msg).__name__} =====")
    content = getattr(msg, "content", None)
    if content:
        print("内容:", content)
    tool_calls = getattr(msg, "tool_calls", None)
    if tool_calls:
        print("工具调用:", tool_calls)
对应关系:
context_schema=OfficeContext   →  规定 context 的类型 / 结构
invoke(..., context=实例)      →  本次真正传入的值
request.runtime.context        →  middleware 里读到的同一个实例
坑:忘了传 context 时,dataclass 默认值不会生效。
这一点很容易想错。看到 OfficeContext 字段都写了默认值(user_name: str = "同事"),很自然以为不传 context 时框架会构造默认实例。实测是:
from dataclasses import dataclass
from langchain.agents import create_agent
from langchain.agents.middleware import ModelRequest, wrap_model_call
from dotenv import load_dotenv

load_dotenv(override=True)


@wrap_model_call
def check_no_ctx(request: ModelRequest, handler):
    # 直接打印 context 本身
    print(f"context = {request.runtime.context!r}")
    # 用 getattr 带默认值读取
    print(f"getattr 取值: {getattr(request.runtime.context, 'user_name', '默认值')!r}")
    # 交还控制权
    return handler(request)


# 用 dataclass 声明 context 的结构
@dataclass
class OfficeContext:
    # 用户名,默认“同事”
    user_name: str = "同事"
    # 部门,默认“综合办”
    dept: str = "综合办"


# 简单模拟的工具函数
def lookup_policy(query: str) -> str:
    """
    工具函数:根据查询内容返回流程说明
    """
    if "报销" in query:
        return "报销流程:1. 提交申请;2. 审批;3. 财务打款。"
    return "未找到该流程。"


from langchain.tools import tool


@tool
def lookup_policy_tool(query: str) -> str:
    """
    查询并返回公司政策或流程信息
    """
    return lookup_policy(query)


# 创建 Agent,并声明 context 类型
agent = create_agent(
    model="deepseek:deepseek-v4-flash",  # 实际运行请确认相关依赖和模型
    tools=[lookup_policy_tool],
    middleware=[check_no_ctx],
    context_schema=OfficeContext,
    system_prompt="你是办公助手。",
)

# 调用时传入 context 示例
result = agent.invoke({"messages": [{"role": "user", "content": "报销流程?"}]})

# 输出结果
for i, msg in enumerate(result["messages"]):
    print(f"\n===== [{i}] {type(msg).__name__} =====")
    content = getattr(msg, "content", None)
    if content:
        print("内容:", content)
    tool_calls = getattr(msg, "tool_calls", None)
    if tool_calls:
        print("工具调用:", tool_calls)
输出:
context = None
getattr 取值: '默认值'
context 整个是 None,不是带默认字段的 OfficeContext 实例。因此:
request.runtime.context.user_name会直接AttributeError: 'NoneType' object has no attribute 'user_name'getattr(ctx, "user_name", "同事")才安全——这就是本章所有示例都用getattr加默认值的原因- dataclass 里的默认值只在你自己构造实例时生效,例如
OfficeContext()或OfficeContext(role="support")
另外注意:
context是invoke的关键字参数,不要放进{"messages": ...}字典里- 常用
@dataclass定义;字段保持简单(str/bool等)即可 - §6 按角色过滤工具、§8 办公助理,用的都是同一套
context_schema机制
读完这四块,下面示例就是「用 runtime.context 填动态提示」;§6 / §7 则改成读 context / state,再 override(tools=...) 或 override(model=...)。
5.2. dynamic_prompt.py #
# 从 dataclasses 导入 dataclass 装饰器
from dataclasses import dataclass
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# dynamic_prompt 是动态提示装饰器,ModelRequest 是请求类型
from langchain.agents.middleware import dynamic_prompt, ModelRequest
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 用 dataclass 定义上下文结构
@dataclass
class OfficeContext:
    # 类说明
    """每次调用可传入的上下文字段。"""

    # 用户名,默认值只在你手动构造实例时生效
    user_name: str = "同事"
    # 部门
    dept: str = "综合办"


# 注册制度查询工具
@tool
# 入参为主题
def lookup_policy(topic: str) -> str:
    # 工具描述
    """查询公司制度摘要。"""
    # 演示用固定返回
    return "差旅报销需在返程 7 日内提交。"


# @dynamic_prompt 把函数注册成「每次调模型前生成系统提示」
@dynamic_prompt
# 签名固定:接收 ModelRequest,返回字符串
def office_prompt(request: ModelRequest) -> str:
    # 函数说明
    """根据 context 生成系统提示。"""
    # 从运行时句柄取出本次传入的上下文(可能是 None)
    ctx = request.runtime.context
    # 用 getattr 带默认值读取,防止 ctx 为 None 时崩掉
    name = getattr(ctx, "user_name", "同事")
    # 同样安全地读取部门
    dept = getattr(ctx, "dept", "部门")
    # 把上下文拼进提示模板并返回
    return (
        f"你是 {dept} 的办公助手,正在帮助 {name}。"
        "回答简洁;问制度时调用 lookup_policy;不要编造条文。"
    )


# 创建 Agent
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 工具列表
    tools=[lookup_policy],
    # 动态提示由 middleware 提供;这里可不写静态 system_prompt
    middleware=[office_prompt],
    # 声明 context 的类型,否则传 context 时框架不知道怎么处理
    context_schema=OfficeContext,
)

# 调用时通过 context= 关键字参数传入本次的上下文实例
result = agent.invoke(
    # 第一个位置参数仍是消息字典
    {"messages": [{"role": "user", "content": "报销流程是什么?"}]},
    # context 是独立的关键字参数,不要塞进上面的字典
    context=OfficeContext(user_name="王敏", dept="财务部"),
)
# 打印最终回答
print(result["messages"][-1].content)
输出:
根据制度,差旅报销需在**返程后 7 日内提交**。如需了解更详细的报销步骤(如单据要求、审批节点等),
请告诉我具体场景,我可以再为您查询。
动态系统提示写在「发给模型的那一次请求」上,不会写进 Agent 状态里的 messages。
可以看成:
状态 messages(你 print 看到的)
  [Human] 报销流程是什么?
  [AI] tool_calls...
  [Tool] ...
  [AI] 最终回答

每次真正调用 LLM 时,框架会临时拼一包请求:
  system_message ← office_prompt 生成的那段   ← 在这里注入
  + 当前状态里的 messages
  + tools schema
        │
        ▼
     发给 DeepSeek
5.3. 动态提示会「覆盖」静态提示,不是合并 #
同时配置静态 system_prompt 和 @dynamic_prompt,然后在下游拦截器里看最终值:
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 导入动态提示装饰器、请求类型、模型调用拦截器
from langchain.agents.middleware import ModelRequest, dynamic_prompt, wrap_model_call
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 加载环境变量
load_dotenv(override=True)


# 占位工具
@tool
def lookup_policy(topic: str) -> str:
    """查询公司制度摘要。"""
    return "差旅报销需在返程 7 日内提交。"


# 动态提示,返回一段带标记的文本
@dynamic_prompt
def office_prompt(request: ModelRequest) -> str:
    # 返回值会成为本次的 system_prompt
    return "【动态提示】你是动态助手。"


# 放在动态提示之后(内层),用于观察最终生效的值
@wrap_model_call
def capture_final(request: ModelRequest, handler):
    # 打印此刻请求里的系统提示
    print(f"最终 system_prompt: {request.system_prompt!r}")
    # 交还控制权
    return handler(request)


# 同时给静态提示和动态提示
agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    tools=[lookup_policy],
    # 静态提示
    system_prompt="【静态提示】你是静态助手。",
    # 动态提示在前(外层),观察器在后(内层)
    middleware=[office_prompt, capture_final],
)
# 触发一次调用
agent.invoke({"messages": [{"role": "user", "content": "报销流程?"}]})
输出:
最终 system_prompt: '【动态提示】你是动态助手。'静态那段被完全丢弃,没有拼接、也不会前后相连。因此:
| 配置 | 结果 |
|---|---|
只有 system_prompt |
用静态的 |
只有 @dynamic_prompt |
用动态的 |
| 两者都有 | 用动态的,静态的失效 |
这解释了一个常见困惑:「我在 system_prompt 里加了一条禁令,怎么完全没用?」——因为项目里还挂着 @dynamic_prompt,把它整段盖掉了。
实践建议:二选一。若确实需要「一段不变总原则 + 一段随人变化的内容」,应把不变部分写进动态函数模板,由它返回完整提示:
# 把固定原则和动态内容都放进动态函数,统一返回
@dynamic_prompt
def office_prompt(request: ModelRequest) -> str:
    # 安全读取上下文
    ctx = request.runtime.context
    # 带默认值取用户名
    name = getattr(ctx, "user_name", "同事")
    # 固定部分:所有人共享的总原则,写成常量便于维护
    base = "回答简洁、有依据;禁止编造事实。"
    # 动态部分 + 固定部分拼成完整提示
    return f"你是办公助手,正在帮助 {name}。{base}"
另外注意(与 §5.1 对照):
- 传
context=...时,要在create_agent声明context_schema(类型常用@dataclass) context传在invoke的关键字参数上,不是塞进messages- 动态提示写进
ModelRequest.system_prompt(请求侧),不会出现在result["messages"]里 - 忘记传
context时runtime.context是None,函数里必须用getattr(..., 默认值) - 第 10 章还会用 middleware 做护栏;这里先把它当成「可插拔策略点」即可
6. 动态选工具 #
并非每次调用都该暴露全部工具。模型「看不见」的工具,一般就不会选——比单纯在提示里写「不要查订单」可靠得多。
典型分层:
- 普通员工:天气、计算、制度
- 客服坐席:再开放查单
- 管理员:再开放更危险的操作(本章仍用模拟;真危险操作见第 10 章 HITL)
推荐做法:预注册 + 按请求过滤。
create_agent(tools=[全部可能用到的工具])
        │
        ▼
wrap_model_call:按 role 从 request.tools 里删掉本次不该看见的
        │
        ▼
模型只在「可见子集」里选型
这比「运行时凭空长出未知工具」更简单,也不易踩「ToolNode 不认识该工具」的坑。
两种动态不要混:
| 模式 | 做法 | 难度 |
|---|---|---|
| 过滤 | 工具已在 tools=[...];middleware 收窄 request.tools |
低 |
| 新增 | wrap_model_call 把新工具加进列表,且 wrap_tool_call 能执行它 |
较高 |
若必须在运行时新增未预注册工具,需要同时做到:
wrap_model_call里request.override(tools=[...])暴露给模型wrap_tool_call里能执行该工具
官方说明见 Tools · Dynamic tools。入门优先「预注册 + 过滤」。
软硬约束一起用:
- 硬:过滤掉
lookup_order→ 模型无法发起该tool_call - 软:系统提示写「无客服权限时说明原因,不要编造」
6.1. dynamic_tools.py #
# 从 dataclasses 导入 dataclass 装饰器
from dataclasses import dataclass

# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# wrap_model_call 是模型调用拦截装饰器,ModelRequest 是请求类型
from langchain.agents.middleware import wrap_model_call, ModelRequest

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 定义上下文,只需要一个角色字段
@dataclass
class OfficeContext:
    # 说明可选取值
    """role: employee | support"""

    # 角色,默认普通员工
    role: str = "employee"


# 所有人可见的天气工具
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    return f"{city} 晴,25°C。"


# 所有人可见的制度工具
@tool
def lookup_policy(topic: str) -> str:
    """查询制度摘要。"""
    return "请假需提前申请。"


# 仅客服可见的查单工具
@tool
def lookup_order(order_id: str) -> str:
    """查询订单状态(客服专用)。"""
    return f"订单 {order_id}:运输中。"


# 按角色过滤本次暴露给模型的工具:用 wrap_model_call 在每次模型调用前拦截请求
@wrap_model_call
# 定义按角色过滤工具的中间件函数
def filter_tools_by_role(request: ModelRequest, handler):
    # 从运行时上下文读取角色;context 可能是 None,所以用 getattr 带默认值
    role = getattr(request.runtime.context, "role", "employee")
    # 复制当前请求中的工具列表,避免直接修改原列表
    tools = list(request.tools)
    # 若角色不是客服,则需要收窄本次可见工具
    if role != "support":
        # 普通员工看不到查单工具:按 name 过滤掉 lookup_order
        tools = [t for t in tools if getattr(t, "name", None) != "lookup_order"]
    # 打印本次实际可见的工具,便于验证过滤是否生效
    print(f"  [middleware] role={role}, 可见工具={[getattr(t, 'name', t) for t in tools]}")
    # 用覆盖后的工具列表继续交给后续 handler 处理
    return handler(request.override(tools=tools))


# 创建 Agent
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 预注册全部工具;可见性由 middleware 控制
    tools=[get_weather, lookup_policy, lookup_order],
    # 挂上过滤器
    middleware=[filter_tools_by_role],
    # 声明上下文类型
    context_schema=OfficeContext,
    # 软约束:告诉模型没权限时该怎么说
    system_prompt=(
        "你是助手。只用当前可用的工具回答。"
        "没有查单工具时,请说明需客服权限,不要编造订单状态。"
    ),
)

# 员工角色:不应成功查单
r1 = agent.invoke(
    # 同一句提问
    {"messages": [{"role": "user", "content": "帮我查订单 A1001"}]},
    # 传入员工角色
    context=OfficeContext(role="employee"),
)
# 打印员工路径的最终回答
print("员工:", r1["messages"][-1].content)

# 客服角色:可以查单
r2 = agent.invoke(
    # 完全相同的提问
    {"messages": [{"role": "user", "content": "帮我查订单 A1001"}]},
    # 只把角色换成客服
    context=OfficeContext(role="support"),
)
# 打印客服路径的最终回答
print("客服:", r2["messages"][-1].content)
这是本章最重要的对照实验,两条轨迹放一起看:
员工路径(只有 2 条消息,一次工具调用都没发生):
  [middleware] role=employee, 可见工具=['get_weather', 'lookup_policy']
  [0] HumanMessage: '帮我查订单 A1001'
  [1] AIMessage: '抱歉,我目前没有查询订单的工具和权限。要查询订单 A1001 的状态,需要客服权限。
请您联系人工客服,或前往订单页面自行查看。'客服路径(4 条消息,工具正常执行):
  [middleware] role=support, 可见工具=['get_weather', 'lookup_policy', 'lookup_order']
  [middleware] role=support, 可见工具=['get_weather', 'lookup_policy', 'lookup_order']
  [0] HumanMessage: '帮我查订单 A1001'
  [1] AIMessage: ''
       -> lookup_order({'order_id': 'A1001'})
  [2] ToolMessage: '订单 A1001:运输中。'
  [3] AIMessage: '订单 **A1001** 当前状态为:**运输中**。如有其他需要,随时告诉我。'
三个观察:
- 员工路径连
tool_calls都没有。 这就是「硬约束」——不是模型选择不调用,而是工具清单里根本没有lookup_order,无从选。相比「在提示里写不要查订单」,这种方式不依赖模型服从度。 - 员工路径 middleware 只跑 1 次,客服路径跑 2 次。 正好印证 §2.1:没有工具调用只需 1 次模型调用;有工具调用则要 2 次。次数差异本身就是「工具有没有被调用」的快速信号。
- 同一句话、同一个 Agent,只换
context里一个字段,行为就完全不同。 这正是本章要证明的:不必为每个角色复制一套 Agent。
对照验证(比只看最终文案更可靠):
- 打印两趟轨迹里的
tool_calls - 员工路径不应出现
lookup_order - 客服路径应出现
lookup_order,且最终依据 ToolMessage
最后强调 wrap_model_call 的固定写法:改完 request 后必须 return handler(...)。忘了会怎样?实测一下:
# 反面示例:调用了 handler 但没有 return
@wrap_model_call
def forget_return(request: ModelRequest, handler):
    # 调用了下一层,但结果没有返回出去
    handler(request)
    # 函数隐式返回 None
AttributeError: 'NoneType' object has no attribute 'result'报错点在框架内部,信息也不直白——看到 'NoneType' object has no attribute 'result' 时,第一反应应去查每个 middleware 是否都 return 了。
6.2. wrap_tool_call:工具执行侧的钩子 #
§6.1 的过滤只改「模型能看见哪些工具」。
工具一旦被模型选中,真正执行走的是另一条链路——这里可以挂 @wrap_tool_call。
两个钩子别混:
| 钩子 | 拦截时机 | 典型用途 |
|---|---|---|
@wrap_model_call |
调模型前 | 改提示、过滤/增补 tools、换 model |
@wrap_tool_call |
执行某个 tool_call 时 | 执行动态新增的工具、统一捕获异常、改写工具结果 |
模型发出 tool_calls
        │
        ▼
@wrap_tool_call(可 override 用哪个 tool / 自己返回 ToolMessage)
        │
        ▼
默认 handler:执行工具 → ToolMessage
        │
        ▼
结果回灌 messages,再进入下一轮模型调用
签名形态与 wrap_model_call 类似,但请求类型是 ToolCallRequest:
@wrap_tool_call
def my_hook(request: ToolCallRequest, handler):
    # request.tool_call → {"name", "args", "id", ...}
    # request.tool      → 当前解析到的工具对象(可能为 None)
    return handler(request)  # 或 handler(request.override(tool=...)) / 直接返回 ToolMessage
同样必须把控制权交还给链路:要么 return handler(...),要么自己构造并 return ToolMessage(...)。
6.2.1. 两种常见用法 #
用法 A:动态「新增」未预注册工具(与 wrap_model_call 成对)
只在 wrap_model_call 里把工具塞进 request.tools,而没在执行侧安排它 → 框架会直接拒绝。
因此要同时:
wrap_model_call:override(tools=[*request.tools, new_tool])让模型看见wrap_tool_call:当tool_call["name"]匹配时,override(tool=new_tool)让执行侧找得到
用法 B:工具错误兜底(第 8 章已练过)
try: return handler(request),except 时返回带错误说明的 ToolMessage。
本章示例聚焦用法 A;用法 B 复习见第 8 章 §9.3。
入门仍优先「预注册 + 过滤」(§6.1)。只有工具来自 MCP / 插件目录 / 按租户动态发现时,再上用法 A。MCP 接法见第 17 章:先 get_tools() 拿列表,再预注册进 create_agent;不必一上来就走「执行时才存在」那条动态路。
少写一半会怎样:这是预检失败,不是执行失败 #
这里要纠正一个常见误解。直觉上会以为流程是「模型看到工具 → 选中它 → 执行时才发现没人认识它」,所以只有模型真调用了才会出错。
实际不是。框架在调模型之前就会校验 request.tools 里每个工具是否都能执行。
实测:只挂 wrap_model_call、不挂 wrap_tool_call,再问一句完全用不到那个工具的话(「你好,今天几号?」),照样立刻报错:
ValueError:
中间件添加了 Agent 无法执行的工具。

未知工具: ['calculate_tip']
已注册工具: ['get_weather']

出现该问题的原因是:中间件在 `wrap_model_call` 里修改了 `request.tools`,加入了没有传递给 `create_agent()` 的工具。

修复方法如下:

方案 1:在创建 Agent 时注册工具(大多数场景推荐)
    将工具传递给 `create_agent(tools=[...])`,或设置在 `middleware.tools`。
    这样所有 Agent 调用都会自动拥有这些工具。

方案 2:在中间件中处理动态工具(适用于运行时才有的工具)
    在 `wrap_tool_call` 里实现对动态添加工具的执行逻辑:

    class MyMiddleware(AgentMiddleware):
        def wrap_tool_call(self, request, handler):
            if request.tool_call["name"] == "dynamic_tool":
                # 你可以自己执行动态工具,也可以用 tool 实例覆盖
                return handler(request.override(tool=my_dynamic_tool))
            return handler(request)
这个设计其实很体贴:
- 失败「响亮」且即时,不会潜伏到某个罕见分支才炸
- 错误信息直接给出两条修法,连示例代码都写好了
- 同时也说明:
Option 1才是官方推荐的默认路径,也就是 §6.1 的「预注册 + 过滤」
所以本节写法的定位是:只在工具确实要到运行时才存在时才用(MCP 服务发现、按租户加载插件、用户自定义函数)。工具集合固定时,一律走 §6.1。
6.2.2. dynamic_add_tool.py #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 一次导入模型侧与工具侧两个钩子,以及请求类型
from langchain.agents.middleware import ModelRequest, wrap_model_call, wrap_tool_call
# ToolCallRequest 描述一次待执行的工具调用
from langchain.tools.tool_node import ToolCallRequest
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# ---------- 静态预注册:创建 Agent 时就有 ----------
# 这个工具会正常传给 create_agent
@tool
def get_weather(city: str) -> str:
    """查询城市天气。"""
    # 返回模拟天气
    return f"{city} 晴,25°C(模拟)。"


# ---------- 动态工具:不放进 create_agent(tools=...) ----------
# 这个工具只靠 middleware 挂上,模拟「运行时才发现的工具」
@tool
def calculate_tip(bill_amount: float, tip_percentage: float = 20.0) -> str:
    """根据账单金额与小费比例计算应付小费与总计。"""
    # 按百分比算出小费
    tip = bill_amount * (tip_percentage / 100)
    # 账单加小费得到总计
    total = bill_amount + tip
    # 保留两位小数返回
    return f"小费 {tip:.2f},总计 {total:.2f}(模拟)。"


# 1) 调模型前:把动态工具临时加入可见列表
@wrap_model_call
def expose_dynamic_tools(request: ModelRequest, handler):
    # 用解包语法把原有工具和动态工具拼成新列表;也可按 context 决定加不加
    updated = request.override(tools=[*request.tools, calculate_tip])
    # 带着新请求继续往内层走
    return handler(updated)


# 2) 执行工具时:若是动态工具,指定用哪个 tool 对象执行
@wrap_tool_call
def execute_dynamic_tools(request: ToolCallRequest, handler):
    # 检查本次要执行的工具名是否是那个动态工具
    if request.tool_call.get("name") == "calculate_tip":
        # 用 override(tool=...) 明确告诉执行侧该用哪个对象
        return handler(request.override(tool=calculate_tip))
    # 其它(预注册)工具走默认逻辑
    return handler(request)


# 创建 Agent
agent = create_agent(
    # 模型标识
    model="deepseek:deepseek-v4-flash",
    # 注意:这里只有 get_weather;calculate_tip 靠 middleware 动态挂上
    tools=[get_weather],
    # 两个钩子必须成对出现,缺一个就会预检失败
    middleware=[expose_dynamic_tools, execute_dynamic_tools],
    # 提示里点名两个工具的用途
    system_prompt=(
        "你是助手。查天气用 get_weather;算小费用 calculate_tip。"
        "不要心算小费。"
    ),
)

# 应能调到未预注册的 calculate_tip
result = agent.invoke(
    {
        # 输入是带 messages 键的字典
        "messages": [
            # 一句需要算小费的话
            {"role": "user", "content": "账单 85 元,按 20% 算小费和总计。"}
        ]
    }
)

# 遍历轨迹确认动态工具真的被执行了
for i, msg in enumerate(result["messages"]):
    # 打印序号与消息类型
    print(f"\n===== [{i}] {type(msg).__name__} =====")
    # 安全取 content
    content = getattr(msg, "content", None)
    # 非空才打印
    if content:
        print("content:", content)
    # 安全取 tool_calls
    tool_calls = getattr(msg, "tool_calls", None)
    # 有则打印
    if tool_calls:
        print("tool_calls:", tool_calls)
真实轨迹:
[0] HumanMessage: '账单 85 元,按 20% 算小费和总计。'
[1] AIMessage: ''
     -> calculate_tip({'bill_amount': 85, 'tip_percentage': 20})
[2] ToolMessage: '小费 17.00,总计 102.00(模拟)。'
[3] AIMessage: '账单 85 元,按 20% 计算:\n\n- 小费:17.00 元\n- 总计:102.00 元'
一个从未出现在 create_agent(tools=...) 里的工具,被模型正常选中并执行了。
跑完后重点确认:
- 轨迹里出现
calculate_tip的tool_calls - 有对应
ToolMessage(说明wrap_tool_call执行成功) - 若删掉
execute_dynamic_tools只留expose_dynamic_tools,会立刻抛上一节那个ValueError——注意是在调模型之前就失败,不是等模型选中它才失败
也可把两个钩子收进同一个 AgentMiddleware 子类(官方动态工具示例常见写法,上面的错误信息就是这种形式);装饰器版拆开更直观,便于入门对照。
和 §6.1 怎么选:
| 场景 | 更合适 |
|---|---|
| 工具集合固定,只是按角色开关 | 预注册 + wrap_model_call 过滤(§6.1) |
| 工具运行时才发现 / 按租户加载 | wrap_model_call 暴露 + wrap_tool_call 执行(本节) |
| 工具会抛未预期异常 | wrap_tool_call 做 try/except 兜底(第 8 章) |
7. 动态选模型 #
长对话、高风险、复杂推理时,可能想换更稳 / 更强的模型;简单寒暄则用更快更便宜的配置。
这和「动态选工具」同一插槽:@wrap_model_call + request.override(model=...)。
典型触发条件(按业务选,不必全上):
| 信号 | 可能策略 |
|---|---|
messages 很长 |
换更强模型,或先摘要(摘要中间件见后续章节) |
| 用户说「仔细分析 / 写方案」 | 换更强 / 更稳配置 |
| 仅寒暄、查单号 | 留在快模型 |
| 高风险工具即将可用 | 换更稳模型(仍建议配合第 10 章 HITL) |
DeepSeek 同时提供 deepseek-v4-flash(快)和 deepseek-v4-pro(强),正好能做真实分流演示——不必靠调 temperature 假装换模。
7.1. dynamic_model.py #
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent

# wrap_model_call 是模型调用拦截装饰器,ModelRequest 是请求类型
from langchain.agents.middleware import wrap_model_call, ModelRequest

# init_chat_model 用于显式构造模型实例
from langchain.chat_models import init_chat_model

# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 一个简单工具,用于观察换模后工具是否仍正常绑定
@tool
def calculate(a: float, b: float) -> str:
    """计算 a+b。"""
    # 返回字符串,保持工具返回类型一致
    return str(a + b)


# 默认档:快模型,temperature=0 保证结果稳定
fast_model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
# 升级档:强模型,用于长对话或复杂推理
careful_model = init_chat_model("deepseek:deepseek-v4-pro", temperature=0.3)

# 用列表记录每次实际选中的模型,便于验证策略生效
picked = []


# 用 wrap_model_call 在每次模型调用前拦截请求,以便动态切换模型
@wrap_model_call
# 定义按消息长度选择模型的中间件函数
def pick_model(request: ModelRequest, handler):
    # 文档字符串:说明消息变长时切换到 careful_model
    """消息变长时切换到 careful_model。"""
    # 统计当前状态中的消息条数,缺省为空列表
    n = len(request.state.get("messages", []))
    # 消息超过 6 条时用 careful_model,否则用 fast_model
    model = careful_model if n > 6 else fast_model
    # 记录本次的条数与选中的模型名
    picked.append((n, getattr(model, "model_name", "?")))
    # 用覆盖后的模型继续交给后续 handler 处理
    return handler(request.override(model=model))


# 创建 Agent
agent = create_agent(
    # 这里的模型只是默认值,会被 middleware 覆盖
    model=fast_model,
    # 工具列表
    tools=[calculate],
    # 挂上选模型的中间件
    middleware=[pick_model],
    # 引导模型调用工具而不是心算
    system_prompt="你是计算助手。加减法请调用 calculate。",
)

# 场景一:短对话,应留在快模型
result = agent.invoke({"messages": [{"role": "user", "content": "17+25 等于多少?"}]})
# 打印本轮的选型记录
print("短对话选型:", picked)
# 打印回答
print("回答:", result["messages"][-1].content)

# 清空记录,准备第二个场景
picked.clear()

# 场景二:手工造一段长对话,触发换模
long_msgs = []
# 造 4 轮一问一答,共 8 条消息
for i in range(4):
    # 追加一条用户消息
    long_msgs.append({"role": "user", "content": f"第{i}个问题:你好"})
    # 追加一条助手消息
    long_msgs.append({"role": "assistant", "content": f"第{i}个回答:你好"})
# 最后再追加一条真正要处理的问题
long_msgs.append({"role": "user", "content": "现在算一下 17+25"})

# 用长对话调用
r2 = agent.invoke({"messages": long_msgs})
# 打印本轮的选型记录
print("长对话选型:", picked)
# 打印回答
print("回答:", r2["messages"][-1].content)
输出:
短对话选型: [(1, 'deepseek-v4-flash'), (3, 'deepseek-v4-flash')]
回答: 17+25 等于 **42**。

长对话选型: [(9, 'deepseek-v4-pro'), (11, 'deepseek-v4-pro')]
回答: 17 + 25 = 42
策略确实生效了:1 条、3 条消息时用快模型,9 条、11 条时自动升级到强模型。
这份输出顺便也印证了 §2.1——每个场景里 middleware 都跑了 2 次(一次工具调用需两次模型调用)。由此有个边界:若阈值设成 2,同一次 invoke 里第一次会用快模型、第二次就换成强模型。跨模型续接对话通常没问题;若依赖输出高度一致(如严格格式约定),把阈值设得离常见消息条数远一些更稳。
注意:
create_agent(model=fast_model)里的模型是默认值;middleware 可在单次请求覆盖- 传给
override的建议是未预先bind_tools的裸模型实例,让 Agent 自己绑工具。实测传预绑定模型这个版本没报错,但官方 Dynamic model 文档明确建议传裸实例——尤其同时开了response_format时,照建议做能省掉一类难查的问题 - 真正按成本 / 能力分流时,除了消息条数,还可看用户原话里的关键词(练习 3)或即将可用的工具风险等级
- 换模型不是万灵药:选错工具往往是提示和工具描述的问题,换更强模型可能只是把问题盖过去
7.2. Agent 层 response_format(与第 6 章衔接) #
第 6 章在模型层用 with_structured_output;Agent 里等价参数是 response_format。
适合「既要工具循环,又要最终产出固定 schema」——例如办公助理查完订单后,还要返回可入库的结构化摘要。
| 模型层 | Agent 层 | |
|---|---|---|
| API | model.with_structured_output(Schema) |
create_agent(..., response_format=...) |
| 结果 | 调用返回值 | result["structured_response"] |
| 与工具共存 | 通常分开两条链 | 同一 Agent 可同时带 tools |
DeepSeek 应显式用 ToolStrategy(Schema)(见第 6 章 §9),并关闭 thinking,避免与 tool calling 冲突:
# 从 typing 导入 Literal,用于把状态限制为固定枚举
from typing import Literal
# 从 pydantic 导入 BaseModel 与 Field
from pydantic import BaseModel, Field
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# ToolStrategy 让结构化输出走 tool calling 通道
from langchain.agents.structured_output import ToolStrategy
# init_chat_model 用于传 extra_body 关闭 thinking
from langchain.chat_models import init_chat_model
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# 定义最终产出的结构,供程序直接消费
class OrderBrief(BaseModel):
    # 类 docstring 会成为 schema 描述,模型能看到
    """订单查询结果摘要,供程序消费。"""

    # 订单号,必填
    order_id: str = Field(description="订单号")
    # 状态用 Literal 锁定取值,避免模型自由发挥
    status: Literal["待发货", "已发货", "已完成", "未知"] = Field(description="状态")
    # 给人看的一句话,这才是真正的「自然语言回答」
    one_line: str = Field(description="给用户看的一句话说明")


# 查单工具
@tool
def lookup_order(order_id: str) -> str:
    """查询订单状态(演示用固定数据)。"""
    # 演示用固定返回
    return f"订单 {order_id}:已发货,预计明天送达。"


# 显式构造模型实例,以便传 extra_body
model = init_chat_model(
    # 模型标识
    "deepseek:deepseek-v4-flash",
    # 结构化输出要稳定,温度设 0
    temperature=0,
    # 关键:关闭 thinking 模式,否则和 tool_choice 冲突
    extra_body={"thinking": {"type": "disabled"}},
)

# 创建带结构化终态的 Agent
agent = create_agent(
    # 传入上面构造好的模型实例
    model=model,
    # 工具照常挂载,工具循环仍然工作
    tools=[lookup_order],
    # response_format 指定最终产出的 schema;handle_errors 让校验失败可重试
    response_format=ToolStrategy(OrderBrief, handle_errors=True),
    # 提示里强调字段必须来自工具返回
    system_prompt="先查订单再摘要;字段只依据工具返回,不要编造。",
)

# 正常调用
result = agent.invoke(
    {"messages": [{"role": "user", "content": "帮我查 A1002 并给个摘要。"}]}
)
# 结构化结果在 structured_response 键里,是一个 OrderBrief 实例
print(result["structured_response"])
# 给人看的文案应从结构化字段里取,而不是取 messages[-1]
print(result["structured_response"].one_line)
输出:
order_id='A1002' status='已发货' one_line='订单 A1002 已发货,预计明天送达。'
订单 A1002 已发货,预计明天送达。
容易踩的坑:开了 response_format 后,messages[-1] 不再是给用户的自然语言回答。
完整轨迹如下:
[0] HumanMessage: '帮我查 A1002 并给个摘要。'
[1] AIMessage: ''
     -> lookup_order({'order_id': 'A1002'})
[2] ToolMessage: '订单 A1002:已发货,预计明天送达。'
[3] AIMessage: ''
     -> OrderBrief({'order_id': 'A1002', 'status': '已发货', 'one_line': '订单 A1002 已发货,预计明天送达。'})
[4] ToolMessage: "Returning structured response: order_id='A1002' status='已发货'
                 one_line='订单 A1002 已发货,预计明天送达。'"
两个值得留意的机制:
- schema 是当成「工具」交给模型的。 看
[3],模型发起的tool_calls名字就叫OrderBrief——这就是ToolStrategy:借用 tool calling 通道拿结构化数据。这也解释了为何必须关掉 thinking:它和tool_choice不兼容。 - 最后一条消息是
ToolMessage,内容是框架生成的Returning structured response: ...,不是模型写给用户的话。所以print(result["messages"][-1].content)会打出这段内部文本,直接展示给用户就出洋相了。
正确取值方式:
| 要什么 | 从哪取 |
|---|---|
| 程序要消费的结构化数据 | result["structured_response"] |
| 给用户展示的自然语言 | 在 schema 里专门设一个字段(如 one_line),从 structured_response.one_line 取 |
| 调试用的完整过程 | 遍历 result["messages"] |
这也是上面 OrderBrief 特意加 one_line 的原因——不是冗余,而是开了 response_format 后拿到人类可读文案的正规途径。
忘了关 thinking 会怎样? 实测报错很明确:
BadRequestError: Error code: 400 - {'error': {'message': 'Thinking mode does not support
this tool_choice', 'type': 'invalid_request_error', ...}}
与 middleware 组合时注意:
response_format与动态换模:换进去的模型实例建议不要预先bind_tools(§7.1 已说明)- 验收:程序读
structured_response;给人看的文案读 schema 里的专用字段;调试仍建议打印完整轨迹 - 更完整的 schema 设计与
handle_errors策略见第 6 章
8. 实战:多工具办公助理 #
把第 8 章工具包 + 本章系统提示 / 动态策略拼成可演示助理。
目标不是再堆新工具,而是证明:同一套工具底盘,靠 context + middleware 就能切出不同行为。
能力清单:
| 能力 | 工具 | 可见角色 |
|---|---|---|
| 查天气 | get_weather |
employee / support |
| 四则运算 | calculate |
employee / support |
| 查制度 | lookup_policy |
employee / support |
| 查订单 | lookup_order |
仅 support |
外加:按 user_name / dept / role 动态系统提示。
组装关系:
ALL_TOOLS(预注册)
    + dynamic_prompt(人设 / 路由 / 禁令)
    + wrap_model_call(按 role 过滤工具)
    + OfficeContext(每次 invoke 传入)
    → build_office_assistant()
8.1. office_assistant.py #
# 从 dataclasses 导入 dataclass 装饰器
from dataclasses import dataclass
# 从 typing 导入 Literal,用于锁定枚举取值
from typing import Literal

# 从 pydantic 导入 BaseModel、Field,用于声明工具入参
from pydantic import BaseModel, Field
# 从 langchain.agents 导入 create_agent
from langchain.agents import create_agent
# 一次导入动态提示、模型调用拦截器与请求类型
from langchain.agents.middleware import dynamic_prompt, wrap_model_call, ModelRequest
# 从 langchain.tools 导入 tool 装饰器
from langchain.tools import tool
# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env 中的 API key
load_dotenv(override=True)


# ---------- 上下文 ----------
# 用 dataclass 定义每次调用传入的上下文结构
@dataclass
class OfficeContext:
    # 类说明
    """办公助理运行时上下文。"""

    # 用户姓名,用于动态提示
    user_name: str = "同事"
    # 部门,用于动态提示
    dept: str = "综合办"
    # employee:普通员工;support:客服(可查单)
    role: str = "employee"


# ---------- 模拟数据 ----------
# 模拟订单库
ORDERS = {
    # 已发货
    "A1001": {"status": "已发货", "eta_days": 2},
    # 运输中
    "A1002": {"status": "运输中", "eta_days": 1},
    # 已签收
    "A1003": {"status": "已签收", "eta_days": 0},
}

# 模拟制度库
POLICIES = {
    # 报销制度
    "报销": "差旅报销需在返程 7 日内提交,单笔超 1000 元需主管审批。",
    # 请假制度
    "请假": "年假提前 3 天申请;病假需当日同步直属上级。",
    # 加班制度
    "加班": "加班需事先在系统提交,月末统一调休或结算。",
}


# ---------- 工具 ----------
# 用 Pydantic 声明天气工具入参
class WeatherInput(BaseModel):
    # 类 docstring 成为 schema 描述
    """天气查询入参。"""

    # 必填字段:城市名
    city: str = Field(description="城市名,如北京、上海")
    # 选填字段:温度单位,用 Literal 限制取值并给默认值
    units: Literal["celsius", "fahrenheit"] = Field(
        # 默认摄氏度
        default="celsius",
        # 字段说明
        description="温度单位",
    )


# 挂上 Pydantic schema
@tool(args_schema=WeatherInput)
# 函数参数名要与 schema 字段一致
def get_weather(city: str, units: str = "celsius") -> str:
    # 描述里写明必须调用,压制模型凭常识编造
    """查询城市当前天气。用户问天气时必须调用,不要编造。"""
    # 按单位给出模拟温度
    temp = 26 if units == "celsius" else 79
    # 拼装返回文本
    return f"{city} 当前约 {temp}°({units}),晴间多云。"


# 用 description 覆盖描述,明确禁止心算
@tool(description="计算两个数的加减乘除。任何算术都请调用,不要心算。")
# op 用 Literal 锁定四个运算符,从结构上排除非法输入
def calculate(a: float, b: float, op: Literal["+", "-", "*", "/"]) -> str:
    # 已传 description,这句 docstring 对模型不可见
    """对 a、b 做四则运算。"""
    # 加法
    if op == "+":
        return str(a + b)
    # 减法
    if op == "-":
        return str(a - b)
    # 乘法
    if op == "*":
        return str(a * b)
    # 走到这里是除法,先挡住除零
    if b == 0:
        return "错误:除数不能为 0。"
    # 除法
    return str(a / b)


# 查单工具,仅客服角色可见
@tool
def lookup_order(order_id: str) -> str:
    # 描述里说明格式与适用角色
    """按订单号查询物流状态。订单号形如 A1001。客服角色可用。"""
    # 规范化输入,容忍大小写和空格
    key = order_id.strip().upper()
    # 用 .get() 避免 KeyError
    row = ORDERS.get(key)
    # 未命中时返回错误说明并给出可用示例,方便模型改口
    if not row:
        return f"错误:未找到订单 {order_id}。可用示例:A1001、A1002、A1003。"
    # 命中则拼装状态文本
    return f"订单 {key}:{row['status']},预计 {row['eta_days']} 天后相关节点完成。"


# 制度查询工具
@tool
def lookup_policy(topic: str) -> str:
    # 描述里列出可选主题
    """查询公司制度摘要。topic 可为:报销、请假、加班。"""
    # 遍历制度库做关键词包含匹配
    for key, text in POLICIES.items():
        # 主题含关键词即命中,能容忍「报销流程」这类问法
        if key in topic:
            return text
    # 全部未命中时返回错误说明与可选项
    return "错误:未匹配到制度。请尝试:报销 / 请假 / 加班。"


# 把全部工具预注册到一个列表,可见性交给 middleware 控制
ALL_TOOLS = [get_weather, calculate, lookup_order, lookup_policy]


# ---------- 动态策略 ----------
# 按上下文生成系统提示
@dynamic_prompt
def office_prompt(request: ModelRequest) -> str:
    # 取出本次上下文,可能为 None
    ctx = request.runtime.context
    # 安全读取姓名
    name = getattr(ctx, "user_name", "同事")
    # 安全读取部门
    dept = getattr(ctx, "dept", "综合办")
    # 安全读取角色
    role = getattr(ctx, "role", "employee")
    # 按角色给出不同的权限说明句(软约束,配合下面的硬过滤)
    role_line = (
        # 客服文案
        "你当前具备客服权限,可以查询订单。"
        # 三元表达式的条件
        if role == "support"
        # 员工文案:明确要求说明权限而不是编造
        else "你当前是员工助手:若用户要查订单,请说明需客服权限,不要编造状态。"
    )
    # 返回完整提示:人设 + 权限说明 + 路由表 + 禁令
    return f"""你是 {dept} 的办公助手,正在帮助 {name}。
{role_line}

工具策略:
- 天气 → get_weather
- 算术 → calculate(禁止心算)
- 制度 → lookup_policy
- 订单 → lookup_order(仅当该工具可用)

禁止编造天气、订单与制度。多项问题都要处理,最后统一简洁回答。"""


# 按角色硬过滤工具
@wrap_model_call
def filter_tools_by_role(request: ModelRequest, handler):
    # 安全读取角色
    role = getattr(request.runtime.context, "role", "employee")
    # 复制列表,不改动原对象
    tools = list(request.tools)
    # 非客服则移除查单工具
    if role != "support":
        # 按 name 过滤
        tools = [t for t in tools if getattr(t, "name", None) != "lookup_order"]
    # 用覆盖后的请求继续往内层走
    return handler(request.override(tools=tools))


# 用工厂函数封装组装过程,便于测试里复用
def build_office_assistant():
    # 函数说明
    """组装多工具办公助理。"""
    # 返回创建好的 Agent
    return create_agent(
        # 模型标识
        model="deepseek:deepseek-v4-flash",
        # 预注册全部工具
        tools=ALL_TOOLS,
        # 顺序说明见下文:过滤器在内层,动态提示在外层
        middleware=[office_prompt, filter_tools_by_role],
        # 声明上下文类型
        context_schema=OfficeContext,
    )


# 打印完整轨迹的小工具,本章反复用到
def print_trajectory(result) -> None:
    # 逐条遍历消息
    for i, msg in enumerate(result["messages"]):
        # 打印序号与类型
        print(f"\n===== [{i}] {type(msg).__name__} =====")
        # 安全取 content
        content = getattr(msg, "content", None)
        # 非空才打印
        if content:
            print("content:", content)
        # 安全取 tool_calls
        tool_calls = getattr(msg, "tool_calls", None)
        # 有则打印
        if tool_calls:
            print("tool_calls:", tool_calls)


# 只在直接运行本文件时执行演示
if __name__ == "__main__":
    # 组装助理
    agent = build_office_assistant()

    # 场景一:员工提组合问题,其中含一项越权请求
    print("======= 员工:组合问题(含越权查单)=======")
    r_emp = agent.invoke(
        {
            # 一句话涉及天气、制度、算术、查单四个意图
            "messages": [
                {
                    # 角色为用户
                    "role": "user",
                    # 最后那个「查下 A1001」是员工无权的
                    "content": "上海天气怎么样?报销怎么走?128+256等于多少?顺便查下 A1001。",
                }
            ]
        },
        # 传入员工上下文
        context=OfficeContext(user_name="周杰", dept="市场部", role="employee"),
    )
    # 打印员工轨迹
    print_trajectory(r_emp)

    # 场景二:客服查单,应能成功
    print("\n======= 客服:查单 ======")
    r_sup = agent.invoke(
        {
            # 只问查单
            "messages": [
                {"role": "user", "content": "帮我查订单 A1001 现在到哪了?"}
            ]
        },
        # 传入客服上下文
        context=OfficeContext(user_name="坐席小陈", dept="客服中心", role="support"),
    )
    # 打印客服轨迹
    print_trajectory(r_sup)
8.2. middleware 顺序在这里意味着什么 #
middleware=[office_prompt, filter_tools_by_role] 按 §2.2 的洋葱模型展开是:
┌─ office_prompt(外层,先执行)
│  ┌─ filter_tools_by_role(内层)
│  │   ★ 调用模型
│  └─
└─也就是说,office_prompt 生成提示时,看到的仍是未过滤的 4 个工具。实测两种顺序的差异:
# 顺序 A:middleware=[office_prompt, filter_tools_by_role]
dynamic_prompt 看到工具 = ['get_weather', 'lookup_policy', 'lookup_order']   ← 全集
filter 进,看到 system_prompt = '你是助手。'                                  ← 提示已生成

# 顺序 B:middleware=[filter_tools_by_role, office_prompt]
filter 进,看到 system_prompt = None                                         ← 提示还没生成
dynamic_prompt 看到工具 = ['get_weather', 'lookup_policy']                    ← 已过滤
本例用顺序 A 没问题:office_prompt 直接从 context.role 判断该说哪句权限说明,不依赖 request.tools。
但若希望提示自动反映实际可用工具,例如写成这样:
# 想让提示自动列出本次可用工具,就必须放在过滤器的内层
@dynamic_prompt
def office_prompt(request: ModelRequest) -> str:
    # 从请求里读取本次实际可见的工具名
    names = [getattr(t, "name", "?") for t in request.tools]
    # 把工具清单拼进提示
return f"你是办公助手。本次可用工具:{', '.join(names)}。只用这些工具回答。"那就必须换成顺序 B(middleware=[filter_tools_by_role, office_prompt]),否则提示会列出员工其实看不到的 lookup_order——模型被告知有这工具,工具清单里却没有,行为会变得莫名其妙。
一条实用规则:
谁的输出依赖别人的修改结果,谁就放在内层(列表里更靠后)。
若以后加入错误兜底 / HITL,再按第 10 章调整编排。
8.3. 真实运行结果 #
员工路径(4 个意图里 3 个成功、1 个被硬拦):
[0] HumanMessage: '上海天气怎么样?报销怎么走?128+256等于多少?顺便查下 A1001。'
[1] AIMessage: ''
     -> get_weather({'city': '上海'})
     -> lookup_policy({'topic': '报销'})
     -> calculate({'a': 128, 'b': 256, 'op': '+'})
[2] ToolMessage: '上海 当前约 26°(celsius),晴间多云。'
[3] ToolMessage: '差旅报销需在返程 7 日内提交,单笔超 1000 元需主管审批。'
[4] ToolMessage: '384.0'
[5] AIMessage: '已为您处理完毕,汇总如下:

1. **上海天气**:当前约 26°C,晴间多云。
2. **报销流程**:差旅报销需在返程 7 日内提交,单笔超过 1000 元需主管审批。
3. **算术**:128 + 256 = 384。
4. **订单 A1001**:查询订单需要客服权限,我这边无法查看,也不便编造状态,建议您联系客服核实。

如需其他帮助,随时告诉我!'客服路径:
[0] HumanMessage: '帮我查订单 A1001 现在到哪了?'
[1] AIMessage: ''
     -> lookup_order({'order_id': 'A1001'})
[2] ToolMessage: '订单 A1001:已发货,预计 2 天后相关节点完成。'
[3] AIMessage: '您好,订单 A1001 目前已发货,预计 **2 天后** 相关节点完成。请问还有什么需要帮您的吗?'员工路径是本章最值得琢磨的一条轨迹:模型发出了 3 个并行 tool_calls,唯独第 4 个意图没有对应工具调用,最终在第 4 点如实说明权限限制,还主动加了「也不便编造状态」——正是动态提示里那条禁令的回响。硬过滤与软提示配合到位:过滤保证调不到,提示保证说得体。
再留意两个细节:
get_weather的实参里没有units。WeatherInput把units声明成带默认值的选填字段,模型就干脆没传,靠 Python 函数签名里的units: str = "celsius"兜底。这说明选填字段确实是选填的——工具函数自己也必须给默认值,否则会TypeError。ToolMessage里又出现了'384.0'。 参数声明为float的副作用;模型在最终回答里正确写成了「384」。要彻底消掉这个.0,得在工具内部判断结果是否为整数再格式化。
验收清单:
- 员工组合问:应看到天气 / 制度 / 计算相关
tool_calls,查单被明确说明为无权限 - 客服查单:出现
lookup_order,最终依据工具结果 - 提示中出现对应姓名 / 部门(可从行为或 LangSmith 轨迹确认)
- 同一句「查 A1001」,employee / support 轨迹明显不同(这是本章最重要的对照实验)
9. 实用约定与坑 #
按「机制类」和「策略类」分开记,排查时更好定位。
9.1. middleware 机制类 #
这几条是本章实测出来的;错了往往表现为「代码看着对,行为却不对」:
| 约定 | 说明 | 见 |
|---|---|---|
| middleware 按模型调用次数执行 | 一次 invoke 含一轮工具调用 = 跑 2 次;别在里面做只该做一次的事 |
§2.1 |
| 列表越靠前 = 层级越外 | [A, B] 是 A 包着 B;依赖别人修改结果的放内层 |
§2.2、§8.2 |
| 同名 / 同实例 middleware 不能重复挂 | 报 AssertionError: Please remove duplicate middleware instances. |
§2.2 |
改请求用 request.override(...) |
直接赋值会触发 DeprecationWarning |
§5.1(1) |
| 必须交还链路 | 忘记 return handler(...) 报 AttributeError: 'NoneType' object has no attribute 'result' |
§6.1 |
| 动态提示覆盖静态提示 | 两者都配时静态那段被完全丢弃,不合并 | §5.3 |
不传 context 时它是 None |
dataclass 默认值不生效,必须 getattr(ctx, 字段, 默认值) |
§5.1(4) |
| 未注册工具是调模型前预检 | 立刻 ValueError,与模型是否选中无关 |
§6.2 |
开 response_format 后 messages[-1] 不是自然语言 |
是 Returning structured response: ...;文案要在 schema 里设专用字段 |
§7.2 |
9.2. 策略与协作类 #
- 系统提示写策略,工具描述写能力:两者同向,缺一不可
- 多工具先看轨迹再看文案:
tool_calls是协作是否发生的真相 - 动态提示用
context_schema+invoke(..., context=...);别把上下文塞进用户消息凑合 - 动态工具入门用「预注册 + 过滤」;新增未注册工具要 成对 写
wrap_model_call+wrap_tool_call - 动态换模建议传裸模型实例,别传已
bind_tools的模型,尤其同时开了response_format时 - 权限不要只靠提示词:过滤工具是硬约束,提示词是软约束,两者一起用
- 换模型救不了烂提示:选错工具多半是提示 / 工具描述的问题,换强模型只是掩盖
- 危险操作仍应留到第 10 章 HITL,不要只靠「系统提示禁止」
口诀:
静态定底盘,动态调权限;提示定策略,轨迹验协作。
10. 练习 #
每题做完后打印轨迹;涉及权限的题务必用 employee / support(或 admin)对照跑。
策略与协作
- 加强提示:给办公助理增加「超出办公范围礼貌拒绝」条款,测一句「帮我写科幻小说」。
- 角色扩展:增加
role="admin",仅 admin 可见一个模拟的reset_demo_data()工具(仍用过滤,不要真删数据)。 - 动态模型:在
pick_model里按「用户消息是否包含『仔细分析』」切换careful_model——注意要从state["messages"]里倒序找最近一条HumanMessage。 - 协作压测:一次提问同时覆盖四个工具意图,打印轨迹,标出每次
tool_calls。 - 对照权限:同一句「查 A1002」,分别用 employee / support 跑,对比轨迹差异。
机制验证(做完这几题,§9.1 的表就不用背了)
- 数调用次数:在 middleware 里加计数器,分别问一句「你好」和一句「北京天气怎么样」,解释两次的计数为什么不同。
- 验证洋葱顺序:挂三个
wrap_model_call,各自打印「进」「出」,确认输出是1进 2进 3进 3出 2出 1出。 - 复现覆盖:同时配置
system_prompt和@dynamic_prompt,在下游拦截器里打印request.system_prompt,确认静态那段真的消失了。 - 复现 None:声明
context_schema但故意不传context,先用ctx.user_name读(观察AttributeError),再改成getattr修好。 - 动态新增工具:仿 §6.2 再挂一个
lookup_exchange_rate(currency: str) -> str(返回固定字符串),确认轨迹里能执行;然后去掉wrap_tool_call,问一句和汇率完全无关的话,验证它仍然立刻报错。 - 取错文案:在 §7.2 的例子里打印
result["messages"][-1].content,看看用户会看到什么,再改成从structured_response.one_line取。
11. 本章小结 #
create_agent的深度配置 = 静态三件套 + middleware 动态性 +(可选)context。- middleware 有两个必须先搞清的机制:按模型调用次数执行(§2.1)、洋葱式嵌套且首个在最外层(§2.2)。搞错了就会得到「代码正确但行为不对」。
- 系统提示负责策略与禁令;工具描述负责能力与参数;多工具要写清路由表。
- 多工具协作以完整
messages/tool_calls为验收标准;模型会把多个意图并行发出。 @dynamic_prompt按运行时上下文生成人设,并且完全覆盖静态system_prompt;不传context时它是None,读取必须用getattr带默认值。@wrap_model_call可过滤工具、切换模型;过滤是硬约束,模型看不见就选不了。- 动态工具优先「预注册 + 按角色过滤」;真新增工具需
wrap_model_call+wrap_tool_call成对,缺一个会在调模型前就预检失败。 - Agent 层
response_format+ToolStrategy可同时带工具与结构化终态(§7.2);但要记住末条消息不是自然语言,人类可读文案要在 schema 里单独设字段。 - 权限 = 硬过滤 + 软提示;不要只信其中一侧。
- 本章实战:多工具办公助理(动态提示 + 角色工具集 + 组合协作);同一句话在 employee / support 下走出两条完全不同的轨迹。
一个 Agent 不够、要把专家包成工具或按步骤换配置时,见 第 18 章 Multi-agent。
下一章:Middleware 与安全护栏——重试、限流、PII、人机协同(HITL),把助理推进到生产向。