1. 本章目标 #
上一章我们把公司资料读成了 Document,产出了 ingested.jsonl。但那些 Document 还太大:一页 PDF 可能有两千字,一份制度文档可能上万字。直接拿去检索会怎样?
设想用户问:「滤芯多久换一次?」而知识库里只有一个整页大小的切片,那么检索命中这一页之后,模型要在两千字里找那一句话——关键一句淹没在无关内容里,回答质量会明显下降,token 也白白浪费。
所以 RAG 的第二道工序是切分(splitting / chunking):把大 Document 切成若干大小合适、语义完整的小块(chunk)。
第 12 章 Load     ingested.jsonl(整页 / 整篇的 Document)
   │
   ▼
第 13 章 Split    切成 chunk,写出 chunks.jsonl        ← 本章
   │
   ▼
第 14 章 Embed    每个 chunk 转成一个向量存进向量库
   │
   ▼
第 15 章 Retrieve 按问题召回最相关的几个 chunk
这一章的重要性常被低估。实际项目里「RAG 检索不准」的原因,排第一的往往不是嵌入模型不好,而是切分切坏了——把一句话拦腰截断、把表头和数据分到两个块里、或者切得太大导致噪声淹没答案。
本章目标:
用合适的切分器与参数,把 Document 切成语义完整的 chunk,保留 metadata,并做切分质量自检。
学完你应能:
- 说清
chunk_size与chunk_overlap的作用,以及 overlap 实际生效的条件 - 用
RecursiveCharacterTextSplitter完成绝大多数切分任务 - 修好中文场景的默认参数问题(默认分隔符会把中文句子切断)
- 用
add_start_index与split_documents保留来源信息 - 知道中文的 token 消耗特点,以及什么时候按 token 计长才真的有用
- 用
MarkdownHeaderTextSplitter做「按结构切分」,把标题写进 metadata - 识别切分事故:超长块、碎片块、断句块
- 产出高质量切片流水线,输出可交给第 14 章的
chunks.jsonl
切分这一层的坑,和第 12 章一样几乎都属于「不报错,但数据已经切坏了」。下面这几条是本章实测出来的、和直觉不一样的结论,先扫一眼:
| 你可能以为 | 实际情况 | 见 |
|---|---|---|
不写 chunk_size 会用个小默认值 |
默认是 4000 字符,忘了写就等于几乎没切 | §3.1 |
设了 chunk_overlap 就会重叠 |
尾部片段比 overlap 长时,重叠完全不发生 | §3.3 |
separators 不传也能凑合用 |
中文会退化成逐字硬切,把「15 日内」从数字中间劈开 | §4.2 |
keep_separator 默认是 "start" |
默认值其实是 True(行为等同 "start") |
§4.3 |
| 改成按 token 计长,切分结果会明显不同 | 纯中文几乎没区别;真正有用的是中英混排 | §5.2 |
| 标题不在正文里,要自己拼回去 | 有 strip_headers=False 参数直接搞定 |
§6.1 |
CharacterTextSplitter 切出超长块会警告 |
最后一块超长时一声不响,警告不一定出现 | §7 |
前置依赖: 第 12 章(Document 结构与 ingested.jsonl)。
参考文档:
安装(第 12 章装过 langchain 就已经有了,单独装也可以):
# 切分器独立成包,不依赖模型和网络
# tiktoken 用于按 token 计长(§5),中文场景建议装上
pip install langchain-text-splitters tiktoken
2. 为什么必须切分 #
2.1. 三个硬约束 #
切分不是「为了整齐好看」,而是被三件事逼出来的:
| 约束 | 不切会怎样 |
|---|---|
| 模型上下文窗口有限 | 检索回来 3 个整页切片就可能几千 token,塞不下或挤掉对话历史 |
| 成本与延迟 | 输入 token 直接换算成钱和等待时间,无关内容全是浪费 |
| 检索精度 | 块越大,一个块里混的主题越多,向量语义越"平均",越难被精准命中 |
第三条最容易被忽略:第 14 章会把每个 chunk 压成一个向量。如果一个 chunk 里既讲退货又讲发货,这个向量就是两个主题的"折中值"——问退货时它不够像退货,问发货时它不够像发货,两边都召不回来。
2.2. chunk 是「检索单位」,不是「技术碎片」 #
换个角度会更清楚:
你不是在「切文本」,而是在定「一次检索该返回多大一块信息」。
理想的 chunk 满足两个条件:
| 条件 | 含义 |
|---|---|
| 自足 | 单独拿出来读,也能看懂它在讲什么 |
| 单一 | 只讲一件事,不要一个块横跨两个主题 |
反面例子最能说明问题:
| 坏切法 | 后果 |
|---|---|
"质量问题 15" + "日内可换货" |
两块都答不了「几天内能换货」——这正是 §4.2 中文默认参数的真实结果 |
| 表格表头和数据行被切开 | 数据行只剩一串数字,没有列名,模型无法解读 |
| 一个块里既有退货政策又有发货时效 | 向量语义模糊,两个问题都召不准 |
所以本章的判断标准始终是:切出来的块,人读着是否完整。
3. 两个核心参数 #
几乎所有切分器都有这两个参数,先把它们弄清。
3.1. chunk_size:一块最多多长 #
chunk_size 是单块长度上限。注意它的单位默认是字符数,不是 token 数(想按 token 算见 §5)。
它是上限,不是目标值——实际切出来的块往往比它短,因为切分器会优先在自然边界(段落、句子)断开,而不是硬凑到刚好顶满上限。
先记住默认值,它比你想的大得多:
# 切分器的默认参数都定义在基类 TextSplitter 上
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 什么参数都不传,构造一个默认切分器
splitter = RecursiveCharacterTextSplitter()

# 下划线开头的是内部属性,这里只为了看清默认值
print("默认 chunk_size:", splitter._chunk_size)
# 默认重叠长度
print("默认 chunk_overlap:", splitter._chunk_overlap)
# 默认分隔符列表,注意里面没有任何中文标点
print("默认 separators:", splitter._separators)
# strip_whitespace 决定切出来的块要不要去掉首尾空白
print("默认 strip_whitespace:", splitter._strip_whitespace)
运行输出:
默认 chunk_size: 4000
默认 chunk_overlap: 200
默认 separators: ['\n\n', '\n', ' ', '']
默认 strip_whitespace: True
默认 chunk_size 是 4000 字符,这个值大到几乎等于「不切」——一页 PDF 两千字,两页都塞得进一个块。所以:
chunk_size是必须显式传的参数。忘了传不报错,只会让你以为已经切过。
顺便说明 strip_whitespace=True 的作用:它会自动去掉每个块首尾的空白字符。这是个省事的默认值,§9 流水线里不必再手动 strip()(流水线里仍保留了一道,因为标题切分器的输出可能带空白)。
3.2. chunk_overlap:为什么要让块之间重叠 #
chunk_overlap 让相邻两块共享一段尾巴。为什么要故意重复?因为答案可能正好横跨切分点:
无重叠:
块1: ...滤芯到期时指示灯会闪红灯,此时需更换滤芯。
块2: 更换完成后长按复位键三秒,计时器归零。
       ↑ 用户问「换完滤芯要做什么」,块2 单独看不知道在说滤芯

有重叠:
块1: ...滤芯到期时指示灯会闪红灯,此时需更换滤芯。
块2: 此时需更换滤芯。更换完成后长按复位键三秒,计时器归零。
└─重叠部分───┘ ↑ 块2 自带上下文,可独立理解代价是存储与检索成本上升(重复内容要多存一份向量),所以 overlap 不是越大越好。
3.3. overlap 的实际生效条件 #
这里有个很反直觉的行为:chunk_overlap 设了不等于一定生效。
原因在切分器的合并逻辑里。分两步:先按分隔符把文本拆成一堆小片段,再把片段依次拼成不超过 chunk_size 的块。
关键是拼到超限、要开新块的那一刻,它怎么决定「留哪些片段作为重叠」:
留下来做重叠的一定是若干个完整片段,而不是精确的 N 个字符。
于是:如果尾部那个片段本身就比 chunk_overlap 长,会把它也弹出去,一个片段都留不下,重叠就变成 0。
实测一下。先看句子较短的文本:
# Document 用于演示 split_documents 的用法
from langchain_core.documents import Document
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 中文分隔符(§4.2 会详解为什么必须自己传)
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

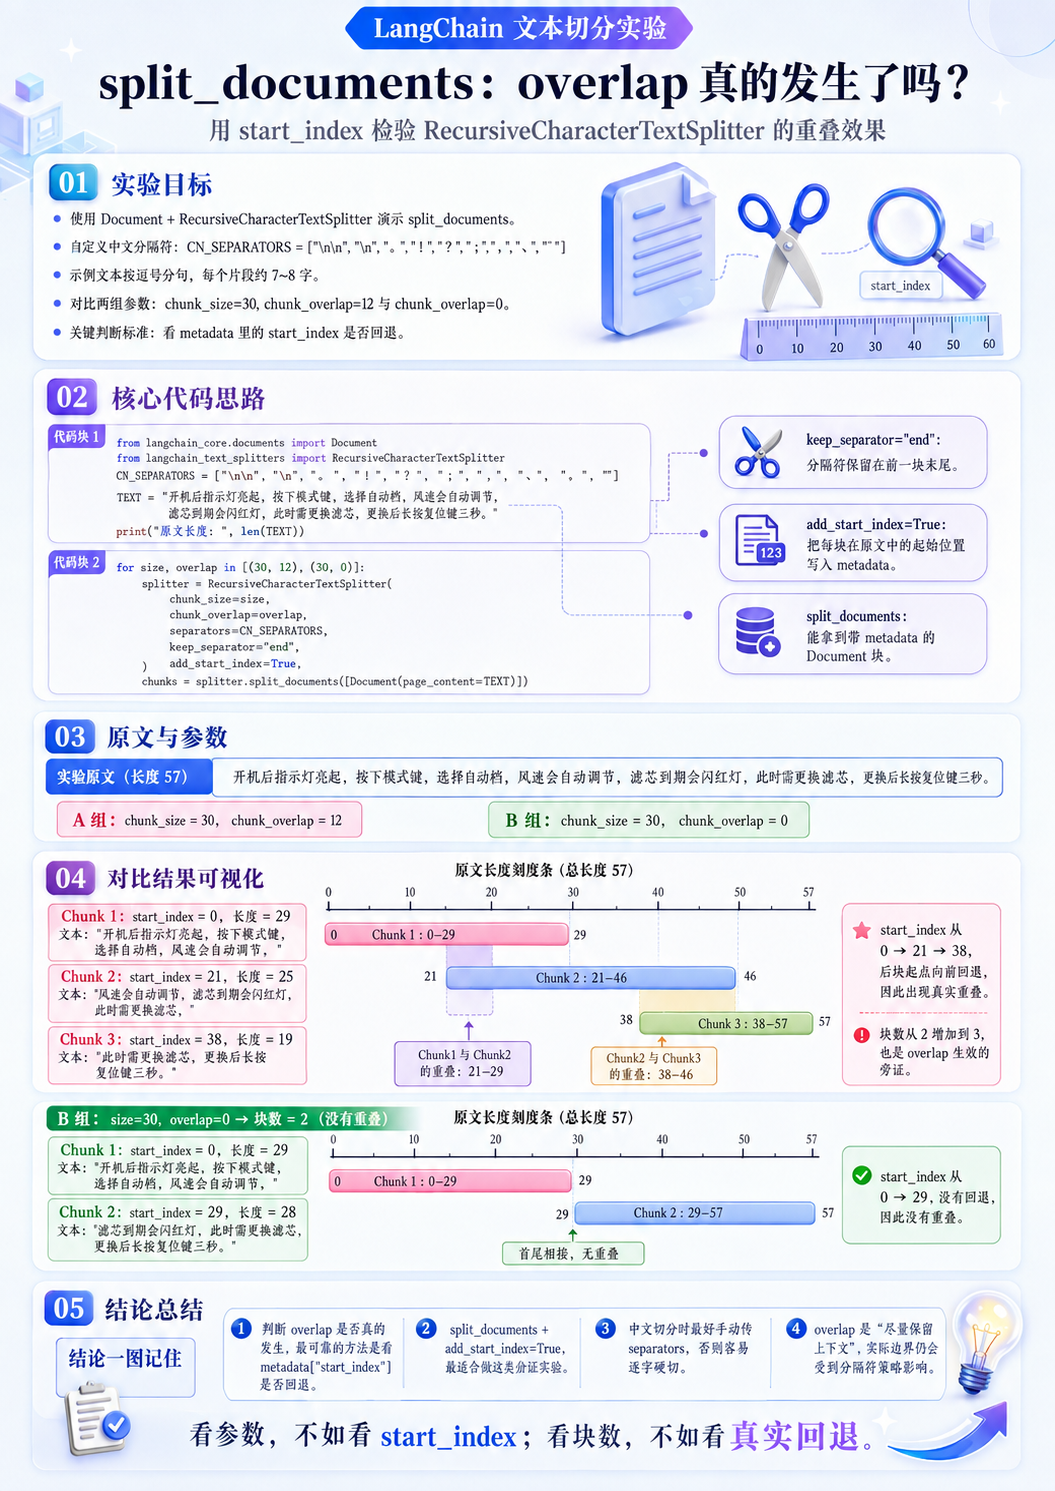
# 这段文本用逗号分句,每个片段只有 7~8 字,比下面的 overlap=12 短
TEXT = "开机后指示灯亮起,按下模式键,选择自动档,风速会自动调节,滤芯到期会闪红灯,此时需更换滤芯,更换后长按复位键三秒。"
# 记住这个总长度,下面要用它推算有没有重叠
print("原文长度:", len(TEXT))

# 对比 overlap=12 与 overlap=0,用 start_index 判断是否真的重叠了
for size, overlap in [(30, 12), (30, 0)]:
    # 每轮用当前参数新建一个切分器(切分器无状态,也可以复用)
    splitter = RecursiveCharacterTextSplitter(
        # 单块长度上限
        chunk_size=size,
        # 本轮要测试的重叠长度
        chunk_overlap=overlap,
        # 中文分隔符,不传会逐字硬切
        separators=CN_SEPARATORS,
        # 分隔符(如「,」)留在前一块末尾,这会影响块的实际长度
        keep_separator="end",
        # 在 metadata 里记录每块在原文中的起始位置(从 0 开始)
        # 这是检验重叠有没有发生的唯一可靠手段
        add_start_index=True,
    )
    # 用 split_documents 才能拿到带 start_index 的 metadata
    chunks = splitter.split_documents([Document(page_content=TEXT)])
    # 块数本身也是信息:重叠会让块数变多
    print(f"\nsize={size} overlap={overlap} 块数={len(chunks)}")
    # 逐块查看
    for c in chunks:
        # start_index 相邻块之间是否回退,就是有没有重叠的铁证
        print("  起始位置", c.metadata["start_index"], "长度", len(c.page_content))
        # repr 能看清空白字符
        print("  ", repr(c.page_content))
运行输出:
原文长度: 57

size=30 overlap=12 块数=3
  起始位置 0 长度 29
   '开机后指示灯亮起,按下模式键,选择自动档,风速会自动调节,'
  起始位置 21 长度 25
   '风速会自动调节,滤芯到期会闪红灯,此时需更换滤芯,'
  起始位置 38 长度 19
   '此时需更换滤芯,更换后长按复位键三秒。'

size=30 overlap=0 块数=2
  起始位置 0 长度 29
   '开机后指示灯亮起,按下模式键,选择自动档,风速会自动调节,'
  起始位置 29 长度 28
   '滤芯到期会闪红灯,此时需更换滤芯,更换后长按复位键三秒。'
对照 start_index 很清楚:
overlap=12:第二块从 21 开始,而第一块到 29 才结束 → 重叠了 8 个字(风速会自动调节,),因为这个片段长度 8 ≤ 12overlap=0:第二块从 29 开始,正好接着第一块 → 无重叠;块数也从 3 变成 2(重复内容会让总块数变多)
再看句子较长的文本(每句 20 多字):
# Document 用于演示
from langchain_core.documents import Document
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

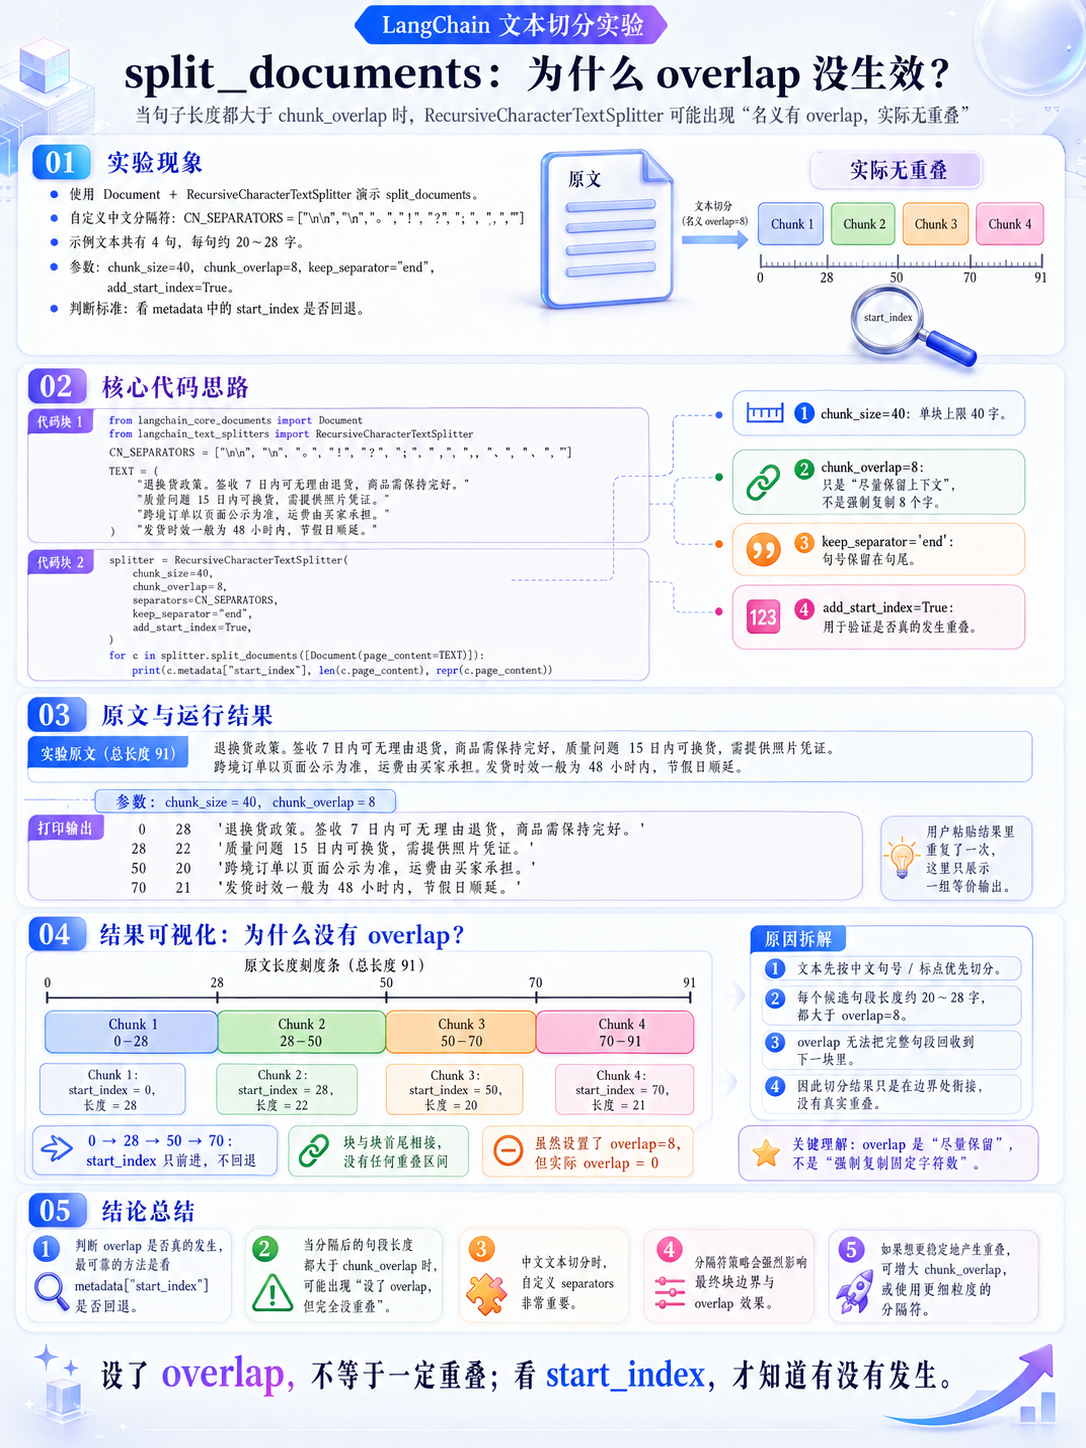
# 这段每个句子都有 20~28 字,都比 chunk_overlap 长
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# 构造切分器:参数和上面短句那组几乎一样,只有文本变长了
splitter = RecursiveCharacterTextSplitter(
    # 单块上限 40 字
    chunk_size=40,
    # 明明设了 8,但下面会看到它一点都没生效
    chunk_overlap=8,
    # 中文分隔符
    separators=CN_SEPARATORS,
    # 句号留在句尾
    keep_separator="end",
    # 关键:靠它来验证重叠
    add_start_index=True,
)
# 逐块打印起始位置、长度、内容
for c in splitter.split_documents([Document(page_content=TEXT)]):
    # 重点看第一列:如果块块相接,说明重叠没发生
    print(c.metadata["start_index"], len(c.page_content), repr(c.page_content))
运行输出:
0 28 '退换货政策。签收 7 日内可无理由退货,商品需保持完好。'
28 22 '质量问题 15 日内可换货,需提供照片凭证。'
50 20 '跨境订单以页面公示为准,运费由买家承担。'
70 21 '发货时效一般为 48 小时内,节假日顺延。'
start_index 是 0 → 28 → 50 → 70,块块相接、完全没有重叠——设的 chunk_overlap=8 一个字都没用上,因为最短的句子也有 20 字。
怎么用 start_index 判断有没有重叠,规则很简单:
| 观察 | 含义 |
|---|---|
下一块的 start_index < 上一块的 start_index + 长度 |
发生了重叠,差值就是重叠字数 |
下一块的 start_index == 上一块的 start_index + 长度 |
无重叠,块块相接 |
用第一个例子核对:第一块 start=0、长 29,所以它覆盖 0~28;第二块 start=21 < 29,重叠了 8 个字(正好是「风速会自动调节,」这个片段,长度 8 ≤ 12 所以留住了)。
结论:
chunk_overlap保留的是「整段分隔片段」。要让它真正生效,overlap 至少应大于典型句子长度;否则start_index会告诉你重叠根本没发生。
因此:别只看参数,要用 add_start_index 看实际切分结果。
顺便说一句:第一个例子里 overlap=12 切出 3 块,overlap=0 只切出 2 块。重叠会让总块数变多,因为重复的内容也要占块的长度配额。这直接影响成本——第 14 章每个块都要嵌入一次、存一条向量,块数多 50% 就意味着建库费用和存储都多 50%。overlap 不是「设大点更保险」,它要付存储和嵌入成本。
3.4. 参数怎么定 #
没有万能值,但有可用的起点。中文场景(1 个汉字约 1 个 token,见 §5):
| 资料类型 | chunk_size(字符) |
chunk_overlap |
理由 |
|---|---|---|---|
| FAQ、政策条款 | 200~400 | 50~80 | 条目本身短,切小些更精准 |
| 制度、手册正文 | 400~800 | 80~150 | 需要一定上下文才能读懂 |
| 技术文档、长报告 | 600~1000 | 100~200 | 论述连贯,切太碎会丢逻辑 |
| 已按标题切过的段落 | 300~600 | 60~120 | 结构已提供上下文(§6.2) |
调参方向:
| 症状 | 调整 |
|---|---|
| 检索能命中但答案不全 | 加大 chunk_size 或 chunk_overlap |
| 检索回来一堆无关内容 | 减小 chunk_size |
| 答案总是跨块被切断 | 加大 chunk_overlap(并确认它真的生效,见 §3.3) |
| 向量库膨胀、成本高 | 减小 chunk_overlap |
先用推荐值跑通,等第 15 章有了检索效果,再拿真实问题回头调参——脱离检索效果调参数没有意义。
4. 首选切分器:RecursiveCharacterTextSplitter #
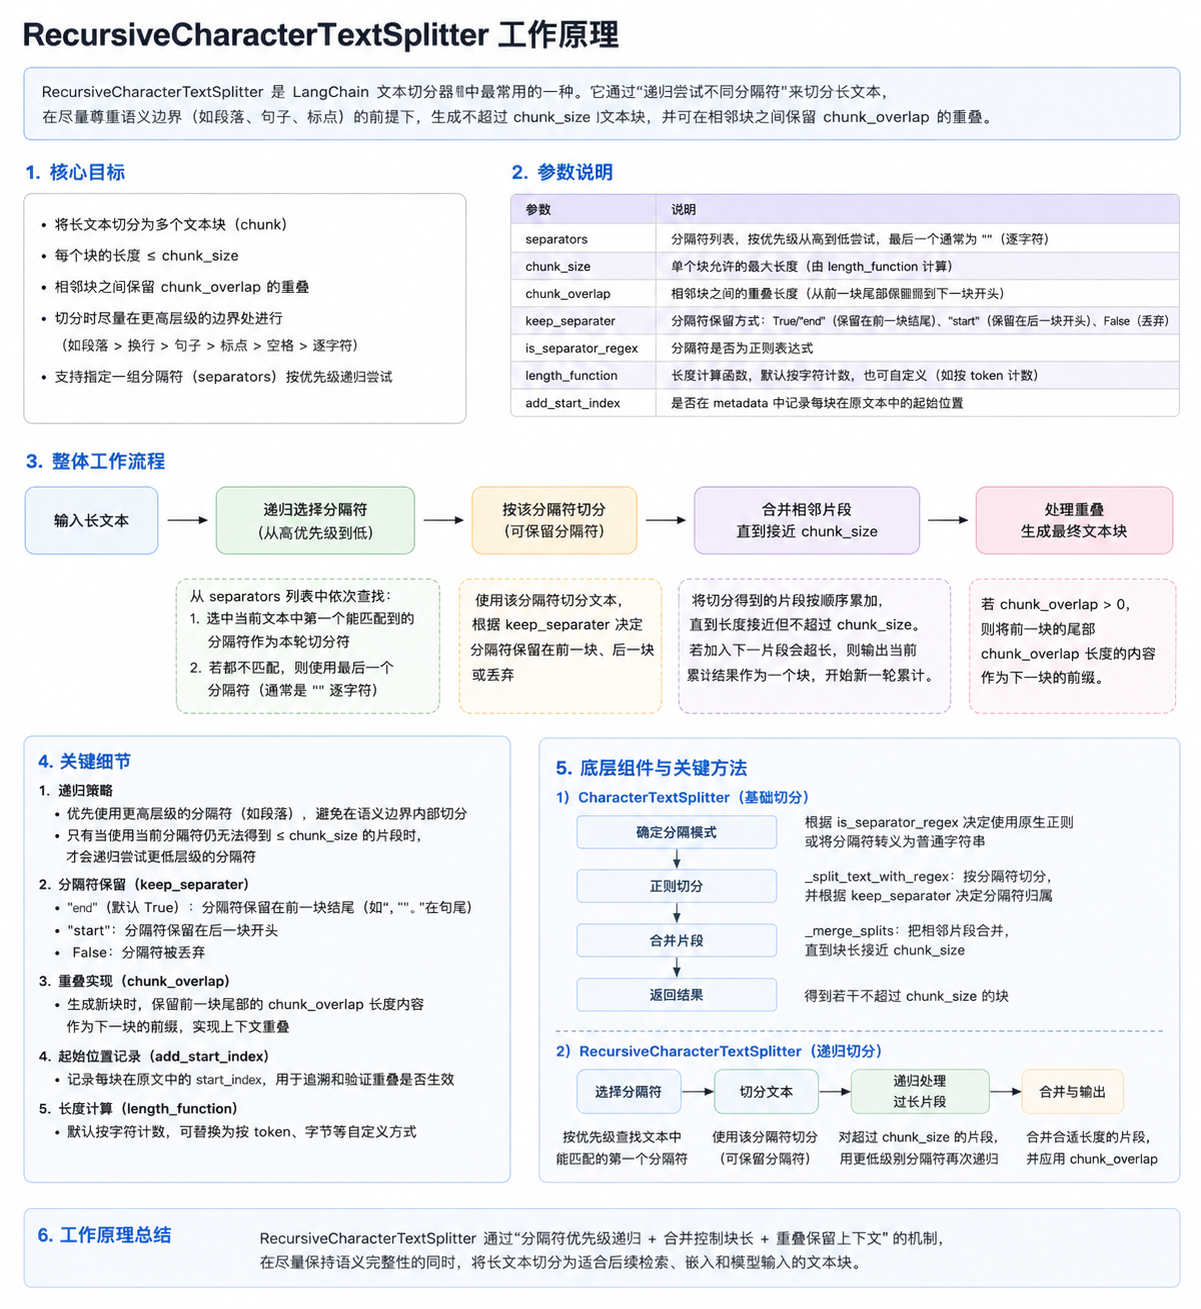
RecursiveCharacterTextSplitter
它是官方推荐的通用切分器,九成场景用它就够。
4.1. 「递归」是什么意思 #
它维护一个分隔符优先级列表,从最大边界开始尝试,太长了就换下一级更细的分隔符继续切:
分隔符列表(默认): ["\n\n", "\n", " ", ""]

第1轮:按 "\n\n"(段落)切
        │
        ├─ 块长度 ≤ chunk_size? → 收下,完成
        └─ 还是太长? → 对这块用下一级分隔符 "\n" 再切
                              │
└─ 还太长? → 用 " " 切 → 最后用 ""(逐字符硬切)目的是尽量在语义边界断开:能按段落断就不按句子断,能按句子断就不逐字硬切。最后的 "" 是保底,确保再离谱的长文本也一定能切到限长以内。
4.2. 中文必须改的默认参数 #
看默认分隔符:["\n\n", "\n", " ", ""]。段落、换行、空格、逐字符。
症结在这里:中文句子之间没有空格。一段中文写下来,既没有 \n\n 也没有 \n,更没有空格,切分器只能退到最后一级 "" ——逐字符硬切,切在哪完全看字数是否凑满。
实测如下:
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 一段典型的中文制度文本,注意里面没有任何换行和空格
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# 什么都不改,直接用默认分隔符 ["\n\n", "\n", " ", ""]
splitter = RecursiveCharacterTextSplitter(chunk_size=40, chunk_overlap=8)

# split_text 只吃字符串吐字符串,快速试参数时用它就够
for i, chunk in enumerate(splitter.split_text(TEXT)):
    # 打印序号、长度、内容,观察切在了什么位置
    print(i, len(chunk), repr(chunk))
运行输出:
0 35 '退换货政策。签收 7 日内可无理由退货,商品需保持完好。质量问题 15'
1 39 '日内可换货,需提供照片凭证。跨境订单以页面公示为准,运费由买家承担。发货时效一'
2 10 '承担。发货时效一般为'
3 13 '48 小时内,节假日顺延。'结果很糟,逐条看:
- 第 0 块结尾是
质量问题 15,第 1 块开头是日内可换货——「15 日内可换货」被从数字中间劈开了,两块谁都答不了「几天内能换」 - 第 1 块结尾
发货时效一也是半个词 - 第 2 块只有 10 个字,是个语义残缺的碎片
还有一点:第 1 块和第 2 块之间出现了重叠(承担。 在两块里都有),因为默认分隔符退化到逐字符时,「片段」就是单个字符,长度 1 远小于 chunk_overlap=8,所以重叠能正常生效。这印证了 §3.3 的机制——片段越细,overlap 越容易生效,但代价是切在哪儿完全失控。
修法简单:把中文标点加进 separators。
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 同一段测试文本
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# 分隔符按「从大到小」排列:段落 → 换行 → 句末标点 → 句中标点 → 空格 → 逐字符
# 顺序很重要,切分器是按这个顺序依次尝试的
# 末尾的 "" 是保底:再长的连续文本也一定能切到限长以内
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# 构造切分器:和上一段唯一的区别就是多传了 separators
splitter = RecursiveCharacterTextSplitter(
    # 单块上限 40 字
    chunk_size=40,
    # 重叠 8 字
    chunk_overlap=8,
    # 关键改动:传入中文分隔符
    separators=CN_SEPARATORS,
)

# 逐块打印,观察是否还有断句
for i, chunk in enumerate(splitter.split_text(TEXT)):
    # 现在每块都应该是完整句子,只是句号位置还有点怪
    print(i, len(chunk), repr(chunk))
运行输出:
0 27 '退换货政策。签收 7 日内可无理由退货,商品需保持完好'
1 22 '。质量问题 15 日内可换货,需提供照片凭证'
2 20 '。跨境订单以页面公示为准,运费由买家承担'
3 22 '。发货时效一般为 48 小时内,节假日顺延。'每块已是完整句子,但还有小瑕疵:句号跑到了下一块的开头('。质量问题 15...')。§4.3 会处理。
中文项目里,
separators是必须自己传的参数——不传就等于逐字硬切。
4.3. keep_separator:让句号留在句尾 #
keep_separator="end" 让分隔符跟在前一块的末尾,更符合中文阅读习惯:
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 同一段测试文本
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# 构造切分器:这次再加上 keep_separator
splitter = RecursiveCharacterTextSplitter(
    # 单块上限
    chunk_size=40,
    # 重叠字数
    chunk_overlap=8,
    # 中文分隔符
    separators=CN_SEPARATORS,
    # "end" 表示分隔符留在前一块末尾;默认行为是留在后一块开头
    keep_separator="end",
)

# 逐块打印,确认句号都在句尾
for i, chunk in enumerate(splitter.split_text(TEXT)):
    # 这就是可以直接进向量库的形态
    print(i, len(chunk), repr(chunk))
运行输出:
0 28 '退换货政策。签收 7 日内可无理由退货,商品需保持完好。'
1 22 '质量问题 15 日内可换货,需提供照片凭证。'
2 20 '跨境订单以页面公示为准,运费由买家承担。'
3 21 '发货时效一般为 48 小时内,节假日顺延。'每块都是以句号结尾的完整句群,可直接进向量库。
对照 §4.2:块的字数各多了 1 个字(27→28、21→22……),因为句号从下一块挪回了本块。总字数不变,只是归属变了,读起来却完整得多。
四种取值的实测效果:
keep_separator 取值 |
效果 |
|---|---|
"end" |
分隔符留在前一块末尾 → 中文推荐 |
True(RecursiveCharacterTextSplitter 的默认值) |
等同 "start" |
"start" |
分隔符留在后一块开头 → 块首出现孤零零的「。」 |
False |
丢掉分隔符 → 句子粘连,且块会被填得更满 |
注意默认值那一行:RecursiveCharacterTextSplitter 的 keep_separator 默认是 True,行为和 "start" 完全一致(实测两者输出一模一样)。所以你在别处看到「默认是 start」的说法,描述的是行为、不是字面值。
False 的后果更严重,不止「句子粘在一起」:
# 把 keep_separator 设成 False,其余参数不变
splitter = RecursiveCharacterTextSplitter(
    # 上限仍是 40 字
    chunk_size=40,
    # 重叠仍是 8 字
    chunk_overlap=8,
    # 分隔符列表也不变
    separators=CN_SEPARATORS,
    # 丢掉分隔符
    keep_separator=False,
)

# 观察块数和长度的变化
for i, chunk in enumerate(splitter.split_text(TEXT)):
    # 注意最后一块正好被填到 40 字
    print(i, len(chunk), repr(chunk))
运行输出:
0 27 '退换货政策。签收 7 日内可无理由退货,商品需保持完好'
1 21 '质量问题 15 日内可换货,需提供照片凭证'
2 40 '跨境订单以页面公示为准,运费由买家承担。发货时效一般为 48 小时内,节假日顺延'
块数从 4 变成 3,而且最后一块正好被填到 40 字上限、把两个句子挤进了同一块。 原因是分隔符被丢掉后每个片段都短了一两个字,于是更容易再塞进一个片段。同时前两块的句号也没了,读起来像没写完的话。中文场景下这个取值没有使用理由。
4.4. split_documents:保留 metadata #
前面的 split_text 只吃字符串、吐字符串——metadata 会全丢。处理第 12 章写入的 ingested.jsonl 必须用 split_documents,它吃 Document 吐 Document,并把父文档 metadata 复制到每个 chunk。
# Document 是第 12 章写入的、也是本章要处理的类型
from langchain_core.documents import Document
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# 测试文本
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# 模拟第 12 章 ingested.jsonl 里的一条记录
docs = [
    # split_documents 吃的是列表,所以外面套一层 []
    Document(
        # 正文
        page_content=TEXT,
        # 第 12 章辛苦补齐的 metadata,接下来要验证它们会不会丢
        metadata={"source": "policy/refund.md", "doc_id": "abc123"},
    )
]

# 构造切分器:参数和 §4.3 完全一样,只多开了 add_start_index
splitter = RecursiveCharacterTextSplitter(
    # 单块上限
    chunk_size=40,
    # 重叠字数
    chunk_overlap=8,
    # 中文分隔符
    separators=CN_SEPARATORS,
    # 句号留在句尾
    keep_separator="end",
    # 记录每块在父文档中的起始字符位置,便于溯源和调试
    add_start_index=True,
)

# 注意方法名:split_documents(复数),参数是 list[Document]
chunks = splitter.split_documents(docs)

# 一个 Document 切成了 4 个 Document
print("切出 chunk 数:", len(chunks))
# 逐块查看 metadata 有没有被继承
for c in chunks:
    # source 和 doc_id 被自动继承,还多了一个 start_index
    print(len(c.page_content), c.metadata)
运行输出:
切出 chunk 数: 4
28 {'source': 'policy/refund.md', 'doc_id': 'abc123', 'start_index': 0}
22 {'source': 'policy/refund.md', 'doc_id': 'abc123', 'start_index': 28}
20 {'source': 'policy/refund.md', 'doc_id': 'abc123', 'start_index': 50}
21 {'source': 'policy/refund.md', 'doc_id': 'abc123', 'start_index': 70}
三个要点:
| 要点 | 说明 |
|---|---|
| metadata 自动继承 | 第 12 章补上的 source / page / doc_id 一个都不会丢 |
start_index 是相对父文档的偏移 |
不是相对原始文件;两段式切分后更要注意(§6.2) |
每个 chunk 是独立的 Document |
修改某个 chunk 的 metadata 不会影响其他 chunk |
方法对照表:
| 方法 | 输入 | 输出 | 用在哪 |
|---|---|---|---|
split_text(str) |
字符串 | list[str] |
快速试参数、写文档 |
split_documents(list[Document]) |
Document 列表 | list[Document] |
生产流水线 |
create_documents(list[str], metadatas=...) |
字符串列表 | list[Document] |
手工构造 Document |
还有一点:add_start_index=True 只在 split_documents / create_documents 下才有意义,因为 start_index 是写进 metadata 的,而 split_text 根本不返回 metadata。这就是为什么 §3.3 验证重叠时必须用 split_documents——要看 start_index,就得用 Document。
规律:调参用
split_text看内容更快,验证重叠必须用split_documents看start_index。
5. 按 token 计长 #
5.1. 字符数 ≠ token 数 #
前面所有 chunk_size 的单位都是字符。但模型的窗口限制、计费单位都是 token,两者并不相同。
实测一段 91 字的中文:
# tiktoken 是 OpenAI 的分词库,用来把文本切成 token
import tiktoken

# 测试文本
TEXT = (
    "退换货政策。签收 7 日内可无理由退货,商品需保持完好。"
    "质量问题 15 日内可换货,需提供照片凭证。"
    "跨境订单以页面公示为准,运费由买家承担。"
    "发货时效一般为 48 小时内,节假日顺延。"
)

# cl100k_base 是 GPT-4 / GPT-3.5 系列使用的编码,常用来估算 token
encoding = tiktoken.get_encoding("cl100k_base")

# len() 数的是字符(对中文就是汉字个数)
print("字符数:", len(TEXT))
# encode 把文本变成 token 编号列表,它的长度就是 token 数
print("token 数:", len(encoding.encode(TEXT)))
运行输出:
字符数: 91
token 数: 97
中文的 token 数比字符数还多(这里 91 字 = 97 token)。比例并不均匀,看几个词就明白:
# tiktoken 是 OpenAI 的分词库,用来把文本切成 token
import tiktoken

# cl100k_base 是 GPT-4 / GPT-3.5 系列使用的编码,常用来估算 token
encoding = tiktoken.get_encoding("cl100k_base")
# 挑一些中英词逐个测量,看 token 密度差多少
for word in [
    "退",
    "政策",
    "滤芯",
    "指示灯",
    "空气质量自动调节",
    # 后两个是英文对照
    "hello world",
    "The quick brown fox jumps",
]:
    # 该词的 token 数
    n = len(encoding.encode(word))
    # 字符数、token 数、以及"每字符几个 token"的比率
    print(
        f"{word!r:<30} {len(word):>2} 字符 -> {n:>2} token  (比率 {n / len(word):.2f})"
    )
运行输出:
'退'                             1 字符 ->  1 token  (比率 1.00)
'政策'                            2 字符 ->  3 token  (比率 1.50)
'滤芯'                            2 字符 ->  4 token  (比率 2.00)
'指示灯'                           3 字符 ->  4 token  (比率 1.33)
'空气质量自动调节'                      8 字符 -> 10 token  (比率 1.25)
'hello world'                  11 字符 ->  2 token  (比率 0.18)
'The quick brown fox jumps' 25 字符 -> 5 token (比率 0.20)差距很大:'滤芯' 两个字要 4 个 token(生僻字会被拆成多个字节级 token),而 25 个字符的英文句子只要 5 个 token。经验值:
| 语言 | 字符与 token 的关系 |
|---|---|
| 英文 | 约 4~5 个字符 ≈ 1 token(常用词多为 1 个 token) |
| 中文 | 约 1 个汉字 ≈ 1~2 token(常用字约 1,生僻字可到 2~3) |
也就是说,chunk_size=500 对英文约 100~125 token,对中文可能是 500~700 token——同样的参数,中文块的实际 token 量是英文的 4~5 倍。做预算和估窗口时别算错。
5.2. from_tiktoken_encoder #
若要让 chunk_size 按 token 计长,用类方法 from_tiktoken_encoder 构造:
# tiktoken 用来独立核算 token 数
import tiktoken
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# 纯中文测试文本
CN_TEXT = (
    "签收七日内可无理由退货,商品需保持完好,包装与配件齐全。"
    "质量问题十五日内可换货,需提供照片凭证并联系客服登记。"
    "跨境订单以页面公示为准,退回运费由买家承担。"
)

# 用于核算的编码器
encoding = tiktoken.get_encoding("cl100k_base")
# 先看原文的两个数字,77 和 84 很接近
print(f"原文:{len(CN_TEXT)} 字符 / {len(encoding.encode(CN_TEXT))} token")

# 两个切分器,唯一区别是长度怎么算
splitters = {
    # 普通构造:chunk_size 的单位是字符
    "字符计长": RecursiveCharacterTextSplitter(
        # 上限 60 字符,不重叠
        chunk_size=60, chunk_overlap=0,
        # 中文分隔符 + 句号留句尾
        separators=CN_SEPARATORS, keep_separator="end",
    ),
    # from_tiktoken_encoder 构造:chunk_size 的单位变成 token
    "token计长": RecursiveCharacterTextSplitter.from_tiktoken_encoder(
        # 指定用哪个编码来数 token
        encoding_name="cl100k_base",
        # 同样是 60,但单位变成 token
        chunk_size=60, chunk_overlap=0,
        # 中文分隔符照样要传,token 计长不解决切断句子的问题
        separators=CN_SEPARATORS, keep_separator="end",
    ),
}

# 分别切一遍,对比结果
for label, splitter in splitters.items():
    # 用同一段文本切
    chunks = splitter.split_text(CN_TEXT)
    # 把每块的"字符数/token数"拼成一行,方便横向对比
    detail = ", ".join(f"{len(c)}字符/{len(encoding.encode(c))}tok" for c in chunks)
    # 输出一行结果
    print(f"{label}: {len(chunks)} 块 -> {detail}")
运行输出:
原文:77 字符 / 84 token
字符计长: 2 块 -> 55字符/58tok, 22字符/26tok
token计长: 2 块 -> 55字符/58tok, 22字符/26tok
两者结果完全一样。 这比「看到差异」更有说服力:纯中文文本里字符数和 token 数的比例接近 1,所以换成 token 计长几乎不改变切分位置。如果你的知识库全是中文,这个参数基本可以不用。
真正需要的是中英混排。同一个 chunk_size=60,两种计长方式的结果差得很远:
# tiktoken 用来独立核算 token 数
import tiktoken

# 用于核算的编码器
encoding = tiktoken.get_encoding("cl100k_base")
# 主力切分器
from langchain_text_splitters import RecursiveCharacterTextSplitter

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]
# 一段中英混排的技术文档,很多企业的 API 文档就长这样
MIX_TEXT = (
    "本系统支持 OAuth 2.0 认证。"
    "The authentication endpoint accepts a standard authorization code grant flow. "
    "客户端需在请求头中携带 Bearer token。"
    "Refresh tokens are valid for thirty days by default and can be rotated. "
    "令牌过期后需重新走授权流程。"
)
# 注意这两个数字差了近 3 倍:208 字符只有 73 token
print(f"原文:{len(MIX_TEXT)} 字符 / {len(encoding.encode(MIX_TEXT))} token")
# 两个切分器,唯一区别是长度怎么算
splitters = {
    # 普通构造:chunk_size 的单位是字符
    "字符计长": RecursiveCharacterTextSplitter(
        # 上限 60 字符,不重叠
        chunk_size=60,
        chunk_overlap=0,
        # 中文分隔符 + 句号留句尾
        separators=CN_SEPARATORS,
        keep_separator="end",
    ),
    # from_tiktoken_encoder 构造:chunk_size 的单位变成 token
    "token计长": RecursiveCharacterTextSplitter.from_tiktoken_encoder(
        # 指定用哪个编码来数 token
        encoding_name="cl100k_base",
        # 同样是 60,但单位变成 token
        chunk_size=60,
        chunk_overlap=0,
        # 中文分隔符照样要传,token 计长不解决切断句子的问题
        separators=CN_SEPARATORS,
        keep_separator="end",
    ),
}
# 复用上面定义的两个切分器
for label, splitter in splitters.items():
    # 标题行,区分两组结果
    print(f"\n--- {label} chunk_size=60 ---")
    # 逐块输出
    for i, c in enumerate(splitter.split_text(MIX_TEXT)):
        # 重点看 token 列是否均匀
        print(f"  [{i}] {len(c):>3} 字符 / {len(encoding.encode(c)):>3} token")
运行输出:
原文:208 字符 / 73 token

--- 字符计长 chunk_size=60 ---
  [0]  19 字符 /  13 token
  [1]  46 字符 /   6 token
  [2]  56 字符 /  23 token
  [3]  59 字符 /  11 token
  [4]  26 字符 /  20 token

--- token计长 chunk_size=60 ---
  [0] 122 字符 /  42 token
  [1]  86 字符 /  31 token
对照下来:
- 字符计长切出 5 块,字符数还算整齐(19~59),但 token 数从 6 到 23,差了近 4 倍。那个只有 6 token 的块是纯英文句子——它占的窗口很小,白白浪费了一次检索的配额。
- token 计长切出 2 块,token 数是 42 和 31,均匀得多,而字符数反而参差(122 和 86),因为英文段落被允许长得多。
何时用 token 计长:
| 情况 | 建议 |
|---|---|
| 纯中文知识库 | 按字符即可,实测和 token 计长结果一致,何必多装一个依赖 |
| 中英混排文档(技术文档、API 手册) | 用 token 计长,否则英文块的实际信息量远小于预期 |
| 需要严格控制窗口占用与成本 | 用 token 计长,预算估算更准 |
两点注意:from_tiktoken_encoder 只是改了长度怎么算,不改切分逻辑——中文分隔符还是得自己传;另外它要求装 tiktoken,而 tiktoken 的编码表首次使用时需要联网下载,离线环境要提前准备好缓存。
6. 按结构切分 #
前面是「按长度切」,不认文档结构。企业资料大多有层级(章 / 节 / 小节),顺着结构切,天然得到语义完整的块,还能把标题写进 metadata。
6.1. MarkdownHeaderTextSplitter #
它按 Markdown 标题层级切分,并把各级标题放进 metadata:
# 按 Markdown 标题层级切分的切分器
from langchain_text_splitters import MarkdownHeaderTextSplitter

# 一份三级标题齐全的演示文档
MD = """# 售后手册

## 退换货

签收 7 日内可无理由退货。

### 质量问题

质量问题 15 日内可换货。

## 发货

一般 48 小时内发出。
"""

# headers_to_split_on:(标题标记, 存进 metadata 的键名)
# 键名自己定,建议全项目统一,第 15 章过滤时要用
splitter = MarkdownHeaderTextSplitter(
    # "#" 对应一级标题,"##" 二级,"###" 三级
    headers_to_split_on=[("#", "h1"), ("##", "h2"), ("###", "h3")]
)

# 注意:split_text 返回的是 list[Document],不是字符串列表
# 这是它和其他切分器最不一样的地方
sections = splitter.split_text(MD)

# 三个标题下各有一段正文,所以应该切出 3 段
print("切出段落数:", len(sections))
# 逐段查看正文和标题层级
for section in sections:
    # 分隔线
    print("---")
    # 正文里标题行已被移除
    print("正文:", repr(section.page_content))
    # metadata 记录了这段处于哪一级标题下
    print("标题层级:", section.metadata)
运行输出:
切出段落数: 3
---
正文: '签收 7 日内可无理由退货。'
标题层级: {'h1': '售后手册', 'h2': '退换货'}
---
正文: '质量问题 15 日内可换货。'
标题层级: {'h1': '售后手册', 'h2': '退换货', 'h3': '质量问题'}
---
正文: '一般 48 小时内发出。'
标题层级: {'h1': '售后手册', 'h2': '发货'}
这份 metadata 在第 15 章很有用:
| 用途 | 怎么用 |
|---|---|
| 引用更精确 | 「来源:售后手册 > 退换货 > 质量问题」 |
| 检索前过滤 | 只在 h2 == "退换货" 的块里搜 |
| 给块补上下文 | 把 h1 > h2 拼到正文开头,让块更"自足" |
最后一条很实用:'质量问题 15 日内可换货。' 这句话单独看不知道是什么产品的政策,但拼上标题就清楚了。
这件事不必自己拼——有个 strip_headers=False 参数直接搞定:
# strip_headers 默认是 True,会把标题行从正文里摘掉
# 设成 False 则把标题行保留在正文开头
splitter = MarkdownHeaderTextSplitter(
    # 标题层级配置不变
    headers_to_split_on=[("#", "h1"), ("##", "h2"), ("###", "h3")],
    # 关键改动:保留标题行
    strip_headers=False,
)

# 观察正文里是否出现了 # 开头的标题行
for section in splitter.split_text(MD):
    # 用 repr 才能看到标题后面的换行符
    print(repr(section.page_content))
    # metadata 不受这个参数影响,照样有 h1/h2/h3
    print("   ", section.metadata)
运行输出:
'# 售后手册  \n## 退换货  \n签收 7 日内可无理由退货。'
    {'h1': '售后手册', 'h2': '退换货'}
'### 质量问题  \n质量问题 15 日内可换货。'
    {'h1': '售后手册', 'h2': '退换货', 'h3': '质量问题'}
'## 发货  \n一般 48 小时内发出。'
    {'h1': '售后手册', 'h2': '发货'}
标题连着 # 号一起进了正文。注意两个细节:第一块把 # 售后手册 和 ## 退换货 都带上了(因为这两个标题之间没有正文),而第二块只有 ### 质量问题,上级标题 h1/h2 只在 metadata 里、没进正文。所以 strip_headers=False 给的是「本级标题」,不是「完整标题路径」。
两种做法各有适用:
| 做法 | 正文内容 | 适合 |
|---|---|---|
strip_headers=True(默认)+ 手工拼完整路径 |
[售后手册 > 退换货 > 质量问题] 质量问题 15 日内... |
推荐,路径完整,格式可控(见 §11 练习 4) |
strip_headers=False |
### 质量问题 \n质量问题 15 日内... |
图省事;但 # 号会被一起嵌入,且缺上级标题 |
为何推荐手工拼? 因为进向量库的文本会被原样嵌入,### 这种标记符对语义没有贡献、还占 token;而完整路径「售后手册 > 退换货 > 质量问题」才真正提供了上下文。
还有两点。第一,它只认 Markdown 语法(# 开头的行),纯文本 PDF 转出来的文字没有 #,用不了。喂没有标题的纯文本会怎样?不报错,结果是空的:
# 故意喂一段完全没有 # 标题的纯文本
for section in splitter.split_text("这是一段没有任何标题的中文正文。第二句也是。"):
    # metadata 会是空字典
    print(repr(section.page_content), "|", section.metadata)
运行输出:
'这是一段没有任何标题的中文正文。第二句也是。' | {}原文整段返回,metadata 是空字典 {}。 这是个典型的静默失败:程序正常结束,你以为已按结构切好,其实没拿到任何结构信息。所以 §9.3 流水线要按 file_type 决定是否走标题切分。
第二,split_text 返回的是 list[Document] 而不是 list[str]——与其他切分器的 split_text 不同,容易写错。它没有 split_documents 方法,所以处理第 12 章的 Document 时要先取出 page_content 喂进去,再把文件级 metadata 手工合并回去(§6.2 和 §9.3 都是这么做的)。
6.2. 两段式:先按结构,再按长度 #
MarkdownHeaderTextSplitter 只按标题切,不管长度——某小节三千字,它就切出一块三千字。实践中标准走两段式:
第一段:MarkdownHeaderTextSplitter  按标题切,拿到结构 metadata
              │
              ▼
第二段:RecursiveCharacterTextSplitter  对每个小节再按长度切
              │
              ▼
      既有结构信息、长度又受控的 chunk
完整可运行示例:
# 两个切分器一起用,这就是"两段式"
from langchain_text_splitters import (
    # 第一段:拿结构
    MarkdownHeaderTextSplitter,
    # 第二段:控长度
    RecursiveCharacterTextSplitter,
)

# 中文分隔符
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# 演示文档:「退换货」小节故意写长(78 字),「发货」小节很短(18 字)
MD = """# 售后手册

## 退换货

签收 7 日内可无理由退货,商品需保持完好,包装配件齐全。质量问题 15 日内可换货,需提供照片凭证并联系客服登记。跨境订单以页面公示为准,运费由买家承担。

## 发货

一般 48 小时内发出,节假日顺延。
"""

# 第一段:按标题切出小节
header_splitter = MarkdownHeaderTextSplitter(
    # 三级标题分别存进 h1 / h2 / h3
    headers_to_split_on=[("#", "h1"), ("##", "h2"), ("###", "h3")]
)
# 输出 list[Document],每个 Document 是一个小节
sections = header_splitter.split_text(MD)

# 先看第一段的结果
print("按标题切出:", len(sections))
# 逐个小节看长度
for s in sections:
    # 注意长度:一个 78 字、一个 18 字,标题切分器完全不管长度
    print(f"  {len(s.page_content)} 字 {s.metadata}")

# 把文件级 metadata 补进每个小节,否则第二段切完就不知道来自哪个文件
# MarkdownHeaderTextSplitter 只吃字符串,它不可能知道 source
for s in sections:
    # 文件路径
    s.metadata["source"] = "policy/aftersale.md"
    # 第 12 章生成的文档唯一标识
    s.metadata["doc_id"] = "abc123"

# 第二段:对每个小节按长度切,长的会被切开,短的原样保留
body_splitter = RecursiveCharacterTextSplitter(
    # 上限 40 字,78 字的小节会被切成 3 块
    chunk_size=40,
    # 重叠 8 字(实测不会生效,因为句子都比它长,见 §3.3)
    chunk_overlap=8,
    # 中文分隔符
    separators=CN_SEPARATORS,
    # 句号留句尾
    keep_separator="end",
    # 记录小节内偏移
    add_start_index=True,
)
# 这里必须用 split_documents,才能把上面补的 metadata 传下去
chunks = body_splitter.split_documents(sections)

# 再看第二段的结果
print("\n最终切片:", len(chunks))
# 逐块查看
for c in chunks:
    # 分隔线
    print("---")
    # 正文
    print(c.page_content)
    # 观察 h1/h2 与 source/doc_id 是否都在
    print(c.metadata)
运行输出:
按标题切出: 2
  78 字 {'h1': '售后手册', 'h2': '退换货'}
  18 字 {'h1': '售后手册', 'h2': '发货'}

最终切片: 4
---
签收 7 日内可无理由退货,商品需保持完好,包装配件齐全。
{'h1': '售后手册', 'h2': '退换货', 'source': 'policy/aftersale.md', 'doc_id': 'abc123', 'start_index': 0}
---
质量问题 15 日内可换货,需提供照片凭证并联系客服登记。
{'h1': '售后手册', 'h2': '退换货', 'source': 'policy/aftersale.md', 'doc_id': 'abc123', 'start_index': 29}
---
跨境订单以页面公示为准,运费由买家承担。
{'h1': '售后手册', 'h2': '退换货', 'source': 'policy/aftersale.md', 'doc_id': 'abc123', 'start_index': 58}
---
一般 48 小时内发出,节假日顺延。
{'h1': '售后手册', 'h2': '发货', 'source': 'policy/aftersale.md', 'doc_id': 'abc123', 'start_index': 0}
78 字的「退换货」小节被切成 3 块、18 字的「发货」小节保持 1 块,同时每块都带着 h1 / h2 和文件来源——这就是两段式的价值。
有个细节别漏:最后一块的 start_index 又回到了 0。因为 start_index 是相对被切的那个父文档(这里是「发货」小节)的偏移,不是相对整个文件。
跨父文档比较
start_index没有意义。要在文件内定位,应结合h1/h2或自己记录小节偏移。
合并 metadata 时还要注意顺序。上面是先切标题、再往小节里补 source,所以不存在冲突。但 §9.3 的流水线是反过来的——先有文件级 metadata,再合并标题级,那里就必须写成:
# 先复制文件级 metadata 作为底座
merged = dict(doc.metadata)
# 再用小节的 h1/h2/h3 覆盖上去
merged.update(section.metadata)顺序写反的话(section.metadata 在前、doc.metadata 覆盖在后),文件级字段会把 h1/h2 挤掉——而且不报错,只是结构信息静默消失。这类「顺序写反丢数据」只能靠 §9.5 验收清单里「md 来源的块必须带 h1」这一条来兜底。
7. 选型 #
langchain_text_splitters 里有十几个切分器,初学认识这几个就够:
| 切分器 | 用在什么场景 | 建议 |
|---|---|---|
RecursiveCharacterTextSplitter |
通用正文(txt / PDF / Word 抽出的文本) | 默认首选 |
MarkdownHeaderTextSplitter |
Markdown、有清晰标题的文档 | 配合上面做两段式(§6.2) |
CharacterTextSplitter |
有稳定分隔符(如 \n\n---\n\n)的文本 |
少用;切不动时最后一块超长也不会警告 |
TokenTextSplitter |
严格按 token 硬切 | 不推荐用于中文正文,会切断句子 |
HTMLHeaderTextSplitter |
网页 HTML | 结构清晰的站点可用 |
PythonCodeTextSplitter / LatexTextSplitter |
代码 / LaTeX | 按语言语法边界切 |
RecursiveJsonSplitter |
大 JSON | 按键层级切 |
SemanticChunker(langchain-experimental) |
按语义相似度找边界 | 不作默认选择,理由见下 |
两个「听起来该选、其实不该选」的单独说明——名字最容易误导人:
CharacterTextSplitter 只按一个分隔符切,切完不再兜底。它确实会在块超长时打印 Created a chunk of size ... 警告,但最后一块不经过那道检查——也就是说它可能一声不响地交给你一个几千字的块。递归切分器的 separators 以 "" 结尾、逐字符兜底,不会有这个问题,所以正文一律用递归切分器。
8. 切分质量自检 #
与第 12 章一样:切分事故大多不报错。切出一堆碎片、切断句子,程序都会正常结束,问题往往拖到第 15 章检索变差才暴露,那时已难定位。
三类高频事故:
| 事故 | 现象 | 根因 |
|---|---|---|
| 断句块 | 块首尾是半个词、半个数字 | 中文没传 separators(§4.2) |
| 碎片块 | 一堆十几个字的块 | chunk_size 太小,或分隔符太细 |
| 超长块 | 块长度远超 chunk_size |
用了 CharacterTextSplitter(§7) |
一份可直接用的质检脚本:
# 标准库:解析 jsonl
import json
# 标准库:跨平台路径处理
from pathlib import Path

# Document 类型
from langchain_core.documents import Document

# 与切分时保持一致的参数,这两个值必须和 §9.3 里的一致,否则查出来的结论没意义
CHUNK_SIZE = 80
# 低于这个字数就算碎片
MIN_CHUNK_CHARS = 15

# 正常句子的收尾标记,用来判断块是否被拦腰截断
# 中英标点都列上,中文文档里夹英文句子的情况很常见
END_MARKS = ("。", "!", "?", ";", ":", "”", ")", ".", "!", "?")


# 启发式判断:结尾像不像一句完整的话
def looks_cut_off(text: str) -> bool:
    """块结尾不是句子收尾标记,就可能是断句。"""
    # rstrip() 先去掉尾部空白,否则末尾一个换行就会让判断失效
    # endswith 支持直接传元组,会逐个尝试
    return not text.rstrip().endswith(END_MARKS)


# 主体检函数:五项指标一次打完
def inspect(chunks: list[Document]) -> None:
    # 总数,和输入文档数一起看才有意义
    print(f"chunk 总数:{len(chunks)}")

    # 先把所有块的长度收集起来,后面反复用
    lengths = [len(c.page_content) for c in chunks]
    # 最小值暴露碎片,最大值暴露超长块
    print(
        f"长度:最小 {min(lengths)} / 平均 {sum(lengths) // len(lengths)} / 最大 {max(lengths)}"
    )

    # 长度分布比平均值更有信息量:碎片多还是巨块多,一眼能看出来
    buckets = {"<50": 0, "50-200": 0, "200-500": 0, ">500": 0}
    # 逐个块归入所属区间
    for n in lengths:
        # 按区间归类,注意 elif 保证每个块只被计一次
        if n < 50:
            # 这一档偏多说明参数过小
            buckets["<50"] += 1
        # 50 到 200 之间
        elif n < 200:
            # 中文知识库的理想区间
            buckets["50-200"] += 1
        # 200 到 500 之间
        elif n < 500:
            # 偏大,检索精度会下降
            buckets["200-500"] += 1
        # 500 以上
        else:
            # 出现在这一档基本可以确定切分有问题
            buckets[">500"] += 1
    # 打印四个区间的计数
    print("长度分布:", buckets)

    # 超长块:说明切分器没兜住上限(§7 说的 CharacterTextSplitter 就会这样)
    oversize = [c for c in chunks if len(c.page_content) > CHUNK_SIZE]
    # 这一项必须是 0
    print(f"超过 chunk_size 的块:{len(oversize)}")

    # 过短块:语义残缺,检索时是噪声
    tiny = [c for c in chunks if len(c.page_content) < MIN_CHUNK_CHARS]
    # 若不为 0,说明流水线的过滤没生效
    print(f"过短的块:{len(tiny)}")

    # 断句块:中文项目最该盯的一项
    cut = [c for c in chunks if looks_cut_off(c.page_content)]
    # 注意这是启发式判断,会有误报,报出来的拿去人工看
    print(f"结尾疑似断句的块:{len(cut)}")
    # 只打印前 3 个样本,避免刷屏;结尾 15 字足够判断是不是断在词中间
    for c in cut[:3]:
        # 负索引 [-15:] 取末尾 15 字;repr 能看清空白字符
        print(f"  - {c.metadata.get('chunk_id')} 结尾:...{c.page_content[-15:]!r}")

    # metadata 完整性:source 丢了,第 15 章就没法溯源
    missing = [c for c in chunks if not c.metadata.get("source")]
    # 不为 0 通常意味着某处误用了 split_text
    print(f"缺少 source 的块:{len(missing)}")


# 读取 §9 流水线写出的 chunks.jsonl 做体检
chunks = []
# 必须显式指定 encoding="utf-8",否则中文 Windows 会用 GBK 打开而报错(第 12 章 §4.2)
with Path("chunks.jsonl").open(encoding="utf-8") as f:
    # jsonl 逐行读
    for line in f:
        # 一行一个 JSON 对象
        record = json.loads(line)
        # 还原成 Document,这样质检函数可以复用在切分环节的内存对象上
        chunks.append(
            # 正文和 metadata 分别取出
            Document(page_content=record["page_content"], metadata=record["metadata"])
        )

# 执行体检
inspect(chunks)
对 §9 写出的 chunks.jsonl 实际运行:
chunk 总数:4
长度:最小 12 / 平均 22 / 最大 29
长度分布: {'<50': 4, '50-200': 0, '200-500': 0, '>500': 0}
超过 chunk_size 的块:0
过短的块:1
结尾疑似断句的块:0
缺少 source 的块:0四项归零即达标。注意 looks_cut_off 是个启发式判断,会有误报:比如以「等」「)」之外的字符结尾的表格行、代码片段、列表项,都可能被标成「疑似断句」。用法是「报出来的拿去人工看」,不是「必须为 0」。漏报也有——'质量问题 15' 这种断在数字后面的块,结尾不是标点,能被抓到;但 '……需提供照片凭证。跨境订单以' 这种在块中间就已经跑偏的,它查不出来。
体检清单:
- 超长块为零——否则换成递归切分器
- 断句块接近零——否则检查
separators是否包含中文标点 - 碎片块很少——大量
<50字的块说明参数过小 source/doc_id齐全——第 15 章溯源的前提- 抽样人读 3 个块——最重要的一条:自己读一遍,能不能看懂它在讲什么
前四条是机器能查的,第 5 条只能你自己做。花三分钟读三个块,比调半天参数有用。
9. 高质量切片流水线 #
9.1. 输入输出约定 #
本章实战接在第 12 章之后,组成可重复运行的流水线:
ingested.jsonl(第 12 章产物:整页 / 整篇 Document)
        │
        ▼  split.py
① md 文件走两段式:标题切分 → 长度切分(§6.2)
② 其他格式走中文参数的递归切分(§4.2 / §4.3)
③ 丢弃过短碎片,补 chunk 级 metadata
④ 打印质量报告(§8)
        │
        ▼
chunks.jsonl  ← 第 14 章向量化的输入
chunk 级 metadata 在文件级基础上新增三个字段:
| 字段 | 含义 | 为什么需要 |
|---|---|---|
chunk_index |
该 chunk 在其父文档中的序号 | 排序、拼回上下文 |
chunk_id |
doc_id-序号,全局唯一 |
向量库的主键,更新资料时精准替换 |
char_len |
字符数 | 质检与调参时免得重复计算 |
9.2. 准备演示输入 #
若没跑第 12 章,可用下面代码生成演示用的 ingested.jsonl(格式与第 12 章写入的完全一致)。
# 标准库:序列化成 jsonl
import json
# 标准库:路径处理
from pathlib import Path

# 带 Markdown 标题的制度文档,用来演示两段式切分
AFTERSALE_MD = """# 售后手册

## 退换货

签收 7 日内可无理由退货,商品需保持完好,包装与配件齐全。质量问题 15 日内可换货,需提供照片凭证并联系客服登记。跨境订单以页面公示为准,退回运费由买家承担。

## 发货时效

一般订单 48 小时内发出,节假日顺延。预售商品以商品页标注的发货时间为准,如遇缺货会主动联系并可全额退款。
"""

# 纯文本 FAQ,走普通递归切分
FAQ_TXT = """问:发货要多久?
答:一般 48 小时内发出,节假日顺延。

问:可以修改收货地址吗?
答:未发货前可在订单详情页自助修改,已发货请联系快递方处理。
"""

# 模拟一页 PDF 的内容,metadata 里带 page 字段
MANUAL_PAGE = (
    "开机后指示灯亮起,按下模式键可切换手动与自动档。"
    "选择自动档后,风速会根据空气质量自动调节。"
    "滤芯到期时指示灯会闪红灯,此时需更换滤芯。"
    "更换完成后长按复位键三秒,计时器归零。"
)

# 每条记录的结构与第 12 章 ingest.py 的输出一致
RECORDS = [
    # 第一条:Markdown 制度文档,会走两段式
    {
        # 正文
        "page_content": AFTERSALE_MD,
        # 文件级 metadata
        "metadata": {
            # 相对路径,第 15 章用它显示出处
            "source": "policy/aftersale.md",
            "file_name": "aftersale.md",
            # 关键字段:流水线靠它决定走不走标题切分
            "file_type": "md",
            # 文档唯一标识,chunk_id 的前缀
            "doc_id": "a1b2c3d4e5f6",
            # UTC 时间,便于判断资料新旧
            "loaded_at": "2026-08-12T14:00:00+00:00",
        },
    },
    # 第二条:纯文本 FAQ
    {
        # 正文
        "page_content": FAQ_TXT,
        # 文件级 metadata
        "metadata": {
            "source": "faq.txt",
            "file_name": "faq.txt",
            # txt 走普通递归切分
            "file_type": "txt",
            "doc_id": "b3b4f59f2504",
            "loaded_at": "2026-08-12T14:00:00+00:00",
        },
    },
    # 第三条:模拟 PDF 的一页
    {
        # 正文
        "page_content": MANUAL_PAGE,
        # 文件级 metadata
        "metadata": {
            "source": "manual.pdf",
            "file_name": "manual.pdf",
            # pdf 也走普通递归切分
            "file_type": "pdf",
            "doc_id": "c7d8e9f0a1b2",
            # PDF 特有的页码,验证它能被 chunk 继承
            "page": 11,
            # 总页数,第 15 章展示来源时可以用
            "total_pages": 20,
            "loaded_at": "2026-08-12T14:00:00+00:00",
        },
    },
]

# 输出文件名与第 12 章写入的 ingested.jsonl 保持一致
out = Path("ingested.jsonl")
# "w" 覆盖写;encoding 必须显式指定,否则中文 Windows 会用 GBK
with out.open("w", encoding="utf-8") as f:
    # 逐条写入
    for record in RECORDS:
        # ensure_ascii=False 让中文原样写入,而不是变成 \uXXXX 转义
        # 每条记录后加换行,构成 jsonl(一行一个 JSON)
        f.write(json.dumps(record, ensure_ascii=False) + "\n")

# 确认写了几条
print(f"已生成演示输入 {out},共 {len(RECORDS)} 个 Document")
运行输出:
已生成演示输入 ingested.jsonl,共 3 个 Document三条演示数据覆盖流水线三条路径:md 走两段式(会拿到 h1/h2)、txt 走普通递归切分、pdf 走普通递归切分但带 page 字段。跑完 §9.3 可对照检查三种情况是否符合预期。
9.3. split.py #
"""切片流水线:ingested.jsonl → chunks.jsonl(第 14 章的输入)"""

# 让 list[Document] 这类新式类型注解在旧版 Python 上也能用
from __future__ import annotations

# 标准库:jsonl 读写
import json
# 标准库:路径处理
from pathlib import Path

# Document 类型
from langchain_core.documents import Document
# 两个切分器:标题切分 + 长度切分
from langchain_text_splitters import (
    # 第一段用:按 Markdown 标题切
    MarkdownHeaderTextSplitter,
    # 第二段用:按长度切
    RecursiveCharacterTextSplitter,
)

# 第 12 章写入的 ingested.jsonl
INPUT_FILE = Path("ingested.jsonl")
# 本章写出的 chunks.jsonl,交给第 14 章向量化
OUTPUT_FILE = Path("chunks.jsonl")

# 演示数据较短,故意把 chunk_size 设小以便看清切分效果
# 真实中文知识库建议 300~800,overlap 取 size 的 15%~25%(见 §3.4)
CHUNK_SIZE = 80
# 取 size 的 25%,且大于典型句长,这样重叠才真的会发生(§3.3)
CHUNK_OVERLAP = 20
# 短于此长度的块视为碎片,直接丢弃
MIN_CHUNK_CHARS = 15

# 中文分隔符,从大到小排列;不传这个参数会退化成逐字硬切(§4.2)
CN_SEPARATORS = ["\n\n", "\n", "。", "!", "?", ";", ",", "、", " ", ""]

# Markdown 标题层级 → metadata 键名
HEADERS = [("#", "h1"), ("##", "h2"), ("###", "h3")]


# 第一步:把 jsonl 读回内存
def load_documents(path: Path) -> list[Document]:
    """把 jsonl 还原成 Document 列表。"""
    # 收集结果的容器
    docs: list[Document] = []
    # 显式 utf-8,否则中文 Windows 默认 GBK 会解码失败
    with path.open(encoding="utf-8") as f:
        # 逐行读取,jsonl 的每一行是一个独立 JSON
        for line in f:
            # 去掉行尾换行
            line = line.strip()
            # 跳过空行,避免文件末尾多一个换行就报错
            if not line:
                # continue 跳到下一行
                continue
            # 解析这一行的 JSON
            record = json.loads(line)
            # 还原成 Document 对象
            docs.append(
                # 两个字段一一对应
                Document(
                    # 正文
                    page_content=record["page_content"],
                    # 文件级 metadata 原样带进来
                    metadata=record["metadata"],
                )
            )
    # 返回全部文档
    return docs


# 第二步之一:切分器工厂函数,参数只在这里出现一次
def build_body_splitter() -> RecursiveCharacterTextSplitter:
    """构造正文切分器,中文参数集中在这里,便于统一调整。"""
    # 每次调用返回一个新实例;切分器本身无状态,复用也可以
    return RecursiveCharacterTextSplitter(
        # 长度上限
        chunk_size=CHUNK_SIZE,
        # 重叠长度
        chunk_overlap=CHUNK_OVERLAP,
        # 中文分隔符,这是最关键的一个参数
        separators=CN_SEPARATORS,
        # 让句号留在前一块末尾,符合中文阅读习惯
        keep_separator="end",
        # 记录块在父文档中的偏移,便于调试与溯源
        add_start_index=True,
    )


# 第二步之二:md 的切分策略
def split_markdown(doc: Document) -> list[Document]:
    """Markdown 走两段式:先按标题,再按长度(§6.2)。"""
    # 第一段:按标题切,返回 list[Document],metadata 里只有 h1/h2/h3
    sections = MarkdownHeaderTextSplitter(headers_to_split_on=HEADERS).split_text(
        # 它只吃字符串,所以要取出正文
        doc.page_content
    )
    # 标题切分器只给出 h1/h2/h3,文件级 metadata 要手动合并进去
    for section in sections:
        # 先复制文件级 metadata(source / doc_id / page 等)作为底座
        merged = dict(doc.metadata)
        # 用 section 的键覆盖,保证 h1/h2 不被文件级字段挤掉
        # 顺序写反会静默丢掉结构信息(§6.2 末尾)
        merged.update(section.metadata)
        # 把合并结果装回小节
        section.metadata = merged
    # 第二段:按长度切,metadata 会自动继承
    return build_body_splitter().split_documents(sections)


# 第二步之三:其他格式的切分策略
def split_plain(doc: Document) -> list[Document]:
    """非 Markdown 直接按长度切。"""
    # 注意 split_documents 要的是列表,所以把单个 doc 包一层
    return build_body_splitter().split_documents([doc])


# 第三步:统一过滤与编号
def finalize(chunks: list[Document]) -> list[Document]:
    """丢弃碎片,并补齐 chunk 级 metadata。"""
    # 每个父文档单独计数,保证 chunk_index 从 0 连续递增
    counters: dict[str, int] = {}
    # 通过筛选的块放这里
    kept: list[Document] = []

    # 遍历所有文档切出来的全部块
    for chunk in chunks:
        # 去掉首尾空白,标题切分器的产物可能带空行
        text = chunk.page_content.strip()
        # 过短的块语义残缺,留在库里只会当噪声被召回
        if len(text) < MIN_CHUNK_CHARS:
            # continue 直接跳过,注意此时计数器不加,所以序号不会出现空洞
            continue
        # 把清理后的文本写回去
        chunk.page_content = text

        # 取父文档标识;理论上一定存在,用 get 兜底避免脏数据导致崩溃
        doc_id = chunk.metadata.get("doc_id", "unknown")
        # 该文档已经产出过几块
        index = counters.get(doc_id, 0)
        # 计数器加一,供下一块使用
        counters[doc_id] = index + 1

        # 块在父文档内的序号,可用来把上下文拼回去
        chunk.metadata["chunk_index"] = index
        # chunk_id 作为向量库主键:资料更新时可按 doc_id 前缀批量删除旧块
        # 补零到 4 位,保证字符串排序和数字顺序一致
        chunk.metadata["chunk_id"] = f"{doc_id}-{index:04d}"
        # 存下字符数,质检和调参时免得重复计算
        chunk.metadata["char_len"] = len(text)
        # 留用
        kept.append(chunk)

    # 返回过滤并编号后的结果
    return kept


# 第二步总入口:按类型分派
def split_all(docs: list[Document]) -> list[Document]:
    """按文件类型分派切分策略。"""
    # 汇总所有文档的切分结果
    chunks: list[Document] = []
    # 逐个文档处理
    for doc in docs:
        # 只有 md 才有 # 标题可用,其他格式走标题切分只会拿到空 metadata(§6.1)
        if doc.metadata.get("file_type") == "md":
            # 两段式
            chunks.extend(split_markdown(doc))
        # txt / pdf / docx 等都走这一支
        else:
            # 单段长度切分
            chunks.extend(split_plain(doc))
    # 统一在最后做过滤和编号,保证 chunk_index 连续
    return finalize(chunks)


# 第四步:质量报告
def report(docs: list[Document], chunks: list[Document]) -> None:
    """打印切分质量报告(§8)。"""
    # 输入输出数量对比,是最粗但最有用的一个指标
    print(f"输入 {len(docs)} 个 Document → 输出 {len(chunks)} 个 chunk")

    # 直接读 finalize 里存好的 char_len,不用重新数
    lengths = [c.metadata["char_len"] for c in chunks]
    # 空列表会让 min/max 报错,先判断
    if lengths:
        # 三个数字看长度分布是否合理
        print(
            f"长度:最小 {min(lengths)} / 平均 {sum(lengths) // len(lengths)} / 最大 {max(lengths)}"
        )

    # 超长块说明切分器没兜住上限,必须为 0
    oversize = [c for c in chunks if c.metadata["char_len"] > CHUNK_SIZE]
    # 这一行的输出是验收清单第 1 条
    print(f"超过 chunk_size({CHUNK_SIZE}) 的块:{len(oversize)}")
    # 有问题时打印前 3 个样本便于定位
    for c in oversize[:3]:
        # 报出 chunk_id 才能在 chunks.jsonl 里找到它
        print(f"  - {c.metadata['chunk_id']} {c.metadata['char_len']} 字")

    # 按来源统计:某个文件只切出 1 块,往往意味着加载阶段就出了问题
    print("\n按来源统计:")
    # key 是 source,value 是块数
    by_source: dict[str, int] = {}
    # 逐块累加
    for c in chunks:
        # get 的第二个参数是默认值,实现"没有就从 0 开始累加"
        by_source[c.metadata["source"]] = by_source.get(c.metadata["source"], 0) + 1
    # 排序输出,保证每次运行结果顺序一致,方便 diff
    for src, count in sorted(by_source.items()):
        # 文件名与块数
        print(f"  {src}: {count}")


# 第五步:落盘
def save_jsonl(chunks: list[Document], path: Path) -> None:
    """一行一个 chunk,方便第 14 章按行读取。"""
    # "w" 覆盖写,保证重复运行不会追加出重复数据
    with path.open("w", encoding="utf-8") as f:
        # 逐块序列化
        for c in chunks:
            # 只存这两个字段,和第 12 章的格式保持一致
            record = {"page_content": c.page_content, "metadata": c.metadata}
            # ensure_ascii=False 保留中文原文,便于人工检查
            f.write(json.dumps(record, ensure_ascii=False) + "\n")


# 只有直接运行本文件时才执行,被 import 时不执行
if __name__ == "__main__":
    # 提前检查输入文件,给出可操作的提示,而不是抛一个 FileNotFoundError
    if not INPUT_FILE.exists():
        # SystemExit 会让脚本以非 0 状态退出,适合在流水线里被上层捕获
        raise SystemExit(
            f"找不到 {INPUT_FILE},请先运行第 12 章的 ingest.py 或本章 §9.2 的脚本"
        )

    # 1. 读入第 12 章写入的 ingested.jsonl
    docs = load_documents(INPUT_FILE)
    # 2. 按类型分派切分并补齐 metadata
    chunks = split_all(docs)
    # 3. 落盘,供第 14 章使用
    save_jsonl(chunks, OUTPUT_FILE)

    # 4. 打印质量报告,切完必看
    report(docs, chunks)

    # 提示输出位置
    print(f"\n已写入 {OUTPUT_FILE}")
    # 抽样输出,供人工过目
    print("\n前两个 chunk:")
    # 抽样人读,这是质检里最有效的一步(§8)
    for c in chunks[:2]:
        # 分隔线,便于肉眼区分两个块
        print("---")
        # 看正文是否完整、有没有断句
        print(c.page_content)
        # 看 metadata 是否齐全
print(c.metadata)脚本把「读取 → 分派 → 收尾 → 报告 → 落盘」拆成五个函数,不是为了好看,而是切分参数需要反复调——各环节独立,改 build_body_splitter 里的几个数字,其余不动即可重跑。finalize 单独拆出也有道理:过滤碎片和编号必须在所有文档都切完之后统一做,否则 chunk_index 会因中途丢块而出现空洞。
9.4. 运行结果 #
用 §9.2 的演示输入实际运行:
输入 3 个 Document → 输出 6 个 chunk
长度:最小 19 / 平均 49 / 最大 74
超过 chunk_size(80) 的块:0

按来源统计:
  faq.txt: 1
  manual.pdf: 2
  policy/aftersale.md: 3

已写入 chunks.jsonl

前两个 chunk:
---
签收 7 日内可无理由退货,商品需保持完好,包装与配件齐全。质量问题 15 日内可换货,需提供照片凭证并联系客服登记。
{'source': 'policy/aftersale.md', 'file_name': 'aftersale.md', 'file_type': 'md', 'doc_id': 'a1b2c3d4e5f6', 'loaded_at': '2026-08-12T14:00:00+00:00', 'h1': '售后手册', 'h2': '退换货', 'start_index': 0, 'chunk_index': 0, 'chunk_id': 'a1b2c3d4e5f6-0000', 'char_len': 59}
---
跨境订单以页面公示为准,退回运费由买家承担。
{'source': 'policy/aftersale.md', 'file_name': 'aftersale.md', 'file_type': 'md', 'doc_id': 'a1b2c3d4e5f6', 'loaded_at': '2026-08-12T14:00:00+00:00', 'h1': '售后手册', 'h2': '退换货', 'start_index': 59, 'chunk_index': 1, 'chunk_id': 'a1b2c3d4e5f6-0001', 'char_len': 22}
几处值得对照:
- 每块都以句号结尾,没有一处断在词中间——这就是中文
separators+keep_separator="end"的效果 - Markdown 文档的块带着
h1/h2,纯文本和 PDF 的块没有,说明两段式只对 md 生效 chunk_id形如a1b2c3d4e5f6-0000,前缀是doc_id——资料更新时按前缀就能删掉这个文件的所有旧块
想一次看清全部 6 个块的关键字段,加一段:
# 逐块打印 chunk_id、长度、以及两个关键 metadata
for c in chunks:
    # 三个字段拼成一行,方便横向对比
    print(f"[{c.metadata['chunk_id']}] {c.metadata['char_len']:>3}字 "
          # 用 get 取值:非 PDF 没有 page,非 md 没有 h2,缺失时显示 -
          f"page={c.metadata.get('page', '-')} h2={c.metadata.get('h2', '-')}")
    # 只看开头 50 字,确认没有断句
    print(f"    {c.page_content[:50]}")
运行输出:
[a1b2c3d4e5f6-0000]  59字 page=- h2=退换货
    签收 7 日内可无理由退货,商品需保持完好,包装与配件齐全。质量问题 15 日内可换货,需提供照片凭
[a1b2c3d4e5f6-0001]  22字 page=- h2=退换货
    跨境订单以页面公示为准,退回运费由买家承担。
[a1b2c3d4e5f6-0002]  54字 page=- h2=发货时效
    一般订单 48 小时内发出,节假日顺延。预售商品以商品页标注的发货时间为准,如遇缺货会主动联系并可全
[b3b4f59f2504-0000]  74字 page=- h2=-
    问:发货要多久?
答:一般 48 小时内发出,节假日顺延。

问:可以修改收货地址吗?
答:未发货前
[c7d8e9f0a1b2-0000]  66字 page=11 h2=-
    开机后指示灯亮起,按下模式键可切换手动与自动档。选择自动档后,风速会根据空气质量自动调节。滤芯到期时
[c7d8e9f0a1b2-0001]  19字 page=11 h2=-
    更换完成后长按复位键三秒,计时器归零。
下表摊开三条路径的差别:
| 来源 | 块数 | h2 |
page |
说明 |
|---|---|---|---|---|
policy/aftersale.md |
3 | 有 | 无 | 两段式生效,两个小节各自受长度约束 |
faq.txt |
1 | 无 | 无 | 74 字未超上限,整篇一块 |
manual.pdf |
2 | 无 | 11 | 第 12 章的页码被完整继承 |
page=11 这一列很关键:第 15 章就靠它说出「依据是手册第 11 页」。metadata 能传到这里,因为全程用了 split_documents——任一步误用 split_text,字段就会丢。
9.5. 验收清单 #
- 无超长块:报告里「超过 chunk_size 的块」为 0
- 无断句:抽查块首尾是完整句子(用 §8 的
looks_cut_off批量查) - metadata 继承完整:第 12 章的
source/doc_id/page都还在 - 结构信息就位:md 来源的块带
h1/h2(这条能兜住 §6.2 提到的合并顺序写反) - chunk_id 唯一:
len(set(ids)) == len(ids) - 可重复运行:同样输入跑两次,
chunks.jsonl内容一致(便于增量更新对比)
第 5 条可以直接用一行验证:
# 取出所有 chunk_id
ids = [c.metadata["chunk_id"] for c in chunks]
# set 会自动去重,长度相等说明没有重复
print("chunk_id 唯一:", len(set(ids)) == len(ids))
运行输出:
chunk_id 唯一: True为何重要? 因为向量库通常把它当主键。如果有重复,写入时要么覆盖掉前一条(数据静默丢失),要么产生两条同 id 的记录(更新时删不干净)。重复很容易发生——比如把 finalize 里的计数器写成全局单一计数、或者两个不同文件算出了相同的 doc_id。
第 14 章会把 chunks.jsonl 里每个 chunk 转成向量存进向量库,chunk_id 就是那里的主键。
10. 实用约定与坑 #
上线前可当 Code Review 清单:
| 约定 | 说明 |
|---|---|
显式传 chunk_size |
默认 4000 字符,忘了传等于没切(§3.1) |
中文必传 separators |
不传就是逐字硬切(§4.2) |
中文建议 keep_separator="end" |
句号留在句尾,块更完整 |
用 split_documents 而非 split_text |
否则 metadata 全丢 |
开 add_start_index=True |
调参时判断重叠是否生效的唯一可靠依据 |
| 参数集中在一处定义 | 全项目统一,便于整体重切 |
chunk_id 用 doc_id 作前缀 |
资料更新时能按文件精准删旧块 |
| 改了切分参数要全量重切 | 新旧参数混在同一个向量库里,检索表现会很怪 |
| 切完必做质检 | 超长、碎片、断句都不报错(§8) |
常见坑分三类。静默类最危险——不报错、不警告,往往藏到第 15 章检索变差才暴露:
| 现象 | 原因 | 处理 |
|---|---|---|
| 块大得像没切过 | 忘了传 chunk_size,用了默认的 4000 |
显式指定(§3.1) |
| 块切在词/数字中间 | 中文用了默认 separators |
传中文标点分隔符(§4.2) |
| 设了 overlap 但明显没重叠 | 尾部片段比 overlap 长(§3.3) | 用 start_index 确认;加大 overlap 或接受无重叠 |
| chunk 的 metadata 是空的 | 用了 split_text |
换 split_documents(§4.4) |
块长度远超 chunk_size,且没有任何警告 |
CharacterTextSplitter 的最后一块不经过警告检查 |
换递归切分器(§7) |
md 文档的块没有 h1/h2 |
合并 metadata 时顺序写反,文件级字段把标题挤掉了 | dict(doc.metadata) 在前、update(section.metadata) 在后(§6.2) |
Markdown 标题没进 metadata,且 metadata 是 {} |
文本里其实没有 # 标题 |
PDF 抽出的文本用不了标题切分(§6.1) |
| 语义切分结果里有 0 字空块 | 零宽断言在文末多产生一个空串,min_chunk_size 拦不住 |
自己过滤:[c for c in chunks if c.strip()](§7) |
chunk_id 有重复 |
计数器写成了全局单一计数 | 按 doc_id 分别计数(§9.5) |
看得见类——输出里一眼能发现:
| 现象 | 原因 | 处理 |
|---|---|---|
| 块首出现孤零零的「。」 | keep_separator 用了默认值(True,等同 "start") |
改成 "end"(§4.3) |
| 句子粘连、块被填到正好等于上限 | keep_separator=False 丢掉了分隔符 |
中文不要用 False(§4.3) |
| 一堆十几个字的碎片 | chunk_size 太小 |
加大 size,并过滤 MIN_CHUNK_CHARS |
SemanticChunker 一刀没切 |
默认断句正则 (?<=[.?!])\s+ 是按英文设计的 |
传 sentence_split_regex=r"(?<=[。!?;])"(§7) |
| 语义切分出现几千字的巨块 | 它只看语义、没有 chunk_size |
后接一个递归切分器兜住长度(§7) |
理解类——不是 bug,是概念没对上:
| 疑问 | 解释 |
|---|---|
start_index 跨块比较对不上 |
它是相对父文档的偏移,两段式切分后每个小节都从 0 开始(§6.2) |
| 换成 token 计长,结果一点没变 | 纯中文字符数≈token 数,本来就该没变化;它是给中英混排用的(§5.2) |
| overlap 设了却让块数变多 | 这是正常的:重复内容占了长度配额,块多了成本也高(§3.3) |
口诀:
切分的唯一标准是「块能不能被人独立读懂」;中文先修
separators,再谈调参。
11. 练习 #
先做机制验证类(几分钟一项,亲手验证本章反直觉结论):
- 默认值有多大:不传任何参数构造一个
RecursiveCharacterTextSplitter,用它切一篇两千字的中文文档,看切出几块。再解释为什么。 - 验证 overlap:把 §9.3 的
CHUNK_OVERLAP从 20 改成 60,用start_index确认重叠是否真的出现了。再改成 5,确认它完全不生效。 keep_separator四种取值:对同一段文本跑"end"/"start"/True/False,把四组输出并排贴出来,确认True和"start"完全一致。- 让
CharacterTextSplitter报警告:构造两段测试文本,一段让它静默产出超长块,一段让它打印Created a chunk of size ...警告,并说明区别在哪。 - 空块能进向量库吗:手工造一个 0 字块(就是一个空字符串
"",§7 说的语义切分空串就是这么来的),不过滤直接留在chunks.jsonl里,想一想第 14 章会发生什么(学完第 14 章回来验证)。
再做能力构建类(对应真实项目需求):
- 对照实验:把 §9.3 的
CN_SEPARATORS换成默认分隔符(删掉这个参数),重跑并用 §8 脚本统计「断句块」数量,感受差距。 - 参数扫描:对同一份资料用
chunk_size= 100 / 300 / 800 各跑一遍,比较块数与平均长度,记下你的判断。 - 标题补正文:改
split_markdown,把h1 > h2拼到每块正文开头(如[售后手册 > 退换货] 签收 7 日内...),让块更自足。做完再和strip_headers=False的效果对比,说说为什么手工拼更好(§6.1)。 - token 计长:把
build_body_splitter改成from_tiktoken_encoder版本,对比同一份资料的块数变化。如果资料是纯中文,你应该看到几乎没变化——那就再找一份中英混排的技术文档试试。 - 加格式:给流水线加上 HTML 支持(提示:
HTMLHeaderTextSplitter),并补一条验收用例。 - (扩展)表格保护:找一份含 Markdown 表格的文档,检查表格是否被切开;试着在切分前把表格整体提取成独立 chunk。
- (扩展,需第 14 章的 API Key)语义切分对照:找一段没有段落结构的长文(会议纪要、访谈转录都行),分别用
SemanticChunker和递归切分器切一遍,人工判断哪个的块边界更合理。记得按 §7 的提醒传中文sentence_split_regex,否则它一刀都不会切;再自己包一层计数器,数一下它为了找边界多嵌入了多少条句子——那就是这个方案的额外成本。
12. 本章小结 #
切分是 RAG 里性价比最高的优化点:它不花模型调用费,改动几个参数就能显著影响检索质量。也最容易被忽视——切坏了不报错。
- chunk 是检索单位,好 chunk 的标准是自足(独立可读)且单一(只讲一件事)。
chunk_size是上限不是目标,单位默认为字符,默认值 4000 大到等于不切,必须显式传(§3.1)。中文 1 字 ≈ 1~2 token,生僻字可到 2~3。chunk_overlap保留整段分隔片段:源码里是current_doc = current_doc[1:]整段丢弃,所以尾部片段比 overlap 长时重叠根本不会发生——用add_start_index验证,别只看参数(§3.3)。RecursiveCharacterTextSplitter是默认首选,因为它的separators以""结尾,逐字符兜底保证不超长。- 中文必须自己传
separators(加入。!?;,)并用keep_separator="end",否则会逐字硬切、把句子劈开。默认值是True(等同"start"),False会让句子粘连(§4.3)。 - 用
split_documents而不是split_text,否则第 12 章补上的 metadata 全丢,而且add_start_index也失去意义。 - Markdown 走两段式:
MarkdownHeaderTextSplitter拿结构 → 递归切分器控长度。合并 metadata 要文件级在前、标题级在后,写反会静默丢掉h1/h2(§6.2)。 - token 计长是给中英混排用的:纯中文实测和字符计长结果完全一致,中英混排时字符计长会让 token 数在块间差 4 倍(§5.2)。
- 切完必须质检:超长块、碎片块、断句块,加上人读三个块。特别注意
CharacterTextSplitter的超长块可能一声不响(§7)。 - 语义切分(
SemanticChunker)值得知道,但不该作默认选择:中文要先修断句正则,长度不可控、要额外付一遍嵌入费,还会产出 0 字空块;而且langchain-experimental已被官方标记 sunset——实测在有结构信号的中文文档上打不过递归切分(§7)。 - 本章实战:高质量切片流水线,输出
chunks.jsonl。
下一章:Embeddings 与向量库——把 chunk 转成向量存入 Chroma / FAISS,第一次「按语义找内容」。