1. 审批流 #
1.1 项目介绍 #
本项目是一条对外答复审批流:客户售后诉求进来,代码先做校验和风控,Agent 只负责查订单、查政策、起草答复,人工点头之后才真的发出去,全程留审计流水。
它把第 19~27 章的图、确定性节点、改稿循环、interrupt 人机协同、检查点持久化,收进同一份脚本:八个节点里只有 draft 是 Agent,其余全是普通 Python 函数。demo 用内存检查点一次跑完七条路径;submit / pending / decide / show 用 sqlite 落盘,提交和审批可以是两个进程、中间隔几天。
为什么选这个场景?因为它把「模型能力」和「业务约束」的矛盾暴露得最清楚。答复要模型来写,这是它擅长的;但「必须先风控」「必须人工批准才能发」「发出去必须归档」这三条,一条都不能指望模型自觉。学完应能判断业务流程里哪些步骤必须是确定性节点、如何把「驳回 → 改稿 → 再审」做成带次数上限的循环、如何让发送只执行一次,并用一套 CLI 完成跨进程的提交与审批。
1.2 先定边界,再写代码 #
模型负责判断,图负责保证。
电商客服要给客户一份正式答复。写句子、查订单、查政策,是模型擅长的。但「必须先风控」「必须人工点头才能发」「发出去必须归档」这三条,一条都不能指望模型自觉。判断标准就一句话:
这一步做错了,是「答复质量差一点」,还是「出事」?
前者可以交给模型,后者必须是代码。按这个标准过一遍需求:
| 编号 | 要求 | 交给谁 |
|---|---|---|
| F1 | 订单号必须存在,诉求不能为空 | 代码(submit) |
| F2 | 客户原话里的手机号脱敏后才能进模型 | 代码(risk_check) |
| F3 | 金额超过 5000 元直接拒绝,不走 Agent | 代码(risk_check) |
| F4 | 金额低于 200 元自动通过,不占人工 | 代码(risk_check + auto_pass) |
| F5 | 其余由 Agent 查事实、查政策后起草 | Agent(draft_node) |
| F6 | 人工可以批准 / 要求改稿 / 驳回 | 代码 + 人(review) |
| F7 | 改稿最多两次,超了自动作废 | 代码(after_review) |
| F8 | 只有批准后才真的发送,且只发一次 | 代码(边 + send) |
| F9 | 无论发没发都要归档,留完整审计流水 | 代码(archive + audit) |
| F10 | 提交和审批可以是两个进程,中间可以隔几天 | 代码(SqliteSaver) |
| F11 | 同一个工单号重复提交要被拦住 | 代码(cmd_submit) |
结果是:八个节点里只有一个是 Agent,其余七个都是普通 Python 函数。 真实业务图里这很典型。Agent 通常只占一小块,外面全是确定性骨架。
漏斗顺序也写死了:代码校验(微秒、免费)→ 模型起草(秒级、按 token 计费)→ 人工审批(最贵)。便宜的放前面。F3 让不该处理的请求在花模型钱之前就被拦下;F4 省的不是模型钱,而是人的时间。
反面写法是把风控做成 Agent 的一个工具,再在系统提示里写「必须先调用」。提示词是请求,图里的边才是保证。第 28 章 §3.2 把这段反例写全了,这里不重复粘贴:risk 必须落在 START → submit → risk 这条链上,不经过它就到不了 draft。
2. 图长什么样 #
动手之前先把形状钉死。八个节点,三个分支点,一个循环:
graph TD;
        __start__([<p>__start__</p>]):::first
        submit(submit)
        risk(risk)
        draft(draft)
        review(review)
        auto(auto)
        send(send)
        abort(abort)
        archive(archive)
        __end__([<p>__end__</p>]):::last
        __start__ --> submit;
        abort --> archive;
        auto --> send;
        draft -.-> abort;
        draft -.-> auto;
        draft -.-> review;
        review -.-> abort;
        review -.-> draft;
        review -.-> send;
        risk -.-> abort;
        risk -.-> draft;
        send --> archive;
        submit --> risk;
        archive --> __end__;
        classDef default fill:#f2f0ff,line-height:1.2
        classDef first fill-opacity:0
        classDef last fill:#bfb6fc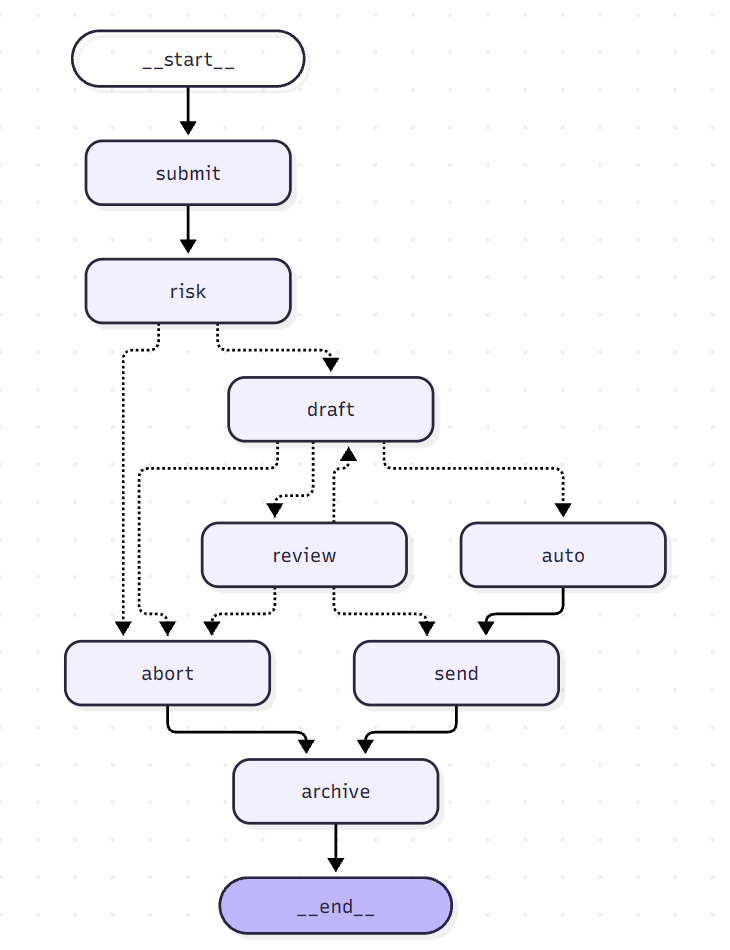
四个设计要点,后面写代码时会反复撞上:
send和abort都汇到archive:归档覆盖所有终止路径,不是靠每个节点自己记得调一下(F9)。review是唯一会暂停的节点,也是唯一会被重跑的节点,所以里面绝对不能有副作用。review → draft那条回边就是改稿循环,出口条件写在路由函数里,不写在节点里。- 三个分支点的依据全部来自确定性代码或人,没有一个来自模型输出。模型只写
draft,没法决定流程往哪儿走。
| 节点 | 类型 | 会暂停 | 有副作用 | 会被重跑 |
|---|---|---|---|---|
submit |
确定性 | |||
risk |
确定性 | |||
draft |
Agent | 改稿时会 | ||
review |
确定性 | 是 | 是 | |
auto |
确定性 | |||
send |
确定性 | 是 | ||
abort |
确定性 | |||
archive |
确定性 |
必须盯的是两格:review 的「会被重跑」和 send 的「有副作用」,它们必须落在不同的行上。 把发送写进 review,客户会收到两封邮件。
配套命令:
uv run python flow.py demo
uv run python flow.py submit R001 A1002 "键盘按键不灵,想退货"
uv run python flow.py pending
uv run python flow.py decide R001 approve --approver 张三
uv run python flow.py show R001
3. 第一步:导入、环境、业务常量 #
文件头先把依赖和三道业务门槛摆出来。后面所有节点都从这里取数,不要在节点里写魔法数字。
"""第 28 章:对外答复审批流。

一条完整可独立运行的脚本:客户诉求进来,风控先过一遍,Agent 起草答复,
人工审批,批准后才真的发出去,全程留痕。
"""

# operator.add 给 revisions / audit 当累加 reducer
import operator
# 正则用于脱敏和出口泄漏自检
import re
# sqlite3 给 SqliteSaver 提供连接
import sqlite3
# 命令行子命令
import argparse
# 生成器返回类型
from collections.abc import Iterator
# Annotated 挂 reducer,Any 表示 payload,Literal 声明路由出口,TypedDict 声明状态
from typing import Annotated, Any, Literal, TypedDict

# 从 .env 读 DEEPSEEK_API_KEY
from dotenv import load_dotenv
# 造起草 Agent
from langchain.agents import create_agent
# 把普通函数注册成工具
from langchain_core.tools import tool
# 节点往 custom 流里写进度
from langgraph.config import get_stream_writer
# 内存检查点:demo 用,跑完就散
from langgraph.checkpoint.memory import InMemorySaver
# 文件检查点:跨进程审批靠它
from langgraph.checkpoint.sqlite import SqliteSaver
# 图的三件套
from langgraph.graph import END, START, StateGraph
# Command 用来恢复,interrupt 用来暂停
from langgraph.types import Command, interrupt

# 覆盖已有同名环境变量,避免系统里残留旧 Key
load_dotenv(override=True)

# F3:超过这个金额直接拒绝,不进 Agent
HARD_LIMIT = 5000
# F4:低于这个金额自动通过,不占人工
AUTO_LIMIT = 200
# F7:改稿次数上限,超了作废
MAX_REVISIONS = 2
# 检查点数据库文件,跨进程靠它接力
DB_PATH = "approval_flow.sqlite"
load_dotenv(override=True) 必须在造 Agent 之前。系统环境里如果残留着过期的 DEEPSEEK_API_KEY,不覆盖就会用错钥匙。
三道门槛对应三条路径:
自动通过 < 200 <= 人工审批 <= 5000 < 直接拒绝正好 200、正好 5000 都走人工。边界值用严格不等号,上线后被财务追问时有据可查。第 28 章 §6.2 专门强调过这一点。
DB_PATH 和 InMemorySaver 并存,是因为同一张图要配两种存储:demo 用内存(跑多少次结果都一样,也不留垃圾文件),submit / decide / show / pending 用 sqlite(进程退出后状态还在)。后面 build_graph(checkpointer) 就是为这件事留的口。
4. 第二步:状态是公共黑板 #
状态是所有节点共享的字典(第 20、21 章)。审批流要装三类东西:业务数据、流转状态、审计痕迹。TypedDict 把键和类型写死,少一个键会在节点里 KeyError。
class ApprovalState(TypedDict):
    """所有节点共享的黑板。三类字段:业务数据、流转状态、审计痕迹。"""

    # 工单号,同时用作 thread_id,是幂等与跨进程定位的钥匙
    request_id: str
    # 订单号,风控与工具查询都要用
    order_id: str
    # 客户原话(可能含手机号)。保留原文是审计要求,不能原地改
    raw: str
    # 脱敏后的诉求,给 Agent 用的是这个。脱敏是派生,不是替换
    clean: str
    # 风控档位:ok(走人工)/ auto(小额自动)/ reject(拒绝)
    risk: str
    # 风控备注,会进审计流水,也会显示给审批人
    risk_note: str
    # 当前草稿正文
    draft: str
    # 人工决策:approve / revise / reject
    decision: str
    # 驳回或改稿意见,改稿时要连同上一稿一起喂给模型
    feedback: str
    # 审批人署名,进审计流水(F9 的一部分)
    approver: str
    # 终态:sent(发了)/ rejected(驳回或风控拒)/ expired(改稿超次数作废)
    status: str
    # 改稿计数器。必须带 reducer,且节点要返回增量,两者配套才有效
    revisions: Annotated[int, operator.add]
    # 审计流水。用 add 让每个节点各追加自己那条
    audit: Annotated[list[str], operator.add]
按用途分类,每个字段最好只有一个明确写入者:
| 类别 | 字段 | 谁写 |
|---|---|---|
| 入参(不可变) | request_id order_id raw |
入口一次写入 |
| 派生数据 | clean risk risk_note |
risk(失败时 submit / draft 也会写 risk) |
| 流转状态 | draft decision feedback approver status |
draft / review / auto / send / abort |
| 累积痕迹 | revisions audit |
各节点追加 |
两个细节:
raw 和 clean 是两个字段,不是原地改。 保留原文是审计要求;进模型的只能是 clean。脱敏是派生,不是替换。
status 有三个终态。 sent 是发出去了,rejected 是诉求本身不该通过,expired 是改了两次还不满意。后两个分开记,才能把「这一单有问题」和「提示词 / 政策库有系统性差距」区分开。
4.1 两个 reducer 必须和返回值配套 #
revisions:护栏靠它。写成Annotated[int, operator.add],节点每次返回{"revisions": 1}表示加一。audit:只增不改。每个节点各追加自己那一条,谁也覆盖不了谁。
第 28 章 §4.3 用一张不调模型的小图把四种组合跑穿了,结论直接拿来用:
| 字段类型 | 节点返回 | 结果 |
|---|---|---|
Annotated[int, add] |
增量 1 |
正确,本章用这个 |
Annotated[int, add] |
绝对值 n |
停得了,计数虚高 |
裸 int |
增量 1 |
护栏失效,死循环直到 GraphRecursionError |
裸 int |
绝对值 n |
功能也对,但不支持多写入者 |
本章选第一格:字段带 add,draft_node 返回增量 1。只改其中一半都会错,而且不一定报错。审查循环护栏时,第一件事是回去看计数器的字段声明。
5. 第三步:订单库、进度事件、初始状态工厂 #
5.1 假订单库 #
真实项目里这是一次数据库查询。三张单刚好对应三档风控:
ORDERS = {
    # 小额单,用来演示自动通道
    "A1001": {"item": "无线耳机", "amount": 129, "days": 10},
    # 中等金额,走人工审批的主力样本
    "A1002": {"item": "机械键盘", "amount": 459, "days": 3},
    # 超过硬上限,用来演示零成本拒绝
    "A1003": {"item": "曲面显示器", "amount": 5200, "days": 2},
}
A1001 → auto,A1002 → 人工,A1003 → 直接拒。A9999 不在库里,用来验 F1。
5.2 emit:进度协议收敛到一个函数 #
八个节点都要往外发进度。如果各自 writer({...}),迟早有人漏掉去重键。协议收敛到一个函数:
def emit(writer, state: ApprovalState, stage: str, status: str, text: str = "") -> None:
    """统一发进度事件。带上稿件序号 n,用来区分循环第二稿和恢复时的重发。"""
    # stage / status / text 给人看,n 用于去重
    writer({"stage": stage, "status": status, "text": text, "n": state["revisions"]})
n 是第 28 章相对第 27 章新加的。去重键如果只是 stage:status,改稿循环的第二稿也会发 draft:done 和 review:waiting,会被当成「恢复时的重发」丢掉。加上稿件序号:
| 场景 | 事件键 | 该怎么办 |
|---|---|---|
恢复执行,review 重跑重发 |
review:waiting:1(n 没变) |
丢掉 |
| 循环回来,第二稿的审批 | review:waiting:2(n 变了) |
留下 |
节点里不要直接 print。直接写 stdout 和走事件队列是两条路,顺序不受控,「已发送」可能排到「开始发送」前面。
5.3 new_request:字段必须给全 #
TypedDict 的类型检查只在静态分析时有用。运行时它就是个普通字典:少给一个键,直到某个节点读它才会炸,那时模型钱可能已经花了。用工厂函数兜住:
def new_request(request_id: str, order_id: str, raw: str) -> dict:
    """状态用 TypedDict,字段必须给全,否则节点里会 KeyError。"""
    return {
        "request_id": request_id,
        "order_id": order_id,
        "raw": raw,
        "clean": "",
        "risk": "",
        "risk_note": "",
        "draft": "",
        "decision": "",
        "feedback": "",
        "approver": "",
        "status": "",
        "revisions": 0,
        "audit": [],
    }
"audit": [] 必须写在函数里面。如果提到外面做成模块级默认列表,所有工单会共享同一个对象。每次调用新建一个 [],才不会串单。
这个函数还是「字段清单」的唯一来源:以后加字段,改这里会立刻提醒你初始值该是什么。
6. 第四步:只读工具 + 起草 Agent #
Agent 只负责「查事实、写草稿」。发不发由图决定。工具箱里没有任何能改变外部世界的东西。
@tool
def query_order(order_id: str) -> str:
    """按订单号查询商品、金额和签收天数。"""
    # 用 get 而不是下标,查不到时返回 None 而不是抛 KeyError
    order = ORDERS.get(order_id)
    if not order:
        # 返回文本而不是抛异常:工具异常会中断 Agent
        return f"订单 {order_id} 不存在"
    return f"订单 {order_id}:{order['item']},{order['amount']} 元,已签收 {order['days']} 天"


@tool
def query_policy(topic: str) -> str:
    """查询售后政策条款,topic 可以是 退货 / 退款 / 运费。"""
    return {
        "退货": "签收后 7 天内可无理由退货,需商品完好。",
        "退款": "审核通过后 3 个工作日内退回原支付渠道。",
        "运费": "满 99 元包邮,退货运费由责任方承担。",
    }.get(topic, "无此条款")


drafter_agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    tools=[query_order, query_policy],
    system_prompt=(
        "你是电商客服。先用工具查清订单事实和适用政策,再写一段答复草稿。"
        "要求:直接称呼客户、说明结论和依据、80 字以内、只输出草稿正文,不要解释你的思路。"
    ),
)
三个刻意选择:
- 工具只读。 Agent 能做的最坏的事是写一段不合适的草稿,而草稿必须过人工才能出去。限制它能造成的最大伤害,比使劲儿让它别犯错更可靠。
- 返回自然语言,不是
dict。 返回值会作为ToolMessage回灌给模型,「机械键盘,459 元,已签收 3 天」比 JSON 更不容易搞错单位。 - 「只输出草稿正文」写进系统提示。 省掉后续清洗。思考过程如果混进
draft,审批人看到的就不是客户将要收到的那句话。
drafter_agent 在模块加载时就建好。它还不会调模型;真正花钱发生在后面 draft_node 的 invoke。
7. 第五步:确定性入口 submit 和 risk #
7.1 submit:校验,失败也返回 dict #
这一步不该交给模型。模型会编一个不存在的订单号出来还答得很自信。
def submit(state: ApprovalState) -> dict:
    """确定性:校验入参。这一步不该交给模型判断。"""
    writer = get_stream_writer()
    emit(writer, state, "submit", "start", "校验工单")
    oid = state["order_id"]
    # F1 上半:订单号必须存在
    if oid not in ORDERS:
        return {
            "risk": "reject",
            "risk_note": f"订单 {oid} 不存在",
            "audit": [f"submit:未知订单 {oid}"],
        }
    # F1 下半:诉求不能为空
    if not state["raw"].strip():
        return {"risk": "reject", "risk_note": "诉求为空", "audit": ["submit:诉求为空"]}
    return {"audit": [f"submit:{state['request_id']} 订单 {oid}"]}
校验失败也返回 dict,而不是 raise。 图里抛异常等于整条流程原地爆炸:下游 archive 不执行,这一单没有任何审计记录。边的语义是「上游成功则下游执行」,不是 try/finally(第 25 章)。把失败写成一次正常的状态更新,流程照常走 abort → archive:失败也有终态,也有审计。
risk_note 和 audit 都写一遍,看起来重复,其实不是。risk_note 是当前状态,给审批人看,后面可以被覆盖;audit 是历史流水,只增不改。
这个节点没做幂等。因为「这个工单以前跑过吗」不在状态里,而在 checkpointer 里,节点看不到自己的历史。幂等放在入口 cmd_submit,见第 13 步。
7.2 risk_check:脱敏 + 三档风控 #
整条流水线性价比最高的一段:花几微秒正则,省的是后面 Agent 的模型费。
def risk_check(state: ApprovalState) -> dict:
    """确定性:脱敏 + 硬性风控。放在 Agent 之前,不合规的请求一分钱模型费都不花。"""
    writer = get_stream_writer()
    emit(writer, state, "risk", "start", "风控检查")
    # submit 已经判死就直接返回,否则 ORDERS[...] 会 KeyError
    if state["risk"] == "reject":
        return {}
    # 脱敏:手机号中间四位打掉
    clean = re.sub(r"(1[3-9]\d)\d{4}(\d{4})", r"\1****\2", state["raw"])
    masked = clean != state["raw"]
    order = ORDERS[state["order_id"]]
    amount = order["amount"]
    notes = [f"金额 {amount} 元"]
    if masked:
        notes.append("已脱敏手机号")
    if amount > HARD_LIMIT:
        risk = "reject"
        notes.append(f"超过硬上限 {HARD_LIMIT} 元")
    elif amount < AUTO_LIMIT:
        risk = "auto"
        notes.append(f"低于 {AUTO_LIMIT} 元,自动通道")
    else:
        risk = "ok"
    note = ";".join(notes)
    emit(writer, state, "risk", "done", note)
    return {
        "clean": clean,
        "risk": risk,
        "risk_note": note,
        "audit": [f"risk:{risk} {note}"],
}开头那三行提前返回是必要的。submit 可能已经判了「订单不存在」,这时 ORDERS[state["order_id"]] 会 KeyError,流程炸掉、审计丢失。返回空 dict 表示什么都不改,去哪儿交给路由。demo 里路径六能看到现场证据:risk 只发了 start 没发 done。
脱敏必须在调模型之前,而且必须是代码。提示词里写「不要输出手机号」挡不住「手机号已经进了模型请求体」。数据一旦出境,无论模型输出什么都无法挽回。archive 还会在出口再扫一遍,那是纵深防御,两道都要有。
masked = clean != state["raw"] 比先搜一遍正则更直接:「有没有脱敏」和「替换了没有」是同一件事,也不会出现搜的正则和替换的正则不一致。
8. 第六步:唯一的 Agent 节点 draft #
父图状态里没有 messages。Agent 内部的工具调用留在子图里,只把最终草稿带回来(第 25 章的消息隔离)。
def draft_node(state: ApprovalState) -> dict:
    """Agent 节点:只把最终草稿带回父图,内部的工具消息不污染父状态。"""
    writer = get_stream_writer()
    # 当前是第几稿:状态里存的是已完成稿数,本次是它 +1
    n = state["revisions"] + 1
    emit(writer, state, "draft", "start", f"起草第 {n} 稿")
    task = f"客户诉求:{state['clean']}\n订单号:{state['order_id']}"
    if state["feedback"]:
        task += f"\n\n上一稿被驳回。上一稿内容:{state['draft']}\n修改意见:{state['feedback']}"
    try:
        out = drafter_agent.invoke({"messages": [{"role": "user", "content": task}]})
        text = out["messages"][-1].content
    except Exception as exc:
        return {
            "risk": "reject",
            "risk_note": f"起草失败:{type(exc).__name__}",
            "revisions": 1,
            "audit": [f"draft:失败 {type(exc).__name__}"],
        }
    emit(writer, state, "draft", "done", f"第 {n} 稿 {len(text)} 字")
    return {"draft": text, "revisions": 1, "audit": [f"draft:第 {n} 稿 {len(text)} 字"]}
四个决定:
n只用于显示,不写回状态。 真正的加一发生在返回值{"revisions": 1}里,和 §4.1 第一格配套。try/except不是摆设。 Agent 一抛异常,下游archive不会执行。模型 5xx、超时、限流都是常态。接住之后失败变成正常流转,能走到归档。- 失败时
revisions也 +1。 失败不计数,又发生在改稿循环里,就会一直失败、一直重试、护栏永远不触发。任何进入循环的路径都必须推进计数器。 - 异常只记类型,不记堆栈。 堆栈里可能带着请求体片段,而状态要落盘、要长期保存。完整堆栈进日志系统,不进工单状态。
改稿时把上一稿全文和意见一起给模型。只给意见,模型会凭空重写,上一稿里审批人满意的部分也会被改掉。
任务用 clean 不是 raw。到这里手机号已经打成 138****5678。模型最多只能复述这个占位串,完整号码在物理上到不了模型那边。
9. 第七步:审批、自动通过、发送、作废、归档 #
9.1 review:唯一会暂停的节点 #
def review(state: ApprovalState) -> dict:
    """人工审批:在这里暂停。本节点会在恢复时从头重跑,所以不能放副作用。"""
    writer = get_stream_writer()
    emit(writer, state, "review", "waiting", "等待人工审批")
    decision = interrupt(
        {
            "request_id": state["request_id"],
            "draft": state["draft"],
            "revisions": state["revisions"],
            "risk_note": state["risk_note"],
            "actions": ["approve", "revise", "reject"],
        }
    )
    if isinstance(decision, dict):
        action = decision.get("action", "reject")
        return {
            "decision": action,
            "feedback": decision.get("feedback", ""),
            "approver": decision.get("approver", ""),
            "audit": [f"review:{action} by {decision.get('approver') or '未署名'}"],
        }
    return {"decision": str(decision), "audit": [f"review:{decision}"]}
interrupt() 不是把函数冻在那一行。它抛出一个特殊异常把整张图挂起。恢复时 LangGraph 没有「从第 5 行继续」这种能力,只能把这个节点从第一行重新调用一遍,然后让 interrupt() 直接返回 resume 值。
所以 interrupt() 之前的代码会执行两次。判断标准只有一条:执行两次会不会出问题。 发进度事件没问题。发邮件、扣款、写外部库全都不行。副作用必须放到后面的 send。
另外三个选择:
interrupt()的值要自带上下文。 审批人拿到草稿全文、第几稿、风控备注、合法动作。pending直接渲染这个 value,不必再查一遍状态。actions让前端按它画按钮,动作集合变了不必改前端。- resume 用 dict。 一次带回动作、意见、署名。署名进审计流水,这是 F9。
isinstance兜底是为了让Command(resume="approve")这种简写也能用。 - 取不到
action时默认reject,不是approve。 默认值要选出错代价最小的分支。误驳回的代价远小于误发出。
9.2 auto_pass:小额也要留痕 #
def auto_pass(state: ApprovalState) -> dict:
    """小额自动通道:不占人工,但一样留痕。"""
    return {"decision": "approve", "approver": "auto", "audit": ["auto:小额自动通过"]}
看起来可以省掉:让 after_draft 把小额直接路由到 send。不行。send 读 approver 写审计;没有这个记账节点,审计里分不清「机器放过的」和「人批的」。approver="auto" 就是为了这一笔账。
9.3 send:副作用独占一个节点 #
def send(state: ApprovalState) -> dict:
    """副作用独占一个节点。它在人工决策之后,所以只会执行一次。"""
    writer = get_stream_writer()
    emit(writer, state, "send", "done", f"已向客户发送:{state['draft']}")
    return {
        "status": "sent",
        "audit": [f"send:已发出({state['approver'] or '未署名'} 批准)"],
    }
它在 review / auto 之后,不在循环回边上,所以不会被重跑。演示里用 emit 代替真发邮件;接真实渠道时,发信代码只应出现在这个函数里。
9.4 abort 和 archive:所有路的收口 #
def abort(state: ApprovalState) -> dict:
    """所有不发送的路径都汇总到这里,保证终态明确。"""
    reason = state["feedback"] or state["risk_note"] or "未说明"
    status = "expired" if state["decision"] == "revise" else "rejected"
    return {"status": status, "audit": [f"abort:{status} 原因 {reason}"]}


def archive(state: ApprovalState) -> dict:
    """确定性后处理:无论发没发都要归档。顺手做一次泄漏自检。"""
    writer = get_stream_writer()
    leak = bool(re.search(r"1[3-9]\d{9}", state["draft"] or ""))
    emit(writer, state, "archive", "done", f"归档 {state['status']}")
    return {
        "audit": [f"archive:{state['status']} 稿件数 {state['revisions']} 泄漏={leak}"]
    }
abort 的 or 链保证原因永远有值:人给的意见优先,其次风控备注,再没有就写「未说明」。空原因的审计记录等于没有记录。decision == "revise" 时终态是 expired 而不是 rejected,对应 F7 超次数作废。
archive 记 泄漏=False 而不是「检查通过」,是为了让机器能检索:like '%泄漏=True%' 一句就能筛出可疑单据。state["draft"] or "" 也不是多余的:风控直接拒绝的路径根本没起草,收口节点一崩,所有工单都会失去归档。
10. 第八步:三个路由函数 #
路由是纯函数:只读状态,只返回下一个节点名。Literal 把合法出口写进类型,和后面 path_map 对得上。
def after_risk(state: ApprovalState) -> Literal["draft", "abort"]:
    """风控出口:只有 reject 不进 Agent。"""
    return "abort" if state["risk"] == "reject" else "draft"


def after_draft(state: ApprovalState) -> Literal["review", "auto", "abort"]:
    """起草出口:失败去 abort,小额走 auto,其余交人工。"""
    if state["risk"] == "reject":
        return "abort"
    return "auto" if state["risk"] == "auto" else "review"


def after_review(state: ApprovalState) -> Literal["send", "draft", "abort"]:
    """三种决策 + 改稿次数上限。"""
    d = state["decision"]
    if d == "approve":
        return "send"
    if d == "revise":
        return "draft" if state["revisions"] < MAX_REVISIONS else "abort"
    return "abort"
after_draft 用 risk == "reject" 识别起草失败,是一种复用:不新增字段,借用已有风控档位表达「此路不通」。代价是 risk 有两个写入者(risk_check 和 draft_node 的失败分支)。字段数量还少的时候可以接受;出现第三种「此路不通」,就该加字段。
after_review 里那行 state["revisions"] < MAX_REVISIONS 怎么读都是对的。它能不能生效,取决于几十行之外 revisions 的字段类型。护栏失效的表现不是报错,而是流程一直改下去,直到撞上递归上限。
调试时可以单独调这些函数,不必起整张图:
after_review({"decision": "revise", "revisions": 2})  # 'abort'
after_review({"decision": "revise", "revisions": 1})  # 'draft'
11. 第九步:组装成图 #
def build_graph(checkpointer):
    """把八个节点和三个分支点装成一张图。"""
    builder = StateGraph(ApprovalState)
    builder.add_node("submit", submit)
    builder.add_node("risk", risk_check)
    builder.add_node("draft", draft_node)
    builder.add_node("review", review)
    builder.add_node("auto", auto_pass)
    builder.add_node("send", send)
    builder.add_node("abort", abort)
    builder.add_node("archive", archive)
    builder.add_edge(START, "submit")
    builder.add_edge("submit", "risk")
    builder.add_conditional_edges("risk", after_risk, ["draft", "abort"])
    builder.add_conditional_edges("draft", after_draft, ["review", "auto", "abort"])
    builder.add_conditional_edges("review", after_review, ["send", "draft", "abort"])
    builder.add_edge("auto", "send")
    builder.add_edge("send", "archive")
    builder.add_edge("abort", "archive")
    builder.add_edge("archive", END)
    return builder.compile(checkpointer=checkpointer)
三处 add_conditional_edges 都传了第三个参数 path_map。第 23 章的结论:不传的话,路由返回一个不存在的节点名时图会静默终止,没有任何报错。审批流宁可炸,也不要静默走错。path_map 顺便还是可读性文档:看 ["send", "draft", "abort"] 就知道审批之后可能去哪三个地方。
checkpointer 作为参数传入,而不是在函数里自己造。同一张图才能配 InMemorySaver 和 SqliteSaver。图的结构(节点、边)是代码,每次启动重新构造;状态(跑到哪、当前值)在检查点里。代码无状态,状态在外面——所有能跨进程恢复的系统都是这个形态。
12. 第十步:事件层 #
图吐出来的是 LangGraph 的多路流,前端要的是业务事件。翻译放在 to_events,打印放在 run。接 Web 时只改 run,to_events 一行都不用碰。
def to_events(graph, payload: Any, cfg: dict, seen: set[str]) -> Iterator[dict]:
    """把图的多路流翻译成前端事件。seen 由调用方按 thread 持有,用于跨恢复去重。"""
    paused = False
    try:
        for mode, chunk in graph.stream(
            payload, cfg, stream_mode=["custom", "updates"]
        ):
            if mode == "custom":
                key = f"{chunk.get('stage')}:{chunk.get('status')}:{chunk.get('n')}"
                if key in seen:
                    continue
                seen.add(key)
                yield {"type": "stage", **chunk}
            elif "__interrupt__" in chunk:
                itr = chunk["__interrupt__"][0]
                paused = True
                yield {"type": "interrupt", "id": itr.id, "value": itr.value}
    except Exception as exc:
        yield {"type": "error", "message": f"{type(exc).__name__}: {exc}"}
        return
    yield {"type": "paused"} if paused else {"type": "done"}
同时订 custom 和 updates:前者是 emit 发出来的进度,后者里的 __interrupt__ 是暂停信号。最后用一个终结事件明确告诉调用方:是停在审批处,还是整条流程跑完了。
seen 按 thread 持有。去重键必须含 n,理由见 §5.2。
SEEN: dict[str, set[str]] = {}


def run(graph, payload, request_id: str) -> dict | None:
    """跑一段,打印事件,返回暂停信息(没暂停就返回 None)。"""
    cfg = {"configurable": {"thread_id": request_id}}
    seen = SEEN.setdefault(request_id, set())
    pause = None
    for ev in to_events(graph, payload, cfg, seen):
        t = ev["type"]
        if t == "stage":
            print(
                f"  [{ev['stage']:7s}] {ev.get('status', ''):8s} {ev.get('text', '')}".rstrip()
            )
        elif t == "interrupt":
            pause = ev
            print(f"  [pause  ] 等待审批,第 {ev['value']['revisions']} 稿")
            print(f"            草稿:{ev['value']['draft']}")
        elif t == "error":
            print(f"  [error  ] {ev['message']}")
    return pause
run 返回「有没有暂停」,不是「跑完了没有」。cmd_demo 靠它判断还要不要提交下一个决策:护栏把流程送去 abort 之后 pause 是 None,后面的 revise 不再提交。
thread_id 用工单号。幂等、跨进程定位、去重集合,三件事共用同一把钥匙。
已知缺口: SEEN 只活在进程内。同一进程里恢复审批,review:waiting:1 会被挡住;新进程里 SEEN 是空的,同一条事件会再打一遍。第 28 章 §8.2 把这个差异留在实测输出里,§12 讨论补法(前端按 id 去重,或把 SEEN 换成 Redis)。教学脚本保持这个缺口,避免把「去重也要持久化」藏过去。
13. 第十一步:只读查询和四条业务命令 #
13.1 show #
def show(graph, request_id: str) -> None:
    """只读:打印一个工单的现状与完整审计流水。"""
    snap = graph.get_state({"configurable": {"thread_id": request_id}})
    if snap.created_at is None:
        print(f"[!] 工单 {request_id} 不存在")
        return
    status = snap.values.get("status") or "审批中"
    print(
        f"  工单 {request_id} | 状态 {status} | 稿件数 {snap.values.get('revisions', 0)} | next={snap.next}"
    )
    for line in snap.values.get("audit", []):
        print(f"    · {line}")
没跑过的 thread,get_state 不抛异常,返回空快照:created_at 是 None。查错单号应该给一句人话,而不是堆栈。status 为空说明还停在半路,统一显示成「审批中」。next=() 表示已结束,next=('review',) 表示停在审批处——运维排查先看它,比翻 audit 快。
13.2 cmd_submit:幂等在入口 #
def cmd_submit(graph, args) -> None:
    """提交工单:先做幂等检查,再跑第一段。"""
    cfg = {"configurable": {"thread_id": args.request_id}}
    if graph.get_state(cfg).created_at is not None:
        print(
            f"[!] 工单 {args.request_id} 已存在,忽略重复提交。用 show 查看当前状态。"
        )
        return
    print(f"=== 提交工单 {args.request_id} ===")
    run(graph, new_request(args.request_id, args.order_id, args.raw), args.request_id)
    show(graph, args.request_id)
同一个 request_id 再提交一次,不是新建工单,而是在旧状态上再跑一遍图。可能把已经在等审批的那一稿冲掉,甚至走到 send,客户收到第二份答复。这类 bug 只在「重复提交」这个偶发条件下出现,测试几乎撞不到,所以必须在入口拦住,一个字节都不写。
13.3 cmd_pending:先收集再查询 #
def cmd_pending(graph, args) -> None:
    """列出所有待审批工单。先收集 thread_id,再逐个查,避免 SqliteSaver 死锁。"""
    tids = {
        c.config["configurable"]["thread_id"] for c in graph.checkpointer.list(None)
    }
    found = False
    for tid in sorted(tids):
        snap = graph.get_state({"configurable": {"thread_id": tid}})
        if snap.interrupts:
            found = True
            itr = snap.interrupts[0]
            print(
                f"  {tid} | 第 {itr.value['revisions']} 稿 | {itr.value['risk_note']}"
            )
            print(f"      {itr.value['draft']}")
    if not found:
        print("  没有待审批的工单")
checkpointer.list() 返回生成器,遍历期间持有数据库游标;循环里再 get_state() 会在 SqliteSaver 上死锁:不是报错,是进程挂住不动。写成集合推导式先把 thread_id 全部取出来,游标关掉再逐个查。这不是优化,是必须。
待办信息都在 interrupt 的 value 里,不必读 snap.values。空队列也要打印「没有待审批的工单」,否则分不清「没有」和「命令挂了」。
13.4 cmd_decide:两道前置检查 #
def cmd_decide(graph, args) -> None:
    """提交审批决策:先确认这单真的在等审批。"""
    cfg = {"configurable": {"thread_id": args.request_id}}
    snap = graph.get_state(cfg)
    if snap.created_at is None:
        print(f"[!] 工单 {args.request_id} 不存在")
        return
    if not snap.interrupts:
        print(
            f"[!] 工单 {args.request_id} 当前不在审批中"
            f"(next={snap.next} status={snap.values.get('status')})"
        )
        return
    print(f"=== 审批 {args.request_id}:{args.action} ===")
    resume = {
        "action": args.action,
        "feedback": args.feedback or "",
        "approver": args.approver or "",
    }
    run(graph, Command(resume=resume), args.request_id)
show(graph, args.request_id)| 检查 | 拦住的情况 | 提示方式 |
|---|---|---|
created_at is None |
工单号打错了 | 「不存在」 |
not snap.interrupts |
这单已经处理完了 | 把 next 和 status 一起打出来 |
第二条如果不拦:对已经 sent 的工单再 resume,碰巧 next 是空的所以无害。不要依赖碰巧无害。
Command(resume=...) 让图从 review 继续。resume 的 dict 就是 interrupt() 的返回值。
13.5 cmd_demo:七条路径 + 幂等 #
全部用内存检查点,不碰 sqlite,也不受「第二次跑被幂等拦住」影响。
def cmd_demo(graph, _args=None) -> None:
    """七条路径 + 幂等:全部用内存检查点,不碰 sqlite。"""
    scenarios = [
        ("D-auto", "A1001", "签收十天了想退货,我手机 13812345678", []),
        (
            "D-approve",
            "A1002",
            "键盘按键不灵,想退货",
            [{"action": "approve", "approver": "张三"}],
        ),
        (
            "D-revise",
            "A1002",
            "键盘有问题要退",
            [
                {
                    "action": "revise",
                    "feedback": "语气再客气些,并写明 7 天时限",
                    "approver": "李四",
                },
                {"action": "approve", "approver": "李四"},
            ],
        ),
        (
            "D-reject",
            "A1002",
            "想退货",
            [
                {
                    "action": "reject",
                    "feedback": "客户已超时且无质量问题",
                    "approver": "王五",
                }
            ],
        ),
        ("D-hard", "A1003", "显示器要退货", []),
        ("D-bad", "A9999", "这单要退", []),
        (
            "D-loop",
            "A1002",
            "键盘用着不顺手,想退",
            [
                {"action": "revise", "feedback": "第 1 次意见", "approver": "赵六"},
                {"action": "revise", "feedback": "第 2 次意见", "approver": "赵六"},
                {"action": "revise", "feedback": "第 3 次意见", "approver": "赵六"},
            ],
        ),
    ]
    for rid, oid, raw, decisions in scenarios:
        print(f"\n【{rid}】订单 {oid}:{raw}")
        pause = run(graph, new_request(rid, oid, raw), rid)
        for decision in decisions:
            if pause is None:
                break
            print(f"  --- 审批:{decision['action']} ---")
            pause = run(graph, Command(resume=decision), rid)
        show(graph, rid)
    print("\n【幂等】重复提交 D-approve")
    dup = argparse.Namespace(request_id="D-approve", order_id="A1002", raw="再交一次")
    cmd_submit(graph, dup)
每条场景是四元组:工单号、订单号、诉求、后续审批决策列表。没有决策的三条(自动通过、超上限、未知订单)跑完就结束。路径七故意塞三次 revise,第二次之后 pause is None,第三次根本不会发出去——护栏生效的表现是流程安静地走向 expired。
14. 第十二步:命令行入口 #
sqlite 那四个命令共用同一张图、同一个数据库文件。每个进程都重新建图,状态在文件里接力。
def dispatch(args) -> None:
    """命令行入口的主体:四个落盘子命令共用同一张图与同一个数据库。"""
    with sqlite3.connect(DB_PATH, check_same_thread=False) as conn:
        graph = build_graph(SqliteSaver(conn))
        print(graph.get_graph().draw_mermaid())
        if args.cmd == "submit":
            cmd_submit(graph, args)
        elif args.cmd == "decide":
            cmd_decide(graph, args)
        elif args.cmd == "show":
            show(graph, args.request_id)
        elif args.cmd == "pending":
            cmd_pending(graph, args)
check_same_thread=False 是 SqliteSaver 的常规写法:LangGraph 可能在不同线程里碰这个连接。draw_mermaid() 把当前图结构打到终端,方便对照 §2 那张流程图;它只出现在 sqlite 这条路上,demo 不会刷屏。
def main() -> None:
    """解析子命令并分发。"""
    ap = argparse.ArgumentParser(description="第 28 章:对外答复审批流")
    sub = ap.add_subparsers(dest="cmd", required=True)

    p_submit = sub.add_parser("submit", help="提交工单")
    p_submit.add_argument("request_id")
    p_submit.add_argument("order_id")
    p_submit.add_argument("raw")

    p_decide = sub.add_parser("decide", help="审批")
    p_decide.add_argument("request_id")
    p_decide.add_argument("action", choices=["approve", "revise", "reject"])
    p_decide.add_argument("--feedback", default="")
    p_decide.add_argument("--approver", default="")

    p_show = sub.add_parser("show", help="查看工单")
    p_show.add_argument("request_id")
    sub.add_parser("pending", help="列出待审批")
    sub.add_parser("demo", help="七条路径演示(内存检查点)")

    args = ap.parse_args()
    if args.cmd == "demo":
        cmd_demo(build_graph(InMemorySaver()), args)
        return
    dispatch(args)


if __name__ == "__main__":
    main()
choices=["approve", "revise", "reject"] 让非法动作在解析阶段就被挡住。这和 review 里 decision.get("action", "reject") 是两道独立防线:一道挡住手滑打错的命令,一道挡住程序化调用时的意外值。接了 HTTP 之后 argparse 这道就不存在了,节点内兜底仍然要留。
demo 单独走内存图,有两个原因:不污染 approval_flow.sqlite;幂等检查不会让第二次演示「没有输出」。
到这里 flow.py 就齐了。
configurations
{
    "version": "0.2.0",
    "configurations": [

        {
            "name": "Python Debugger: Current File",
            "type": "debugpy",
            "request": "launch",
            "program": "${file}",
            "console": "integratedTerminal",
            "args": ["demo"]
        }
    ]
}
15. 跑起来看什么 #
15.1 七条路径(内存) #
uv run python flow.py demo草稿措辞和字数每次会变,节点序列和终态不会变。对照时盯后两样。
| 工单 | 验的需求 | 该看到的结构 |
|---|---|---|
D-auto |
F2 + F4 | 有脱敏备注,没有 review,approver=auto,status=sent |
D-approve |
F6 + F8 | 暂停一次,批准后 send,同一进程内没有第二遍 [review] waiting |
D-revise |
F7 | 两稿,第二稿键是 review:waiting:2,去重挡不住它也不该挡 |
D-reject |
F6 | 没有 send,abort 原因是人写的 feedback |
D-hard |
F3 | 稿件数 0,没有任何 draft 事件 |
D-bad |
F1 | risk 只有 start 没有 done,原因是未知订单 |
D-loop |
F7 | 两次改稿后 status=expired,第三次 revise 不会发出去 |
| 幂等 | F11 | [!] 工单 D-approve 已存在 |
D-hard 和 D-approve 并排看最有说服力:同一套代码,一条零次模型调用,一条一次,区别只在于校验放在 Agent 前面还是后面。
D-auto 里模型有时会把 138****5678 当成称呼写进开头。这不是安全问题(泄漏=False 是对的),但发出去别扭。真要上线,脱敏时最好换成 [客户手机号] 这种明显不是称呼的记号。完整实测输出见第 28 章 §8.1。
15.2 跨进程审批(sqlite) #
六条命令是六次独立的进程启动。它们之间没有共享内存、常驻服务或消息队列,唯一的连接是 approval_flow.sqlite。
uv run python flow.py submit R001 A1002 "键盘按键不灵,我手机 13812345678,想退货"
uv run python flow.py pending
uv run python flow.py decide R001 revise --feedback "写明运费由谁承担" --approver 李四
uv run python flow.py decide R001 approve --approver 李四
uv run python flow.py decide R001 approve --approver 张三
uv run python flow.py pending| 进程 | 命令 | 该看到 |
|---|---|---|
| 1 提交 | submit |
跑到 review 暂停,next=('review',),进程退出 |
| 2 列待办 | pending |
不调模型,只扫带中断的 thread |
| 3 改稿 | decide … revise |
起草第 2 稿,再次暂停 |
| 4 批准 | decide … approve |
send + archive,status=sent |
| 5 再批一次 | decide … approve |
[!] 当前不在审批中(next=() status=sent) |
| 6 再列待办 | pending |
没有待审批的工单 |
四个进程分别写入的审计流水,拼起来必须是一条没有断口的记录。进程 3、4 开头会再打一遍 [review] waiting,因为新进程的 SEEN 是空的,这是 §12 说的那个已知缺口。
16. 对照清单 #
读完 flow.py,用这张表自检。每一条都能指到函数名,而不是「看起来没问题」。
| 需求 | 代码位置 | 不这样写会怎样 |
|---|---|---|
| F1 校验工单 | submit |
模型编造订单号;未知订单 KeyError 炸归档 |
| F2 脱敏 | risk_check 的正则 |
完整手机号进模型请求体 |
| F3 超上限拒 | risk_check + after_risk |
5200 元的单也花一次模型钱 |
| F4 小额自动 | after_draft → auto → send |
129 元占人工队列 |
| F5 起草 | draft_node + 只读工具 |
Agent 自己发出去 |
| F6 三种决策 | review + after_review |
非法动作进图,或误发 |
| F7 改稿上限 | revisions 带 add + 返回 1 + after_review |
护栏失效,死循环 |
| F8 只发一次 | send 不在回边上,且不在 review 里 |
恢复时重发邮件 |
| F9 归档留痕 | abort/send → archive,audit 带 add |
失败路径没有终态 |
| F10 跨进程 | SqliteSaver + thread_id=request_id |
审批人无法接力 |
| F11 幂等 | cmd_submit 看 created_at |
重复提交冲掉旧单甚至二次发送 |
写业务图时可以当成检查单:先划「哪些步骤不能交给模型」,再把副作用和暂停拆到不同节点,计数器和 reducer 配套,失败写成状态而不是异常。flow.py 就是按这个顺序搭起来的。