1. 本章目标 #
第 5、6 章已经写过:
chain = prompt | model
chain = prompt | model.with_structured_output(Ticket)那时多半是「会用管道符」,但未必清楚:| 右边到底发生了什么、为什么整条链也能 stream / batch、并行和分支又该怎么写。
本章把背后的机制讲清楚:
一切可组合单元都是 Runnable;用 LCEL(
|、并行、分支)把提示、模型、解析、自定义逻辑拼成可复用处理链。
学完你应能:
- 理解 Runnable 的统一接口:
invoke/stream/batch/ainvoke - 用
|组成RunnableSequence(串行管道),并在链报错时拆链定位 - 用
RunnableParallel做并行(并能自己验证它真的在并行)、用RunnableBranch或函数路由做分支 - 用
RunnableLambda/RunnablePassthrough/StrOutputParser/@chain补齐中间步骤 - 说清「流式为什么会突然失效」,并用生成器函数修好它
- 用
with_retry/with_fallbacks/with_config给链加上生产环境该有的防护 - 产出:可组合的处理链
参考文档:
2. Runnable 与 LCEL 是什么 #
学 LCEL 之前,先把两个词的含义说清楚,否则后面讲「管道 / 并行 / 分支」时会对不上号。
可以记成:
- Runnable = 「能执行的积木」(协议)
- LCEL = 「用声明式语法把积木拼起来的语言」(主要是
|等写法)
积木可以是提示模板、模型、解析器;拼好的整条链,本身仍是一块积木。
2.1. 一句话 #
| 概念 | 含义 |
|---|---|
| Runnable | 统一「可执行单元」协议:输入 → 输出,并自带 invoke / stream / batch 等 |
| LCEL | LangChain Expression Language:用声明式写法组合 Runnable |
在 LangChain 里,提示模板、聊天模型、输出解析器、检索器,以及你用函数包一层的逻辑,大多都能当成 Runnable 来拼。
「能拼」的前提不是它们业务相同,而是它们都遵守同一套调用约定:你给输入,它返回输出;并且尽量支持同步、流式、批量。
  PromptTemplate / ChatPromptTemplate     提示词模板
  Chat Model                              聊天模型
  Output Parser                           输出解析器
  Retriever                               检索器
  RunnableLambda(任意函数)                 你自己的逻辑
              │
              │  它们都实现了 Runnable 协议
              ▼
  ┌─────────────────────────────────────────────┐
  │  同一套调用方法:                            │
  │    invoke / stream / batch / ainvoke ...     │
  │  同一套组合语法:                            │
  │    a | b | c                                 │
  └─────────────────────────────────────────────┘
              │
              ▼
        组合结果 chain,仍然是一个 Runnable
最后一行是整章的关键,再强调一次:
组合之后的
chain也是 Runnable。
所以你对模型会的invoke/stream,对整条链同样适用;而这条链还能作为一块积木,接进更大的链里。
这种「组合结果和组件是同一种东西」的设计,在编程里叫闭合性。好处是:只学一套调用方法,就能覆盖单个模型、三步小链,以及几十步的复杂流水线。
2.2. 为什么要用链,而不是手写函数套函数 #
手写三行调用也能跑通,但业务一变就容易「改一处、漏三处」:多加清洗、多加解析、换成结构化输出时,每个入口都得改一遍。
# 手写:每加一步都要改调用处
messages = prompt.format_messages(**inputs)
ai = model.invoke(messages)
text = ai.content

# LCEL:声明「步骤怎么接」,调用方式不变
chain = prompt | model | StrOutputParser()
text = chain.invoke(inputs)
两种写法关心的重点不同:
| 写法 | 你在维护什么 | 换步骤时 |
|---|---|---|
| 手写套函数 | 「怎么调用」散落在业务代码里 | 每个调用点都要改 |
| LCEL 链 | 「步骤顺序」集中在一处定义 | 多数情况只改链的定义 |
组合后的整条链仍然是 Runnable,因此:
- 换内部某一步,外层
invoke签名尽量不变 - 自动获得
stream/batch/ 异步能力(在组件支持的前提下) - 更容易被 LangSmith 按步骤追踪(每一步都是可观察节点)
一句话:链把「流水线长什么样」从调用现场抽出来,收成可复用组件。
3. 统一调用接口 #
Runnable 之所以能组合,关键不在 | 这个符号,而在大家都实现了同一套「怎么跑」的接口。
不必先分清组件是提示还是模型,记住一点就够:输入进去,用同一种方法取结果。
任意 Runnable(单个模型或整条链)常见四种调用:
| 方法 | 作用 | 典型场景 |
|---|---|---|
invoke |
一次输入 → 一次完整输出 | 默认、脚本、接口同步处理 |
stream |
增量产出 | 打字机式展示长回答 |
batch |
一批输入并行处理 | 批量摘要、批量分类 |
ainvoke / astream |
异步版本 | FastAPI / asyncio 服务 |
第 3 章已在 Model 上练过;本章重点是:拼好的链也一样用这些方法。
用的时候记住三点:
invoke最稳妥:先用它验证链是否接对,再考虑 stream / batch。stream的 chunk 类型取决于末端组件:末端是模型时常见AIMessageChunk;末端是StrOutputParser时常见字符串增量。但要注意流式是会被打断的,§9.2 会专门讲。batch不是「一个超长 prompt」,而是「多份独立输入一起跑」,可用max_concurrency控制并发。
3.1. 链能自我描述:查它要什么、给什么 #
接手别人写的链,最先想知道的是「它要什么输入、给什么输出」:
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

prompt = ChatPromptTemplate.from_messages(
    [("system", "用一句话回答。"), ("human", "{topic}")]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
chain = prompt | model | StrOutputParser()

# 这条链需要哪些输入字段
print(list(chain.get_input_jsonschema()["properties"].keys()))
# 输出的类型是什么
out = chain.get_output_jsonschema()
print(out["title"], out["type"])

# 链由哪些节点组成,按顺序排列
print([n.name for n in chain.get_graph().nodes.values()])
输出:
['topic']
StrOutputParserOutput string
['PromptInput', 'ChatPromptTemplate', 'ChatDeepSeek', 'StrOutputParser', 'StrOutputParserOutput']
这三条信息各有用处:
| 方法 | 告诉你什么 | 什么时候用 |
|---|---|---|
get_input_jsonschema() |
需要哪些输入字段 | 忘了模板变量叫什么、给接口写参数校验 |
get_output_jsonschema() |
输出是什么类型 | 判断下一步能不能接、要不要加 parser |
get_graph().nodes |
链由哪些节点组成 | 确认链的结构和你以为的一致 |
节点列表首尾两个(PromptInput、StrOutputParserOutput)是 LangChain 自动加的输入/输出占位,中间三个才是你写的组件。
想看 ASCII 结构图,用 chain.get_graph().draw_ascii()
uv add grandalf
`
# 打印链的结构图(以ASCII图形式展示)
print(chain.get_graph().draw_ascii())想看 Mermaid 源码或导出图片,用 draw_mermaid() 和 draw_mermaid_png()
uv add Pillow# 导入 PIL 库的 Image 类,用于图片处理
from PIL import Image
# 导入 BytesIO,用于处理内存中的二进制流
from io import BytesIO
# 获取链的结构 mermaid 格式源码(SVG 代码)
raw_mermaid = chain.get_graph().draw_mermaid()
# 打印 mermaid 格式源码到控制台
print(raw_mermaid)
# 获取链结构的 mermaid 图,并转换成 png 图片的字节数据
png_bytes = chain.get_graph().draw_mermaid_png()
# 使用 BytesIO 将 png 字节数据转换为文件对象(无需落盘)
img = Image.open(BytesIO(png_bytes))
# 显示图片(会弹出系统默认的图片查看器窗口)
img.show()4. 管道:RunnableSequence #
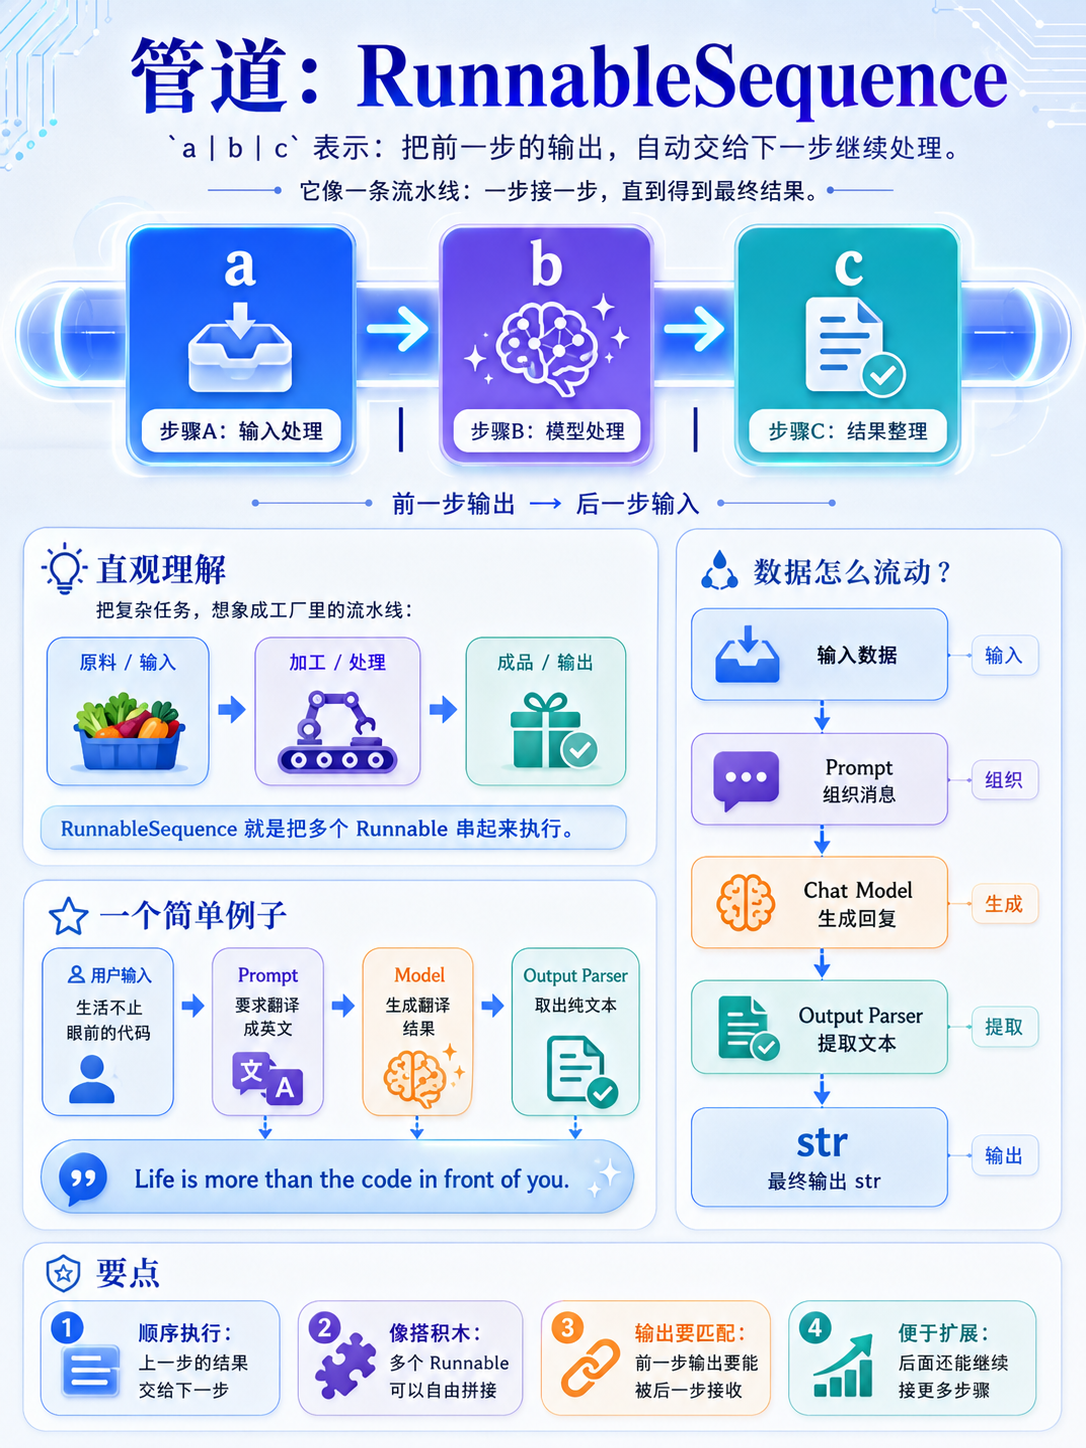
串行管道是 LCEL 最常用、也好懂的形态:上一步输出,原样(或经自动转换后)成为下一步输入。a | b | c 就是「先 a,再 b,再 c」;底层类型是 RunnableSequence。
适合步骤顺序事先就确定的任务:翻译、摘要、分类、填表、RAG 生成段等。
不适合「中途要不要调工具、调几次」这种临场决策——那是 Agent 的事。
4.1. 1.pipe_prompt_model.py #
下面这条链只做一件事:把「目标语言 + 原文」变成「纯文本译文」。
# 从 langchain_core.prompts 导入对话提示词模板
from langchain_core.prompts import ChatPromptTemplate

# 从 langchain_core.output_parsers 导入字符串输出解析器
from langchain_core.output_parsers import StrOutputParser

# 从 langchain.chat_models 导入统一初始化聊天模型的工厂
from langchain.chat_models import init_chat_model

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env;override=True 覆盖已存在的同名变量
load_dotenv(override=True)

# 定义翻译任务的对话模板:系统约束 + 用户原文
prompt = ChatPromptTemplate.from_messages(
    [
        # 系统消息:指定目标语言,并要求只输出译文
        ("system", "把用户句子翻译成{target_lang},只输出译文。"),
        # 人类消息:待翻译文本
        ("human", "{text}"),
    ]
)

# 初始化 DeepSeek 聊天模型;temperature=0 使输出更稳定
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 串行管道:填模板 → 调模型 → 取出纯文本
chain = prompt | model | StrOutputParser()

# 整条链一次 invoke;输入是模板变量字典
print(
    chain.invoke(
        {
            "target_lang": "英文",
            "text": "生活不止眼前的代码",
        }
    )
)
输出:
Life is more than just the code in front of you.数据流(对照代码看一遍):
{"target_lang","text"}
        │
        ▼
   ChatPromptTemplate  →  List[Message]
        │
        ▼
     Chat Model        →  AIMessage
        │
        ▼
  StrOutputParser      →  str
三步各自的作用:
| 步骤 | 输入 | 输出 | 作用 |
|---|---|---|---|
prompt |
变量字典 | 消息列表 | 把业务变量填进角色化提示 |
model |
消息列表 | AIMessage |
真正调用大模型 |
StrOutputParser() |
AIMessage |
str |
只取出文本,方便后续使用 |
要点:
|左侧输出类型,必须能被右侧接受(或可自动转换)StrOutputParser()把AIMessage收成str,方便后面再接纯文本步骤- 调试时可拆开:先
prompt.invoke(...),再(prompt | model).invoke(...),最后整链
4.2. 拆链调试:一步一步往后加 #
这是本章最实用的习惯。链报错时别盯着整条链猜,从第一步开始往后加:
# 承接上面的代码

# 第一步:模板填对了吗
print(prompt.invoke({"target_lang": "英文", "text": "你好"}))

# 第二步:模型返回的是什么类型
print(type((prompt | model).invoke({"target_lang": "英文", "text": "你好"})).__name__)
输出:
messages=[SystemMessage(content='把用户句子翻译成英文,只输出译文。', additional_kwargs={}, response_metadata={}), HumanMessage(content='你好', additional_kwargs={}, response_metadata={})]
AIMessage
第一行确认模板变量都填进去了,第二行确认模型这一步产出 AIMessage——所以后面必须接能吃 AIMessage 的东西。
4.3. 两个最常见的报错,长什么样 #
初学阶段几乎所有报错都是这两类。先认清长相,下次不容易卡死。
一、把 AIMessage 当字符串用。 这是最高频的错:
# 错误示范:RunnableLambda 收到的是 AIMessage,不是 str
bad = prompt | model | RunnableLambda(lambda s: s.strip().upper())
bad.invoke({"topic": "LCEL"})
AttributeError: 'AIMessage' object has no attribute 'strip'这条报错很有用:它直接告诉你「你以为是字符串,其实是 AIMessage」。修法是中间补一个 StrOutputParser(),或在函数里写 s.content。
二、模板缺变量。 LangChain 的报错写得很清楚,包括期望什么、收到什么:
(prompt | model).invoke({})KeyError: "Input to ChatPromptTemplate is missing variables {'topic'}.
Expected: ['topic'] Received: []
Note: if you intended {topic} to be part of the string and not a variable,
please escape it with double curly braces like: '{{topic}}'"末尾那句提示要留意:提示词里本来就要出现大括号(比如让模型输出 JSON 示例)时,写成 {{ 和 }} 转义,否则会被当成变量。
排查口诀:报错里出现
has no attribute就是类型没接上,出现missing variables就是字典键没对上。 这两句覆盖了绝大多数情况。
5. RunnableLambda:把普通函数变成 Runnable #
任意「大致是单参数」的函数,都可用 RunnableLambda 包进链里。
业务逻辑不变,只是让函数拿到 Runnable 的组合能力与调用接口。
典型用途:预处理、后处理、取字典字段、格式转换。
5.1. 2.runnable_lambda.py #
from langchain_core.runnables import RunnableLambda
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)


# 普通函数:清洗用户输入(去空白、截断过长文本)
def clean_text(data: dict) -> dict:
    text = str(data["text"]).strip()
    # 过长则截断,避免提示膨胀
    data = {**data, "text": text[:200]}
    return data


prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用一句话总结用户内容,使用中文。"),
        ("human", "{text}"),
    ]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 清洗 → 提示 → 模型 → 字符串
chain = RunnableLambda(clean_text) | prompt | model | StrOutputParser()

print(chain.invoke({"text": "LangChain 把组件变成可组合的 Runnable。"}))
输出:
LangChain将组件抽象为可组合的Runnable。读这条链时抓住一点就够:
clean_text仍然返回字典,并且保留了text键,所以后面的ChatPromptTemplate才能继续吃{"text": ...}。
Lambda 步骤要让下一步好接,别只图自己方便。
5.2. 其实可以不写 RunnableLambda #
| 会自动把普通函数包装成 RunnableLambda,下面两种写法完全等价:
chain = RunnableLambda(clean_text) | prompt | model | StrOutputParser()   # 显式
chain = clean_text | prompt | model | StrOutputParser()                   # 自动包装
验证一下自动包装是否真的发生:
c = RunnableLambda(lambda x: x) | (lambda s: f"[{s}]")
print(type(c).__name__)            # RunnableSequence
print(type(c.steps[1]).__name__)   # RunnableLambda  <- 自动包好了
print(c.invoke("hi")) # [hi]函数放在最左边也可以(Runnable 重载了反向运算符):
c = (lambda s: f"[{s}]") | RunnableLambda(lambda x: x)
print(c.invoke("hi")) # [hi]实践中仍建议显式写 RunnableLambda:一是链里出现裸函数时,读代码要多想一秒「这是函数调用还是链的一步」;二是显式包装后才方便挂 .with_retry() 这类方法(§10)。
5.3. 函数还能多收一个 config 参数 #
RunnableLambda 包装的函数可以多收一个参数,用来接运行时配置(tags、metadata 等,§10.3 会讲用途):
from langchain_core.runnables import RunnableConfig


def clean_with_log(data: dict, config: RunnableConfig) -> dict:
    # 从 config 里读出调用方传进来的标签
    tags = config.get("tags", [])
    print(f"[清洗] 当前标签: {tags}")
    return {**data, "text": str(data["text"]).strip()[:200]}


chain = RunnableLambda(clean_with_log) | prompt | model | StrOutputParser()
chain.invoke({"text": "  一些文本  "}, config={"tags": ["debug"]})
参数名必须叫 config,LangChain 靠函数签名判断要不要注入这个参数。
5.4. 提前预警:普通函数会掐断流式 #
先打个预防针——这是本章最容易踩、也最难自己发现的坑:
在模型下游插一个普通
RunnableLambda,整条链的流式就没了——打字机效果会变成「转圈等几秒,然后整段蹦出来」。
原因和修法(写成生成器函数)放在 §9.2,那里有完整的计时对比。现在先记住:链要做流式输出时,往里加函数步骤要格外小心。
5.5. @chain 装饰器:把整段逻辑封成一条链 #
函数逻辑复杂到需要多行、又想对外表现成一条链时,用 @chain 比 RunnableLambda(...) 更顺手:
from langchain_core.runnables import chain


@chain
def my_pipeline(text: str) -> str:
    """自定义链:先清洗,再交给模型,最后加个前缀。"""
    cleaned = text.strip()[:100]
    result = (prompt | model | StrOutputParser()).invoke({"topic": cleaned})
    return f"[已处理] {result}"


print(type(my_pipeline).__name__)          # RunnableLambda
print(my_pipeline.invoke("  什么是 LCEL  "))
输出:
RunnableLambda
[已处理] LCEL 是 LangChain 表达式语言,用于以声明式方式组合链式模型调用和数据处理流程。
装饰后的 my_pipeline 就是正常 Runnable:能 invoke、能 batch、能用 | 接到别的链上。适合封装「内部有分支和循环、对外只是一个步骤」的逻辑。
6. RunnablePassthrough:原样传递 / 配 assign 补字段 #
并行或拼装字典时,常需要「把原问题原封不动带下去」,同时再挂上检索结果、用户 id、时间戳等附加字段。
6.1. RunnablePassthrough #
RunnablePassthrough():输入是什么,输出基本还是什么
# 演示 RunnablePassthrough 最简单的用法
from langchain_core.runnables import RunnablePassthrough

# 构造一个 RunnablePassthrough 实例
passthrough = RunnablePassthrough()

# 输入任意对象,RunnablePassthrough 都会原样返回
print(
    passthrough.invoke({"foo": 123, "bar": "baz"})
)  # 输出: {'foo': 123, 'bar': 'baz'}
print(passthrough.invoke("hello world"))  # 输出: hello world
6.2. RunnablePassthrough.assign #
RunnablePassthrough.assign(...):在保留原数据的基础上,计算并合并新字段
很多 RAG 前置步骤的骨架就是这样:{"question": ..., "context": ...}。
# 从 langchain_core.runnables 导入透传与 Lambda 包装两类 Runnable
from langchain_core.runnables import RunnablePassthrough, RunnableLambda

# 从 dotenv 导入环境变量加载函数
from dotenv import load_dotenv

# 加载 .env;override=True 表示覆盖已存在的同名环境变量
load_dotenv(override=True)


# 检索函数:根据问题返回一段固定上下文
def retrieve(question):
    # 返回与 Runnable 相关的说明文本,模拟检索结果
    return "LangChain 用 Runnable 统一组件接口,可用 | 组合。"


# 1) 先把问题字符串变成字典
# 2) assign:在保留原字段的同时,新增 context
# 将输入字符串包装成含 question 字段的字典 Runnable
to_dict = RunnableLambda(lambda q: {"question": q})
# 从字典中取出 question,调用 retrieve 得到上下文的 Runnable
context = RunnableLambda(lambda d: retrieve(d["question"]))
# 串接:先转字典,再 assign 追加 context 字段,得到 RAG 输入
rag_inputs = to_dict | RunnablePassthrough.assign(context=context)

# 用示例问题调用整条链并打印结果字典
print(rag_inputs.invoke("什么是 Runnable?"))
# {'question': '什么是 Runnable?', 'context': 'LangChain 用 Runnable ...'}
核心一行:
rag_inputs = to_dict | RunnablePassthrough.assign(context=context)用 | 把两个 Runnable 串起来:
to_dict先把原始问题"什么是 Runnable?"转成{"question": "什么是 Runnable?"}。RunnablePassthrough.assign(context=context)是「透传 + 赋值」:- 原字典会继续往下传;
context这条 Runnable 基于当前字典算出检索结果;- 结果合并为新键
context。
实际输出:
{'question': '什么是 Runnable?', 'context': 'LangChain 用 Runnable 统一组件接口,可用 | 组合。'}最终 rag_inputs 接收一个问题字符串,输出带 question 与 context 的字典。
后面做 RAG(第 12~15 章)时,这种结构会反复出现。
6.3. assign 只接受字典,别喂字符串 #
RunnablePassthrough.assign 的作用是「往字典里加键」,输入必须已经是字典。所以上面要先用 to_dict 转一道:
add_len = RunnablePassthrough.assign(n=RunnableLambda(lambda d: len(d["q"])))

print(add_len.invoke({"q": "hello"}))   # 字典输入,正常
print(add_len.invoke("hello"))          # 字符串输入,报错
{'q': 'hello', 'n': 5}
ValueError: The input to RunnablePassthrough.assign() must be a dict.这条报错很直白,不容易误判。记住顺序:先转成字典,再 assign。
6.4. RunnablePassthrough() 和 .assign() 的区别 #
两个名字很像,用途完全不是一回事:
| 写法 | 行为 | 典型用途 |
|---|---|---|
RunnablePassthrough() |
原样返回输入,什么也不做 | 在并行支路里占一个位,把原始输入也收进结果字典 |
RunnablePassthrough.assign(k=...) |
保留原字典,追加新键 k |
逐步往上下文里累积字段 |
7. 并行:RunnableParallel #
串行是「一个接一个」;并行是「同一份输入同时喂给多条支路,最后收成一个字典」。
什么时候该用并行?
- 同一段文本既要摘要,又要抽关键词、判情感
- RAG 里同时查多个来源(向量库 + 关键词库等)
- 想对比两个模型 / 两套提示的结果
注意:并行省的是等待时间(接近最慢那条支路),不是总 token 费用——支路越多,调用次数通常越多。
7.1. 先证明它真的在并行 #
「并行」容易被当成口号,先用可复现的方式验证一次。不调模型(省钱,也去掉网络波动),用 sleep 模拟三个各耗时 1 秒的步骤:
import time

from langchain_core.runnables import RunnableLambda, RunnableParallel


def slow(name, sec):
    """构造一个耗时 sec 秒的 Runnable。"""
    def f(x):
        time.sleep(sec)
        return f"{name}-done"

    return RunnableLambda(f)


# 并行:三条支路同时跑
parallel = RunnableParallel(a=slow("a", 1), b=slow("b", 1), c=slow("c", 1))
t0 = time.perf_counter()
print(parallel.invoke("x"))
print(f"并行耗时: {time.perf_counter() - t0:.2f}s")

# 串行对照:同样三步用 | 串起来
serial = slow("a", 1) | slow("b", 1) | slow("c", 1)
t0 = time.perf_counter()
serial.invoke("x")
print(f"串行耗时: {time.perf_counter() - t0:.2f}s")
输出:
{'a': 'a-done', 'b': 'b-done', 'c': 'c-done'}
并行耗时: 1.02s
串行耗时: 3.00s
1.02 秒对 3.00 秒,并行是实打实的。RunnableParallel 内部用线程池同时跑各支路,总耗时约等于最慢那条支路,而不是各支路之和。
适用边界也因此很清楚:
- 支路耗时差不多时收益最大(3 条 1 秒 → 1 秒,省 2/3)
- 有一条特别慢时收益有限(1 秒 + 1 秒 + 10 秒 → 还是 10 秒)
- 省的是时间,不是钱:上面这次仍然执行了 3 个步骤,换成真实模型就是 3 次调用、3 份 token 费用
7.2. 4.parallel_analysis.py #
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableParallel
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 支路 1:摘要
summary_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用一句话总结,不要举例。"),
        ("human", "{text}"),
    ]
)
summary_chain = summary_prompt | model | StrOutputParser()

# 支路 2:关键词
keywords_prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "提取 3 个中文关键词,用逗号分隔,不要其它文字。"),
        ("human", "{text}"),
    ]
)
keywords_chain = keywords_prompt | model | StrOutputParser()

# 并行:同一 text 同时做摘要与关键词
parallel = RunnableParallel(
    summary=summary_chain,
    keywords=keywords_chain,
)

result = parallel.invoke(
    {"text": "Runnable 让提示词、模型、解析器可以用管道组合,并统一支持流式与批量。"}
)
print(result)
# {'summary': '...', 'keywords': '...'}
实际输出:
{'summary': 'Runnable通过管道组合统一了提示词、模型和解析器的流式与批量执行。', 'keywords': '管道组合,流式,批量'}示意:
                ┌──► summary_chain  ──► "一句话…"
{"text": ...} ──┤
                └──► keywords_chain ──► "词1,词2,词3"
                         │
                         ▼
{"summary": ..., "keywords": ...}关键字参数名(summary= / keywords=)会成为结果字典的键。
7.3. 字典字面量会被自动当成并行 #
嵌在序列里时,常直接写字典,不必写 RunnableParallel:
chain = prompt | {
    "summary": summary_chain,
    "keywords": keywords_chain,
}这不是「看起来像并行」,而是真的转成了 RunnableParallel,并发行为完全一致:
# 导入time模块,用于计时和睡眠操作
import time
# 从langchain_core.runnables模块导入RunnableLambda类
from langchain_core.runnables import RunnableLambda

# 定义一个名为slow的函数,返回带有延时的RunnableLambda
def slow(name, seconds):
    # 定义一个内部函数fn,接受参数x
    def fn(x):
        # 睡眠指定的秒数
        time.sleep(seconds)
        # 返回一个格式化的字符串
        return f"{name}: {x}"
    # 返回以fn为函数体的RunnableLambda对象
    return RunnableLambda(fn)

# 创建一个chain,可处理输入并并行运行两个分支"a"和"b",每个分支有1秒延时
chain = RunnableLambda(lambda x: x) | {"a": slow("a", 1), "b": slow("b", 1)}

# 打印chain的第二个步骤的类型的名字,应该为RunnableParallel,表示自动转换为并行运行
print(type(chain.steps[1]).__name__)  # RunnableParallel  <- 自动转换了
# 记录当前的高精度计时器时间
t0 = time.perf_counter()
# 调用chain的invoke方法,输入"x",并打印结果
print(chain.invoke("x"))
# 打印耗时,精确到小数点后两位
print(f"耗时: {time.perf_counter() - t0:.2f}s")
RunnableParallel
{'a': 'a: x', 'b': 'b: x'}
耗时: 1.01s
两条 1 秒支路只花 1 秒,说明字典写法一样是并发的。两种写法按可读性选:单独定义并行块时用 RunnableParallel(...) 更清晰;串在长链中间时用字典字面量更紧凑。
7.4. 三个使用注意 #
一、支路的输入结构要一致。 上例各支路都吃 {"text": ...}。若某支路只要字符串,先取字段再接入:
import time
from langchain_core.runnables import RunnableLambda, RunnableParallel
# 统计文本长度的 Runnable(返回字符串长度)
def count_length(text):
    # 假设这里有复杂逻辑或延迟
    time.sleep(0.1)
    return len(text)
# 统计长度的 Runnable
count_chain = RunnableLambda(count_length)
# 摘要的 Runnable:这里用最简单的实现,返回原文前20个字符作为“摘要”
def simple_summary(d):
    return d["text"][:20] if "text" in d else ""
summary_chain = RunnableLambda(simple_summary)
# 并行Runnable
parallel_chain = RunnableParallel(
    summary=summary_chain,  # 输入为字典,输出摘要
    length=RunnableLambda(lambda d: d["text"]) | count_chain,  # 取出text后统计长度
)
input_data = {"text": "LangChain Runnable 统一了组件接口,支持流水线组合和流式。"}
result = parallel_chain.invoke(input_data)
print(result)
二、任何一条支路失败,整个并行就失败。 RunnableParallel 没有「部分成功」——一条支路抛异常,invoke 就抛异常,其它支路的结果也拿不到。需要容错时,给支路各自挂 with_fallbacks()(§10.2)。
三、并行可以流式,但 chunk 结构要留意。 每个 chunk 只带一个支路的增量,不会把所有支路打包给你:
import time
from langchain_core.runnables import RunnableLambda, RunnableParallel


# 每隔0.3秒,流式地返回输入text的一个字符,累积成字符串
def slow_char_stream(input_data):
    text = input_data["text"]
    acc = ""
    for c in text:
        time.sleep(0.3)
        acc += c
        yield acc


# 并行分支,a和b都处理同一个输入,但结果叠加交错
runnable_a = RunnableLambda(slow_char_stream)
runnable_b = RunnableLambda(slow_char_stream)
parallel = RunnableParallel({"a": runnable_a, "b": runnable_b})

# 消费端要注意:每个chunk只带一部分(不是完整并行结果)
result_acc = {"a": "", "b": ""}
for chunk in parallel.stream({"text": "Run"}):
    print(chunk)
{'a': 'R'}
{'b': 'R'}
{'a': 'Ru'}
{'b': 'Ru'}
{'a': 'Run'}
{'b': 'Run'}所以消费端要按键自己累加,别假设每个 chunk 都是完整字典。这和第 27 章 LangGraph 并行节点的 token 交错是同一类问题。
顺便提醒:a 和 b 谁先出来不保证。上面两条支路速度完全一样,实测 12 次里有 9 次是 a 先、2 次是 b 先、1 次中途还换了顺序。所以消费端只能靠 chunk 里的键来判断这一块属于谁,绝不能靠到达次序。
8. 分支:RunnableBranch #
分支解决的是「同一入口,不同模式走不同流水线」。
例如翻译、摘要、闲聊共用一个 API,但内部链完全不同。
规则很简单:
- 按顺序检查
(条件, 链); - 第一个条件为真的分支生效;
- 都不匹配则走最后一个默认 Runnable。
它和 if/elif/else 很像,但条件与链都被收成可组合的 Runnable,方便再接到更大的管道前后。
8.1. 5.branch_by_intent.py #
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnableBranch, RunnableLambda
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 三条业务链
translate_chain = (
    ChatPromptTemplate.from_messages(
        [
            ("system", "翻译成英文,只输出译文。"),
            ("human", "{text}"),
        ]
    )
    | model
    | StrOutputParser()
)

summarize_chain = (
    ChatPromptTemplate.from_messages(
        [
            ("system", "用一句话中文总结。"),
            ("human", "{text}"),
        ]
    )
    | model
    | StrOutputParser()
)

default_chain = (
    ChatPromptTemplate.from_messages(
        [
            ("system", "你是简洁助手,直接回答用户。"),
            ("human", "{text}"),
        ]
    )
    | model
    | StrOutputParser()
)


def intent_is(name: str):
    # 返回判定函数:输入字典里 intent 是否等于指定值
    return lambda x: x.get("intent") == name


# 按 intent 路由;最后一项是默认链
router = RunnableBranch(
    (intent_is("translate"), translate_chain),
    (intent_is("summarize"), summarize_chain),
    default_chain,
)

print(router.invoke({"intent": "translate", "text": "统一接口让组合更简单"}))
print(router.invoke({"intent": "summarize", "text": "统一接口让组合更简单"}))
print(router.invoke({"intent": "chat", "text": "统一接口让组合更简单吗?"}))
实际输出(三次调用各走一条链):
Unified interfaces simplify composition.
统一接口通过简化交互方式,让多个模块的组合与调用变得更加简单。
统一接口(如外观模式)通过提供一个简化的统一入口,确实能让组合更简单。它隐藏了底层多个组件的复杂性,调用方只需依赖一个接口,减少耦合,使系统更易使用和维护。但要注意,这并不改变底层组合逻辑本身,只是让外部调用更简洁。
示意:
{"intent","text"}
        │
        ├─ intent==translate → translate_chain
        ├─ intent==summarize → summarize_chain
        └─ 其它             → default_chain
8.2. 默认分支不是「建议」,是强制的 #
RunnableBranch 的最后一个参数必须是默认 Runnable。漏掉的话,构造时就报错,根本走不到 invoke:
b = RunnableBranch(
    (lambda x: x.get("m") == "a", RunnableLambda(lambda x: "A")),
    (lambda x: x.get("m") == "b", RunnableLambda(lambda x: "B")),
)
TypeError: RunnableBranch default must be Runnable, callable or mapping.这反而是好事——写错立刻失败,不会拖到运行时。原因也好理解:RunnableBranch 把最后一个位置参数当默认分支;你只给了两个元组,它就把第二个元组当成默认分支,发现类型不对便报错。
有默认分支时,未匹配的输入会落到默认分支:
b = RunnableBranch(
    (lambda x: x.get("m") == "a", RunnableLambda(lambda x: "A")),
    RunnableLambda(lambda x: "DEFAULT"),
)
print(b.invoke({"m": "a"}))    # A
print(b.invoke({"m": "zz"}))   # DEFAULT
8.3. 更常用的写法:用函数返回一条链 #
RunnableBranch 能用,但条件一多,括号和元组就很密。现在更推荐写一个普通函数,返回要走的那条链:
def route(x):
    """按 intent 返回对应的链;LCEL 会自动执行返回的 Runnable。"""
    intent = x.get("intent")
    if intent == "translate":
        return translate_chain
    if intent == "summarize":
        return summarize_chain
    return default_chain


router = RunnableLambda(route)

for intent in ["translate", "summarize", "chat"]:
    print(router.invoke({"intent": intent, "text": "统一接口让组合更简单"}))
这里有个关键机制要讲清:
当
RunnableLambda包装的函数返回一个 Runnable 时,LCEL 会自动继续执行它,把它的结果作为整体输出。所以route里只需要「挑出」一条链,不用自己.invoke()。
两种写法怎么选:
RunnableBranch |
函数返回链 | |
|---|---|---|
| 可读性 | 条件多时括号密集 | 就是普通 if/elif/else,最好读 |
| 灵活性 | 只能按顺序判断条件 | 能写任意逻辑(查表、算分、读配置) |
| 默认分支 | 强制要求,漏了报错 | 靠你自己写 return default_chain |
| 适合 | 条件少且规整 | 大多数情况 |
用函数写法时,别忘了兜底的 return——RunnableBranch 会强制你提供默认分支,函数不会。所有 if 都不匹配时函数返回 None,链会把 None 往下传,出错点往往离现场很远。
8.4. 分支的定位 #
实践建议:
- 条件尽量互斥,避免靠「碰巧谁写在前面」决定行为
- 一定要有默认分支(
RunnableBranch强制;函数写法要自己记得) - 实战中
intent也可先由上游分类链(或第 6 章结构化输出)生成,再交给路由
最后强调一点定位:
分支选的是「整条链」,不是模型内部的某个 token;它是编排层路由。
也就是说,路由由你的代码决定,不是模型自由发挥。连「有哪几条路」都要模型临场决定,那就已经是 Agent 的活了(§12 会讲怎么选)。第 23 章讲 LangGraph 条件边时,会把「代码做路由」推得更远:那里的分支不仅能选链,还能成环、回到之前的节点。
9. 链上的流式与批量 #
拼好的链仍然是 Runnable,第 3 章在模型上学过的 stream / batch,可以原样迁到链上。
好处是:调用方不用关心链里有几步,对 chain 调一次即可。
9.1. 流式:chain_stream.py #
流式适合长回答:边生成边展示,减轻等待感。
本节示例末端是 StrOutputParser(),所以 for chunk in chain.stream(...) 里的 chunk 直接是字符串增量。
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用三句话介绍主题,使用中文。"),
        ("human", "{topic}"),
    ]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0.3)
chain = prompt | model | StrOutputParser()

# 链的 stream:末端是 StrOutputParser 时,chunk 直接是字符串增量
for chunk in chain.stream({"topic": "LCEL"}):
    print(chunk, end="", flush=True)
print()
对比记忆(三种 stream 别混):
| API | 流出来的是什么 |
|---|---|
model.stream |
AIMessageChunk(用 .text / 累加) |
chain.stream(末端 StrOutputParser) |
str 增量 |
agent.stream |
图节点更新(模型步、工具步等) |
若链末端没有 parser,stream 的类型会更接近模型自己的 chunk:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv
from rich import print

load_dotenv(override=True)

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用三句话介绍主题,使用中文。"),
        ("human", "{topic}"),
    ]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0.3)
chain = prompt | model

# 链的 stream:末端是 StrOutputParser 时,chunk 直接是字符串增量
for chunk in chain.stream({"topic": "LCEL"}):
    print(chunk, end="", flush=True)
AIMessageChunk(
content='语言',
additional_kwargs={},
response_metadata={'model_provider': 'deepseek'},
id='lc_run--019ffab1-b344-7533-a093-11e18f6203de',
tool_calls=[],
invalid_tool_calls=[],
tool_call_chunks=[]
)首个 chunk 的 content 为空很常见(第 6 章和第 27 章都遇到过),渲染前要判断 if not chunk.content: continue。
9.2. 流式会被什么打断 #
这一节建议细看。流式失效不会报错,只表现为「打字机效果没了」——很多人以为是模型慢或网络问题,其实是链的结构问题。
先定一个测量方法:记录 chunk 数量和首个 chunk 到达时间。真流式的特征是 chunk 多、首字节快。
import time


def timed_stream(chain, inp, label):
    """测量流式质量:chunk 数量 + 首字节延迟。"""
    t0 = time.perf_counter()
    times = []
    for chunk in chain.stream(inp):
        times.append(time.perf_counter() - t0)
    print(f"{label}")
    print(f"  chunk 数: {len(times)}")
    print(f"  首个 chunk: {times[0]:.2f}s")
    print(f"  全部完成: {times[-1]:.2f}s")
基线:正常的三步链。
import time
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

# 确保能载入 API 密钥等环境变量
load_dotenv(override=True)


def timed_stream(chain, inp, label):
    """测量流式质量:chunk 数量 + 首字节延迟。"""
    t0 = time.perf_counter()
    times = []
    for chunk in chain.stream(inp):
        times.append(time.perf_counter() - t0)
    print(f"{label}")
    print(f"  chunk 数: {len(times)}")
    print(f"  首个 chunk: {times[0]:.2f}s")
    print(f"  全部完成: {times[-1]:.2f}s")


# 构建 prompt、model 和 chain
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用三句话介绍主题,使用中文。"),
        ("human", "{topic}"),
    ]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0.3)
chain = prompt | model | StrOutputParser()

timed_stream(chain, {"topic": "LCEL"}, "prompt | model | StrOutputParser")
prompt | model | StrOutputParser
  chunk 数: 119
  首个 chunk: 0.29s
  全部完成: 2.10sprompt | model | StrOutputParser
  chunk 数: 119
  首个 chunk: 0.29s
  全部完成: 2.10s
119 个 chunk,0.29 秒就开始出字——这是健康的流式。
踩坑:末端加一个普通函数。 只是想把结果转成大写,看似无害:
from langchain_core.runnables import RunnableLambda

c2 = prompt | model | StrOutputParser() | RunnableLambda(lambda s: s.upper())
timed_stream(c2, {"topic": "LCEL"}, "... | RunnableLambda(upper)")
prompt | model | StrOutputParser
chunk 数: 1
首个 chunk: 1.93s
全部完成: 1.93s119 个 chunk 塌成了 1 个,首字节从 0.29 秒变成 1.93 秒。 用户体验上,打字机效果彻底消失,变成转圈两秒再整段蹦出来。而且没有任何报错或警告。
原因不难理解:lambda s: s.upper() 需要拿到完整字符串才能工作。LCEL 只能等上游全部产出完毕,把结果交给它,再把它的单个返回值当作唯一的 chunk 吐出来。一个不支持流式的步骤,就会把下游的流式能力全掐断。
修法:写成生成器函数。 让函数接收迭代器、逐块 yield:
def upper_gen(chunks):
    """接收上游的 chunk 迭代器,逐块处理后 yield 出去。"""
    for c in chunks:
        yield c.upper()


c3 = prompt | model | StrOutputParser() | upper_gen
timed_stream(c3, {"topic": "LCEL"}, "生成器函数")
prompt | model | StrOutputParser
chunk 数: 127
首个 chunk: 0.27s
全部完成: 2.15s流式回来了:127 个 chunk,首字节 0.27 秒。关键区别在函数签名——普通函数收到的是「完整结果」,生成器函数收到的是「chunk 迭代器」。
这里发生了一次自动转换。打印链的步骤类型就能看到:
c3 = prompt | model | StrOutputParser() | upper_gen
print([type(s).__name__ for s in c3.steps])
['ChatPromptTemplate', 'ChatDeepSeek', 'StrOutputParser', 'RunnableGenerator']LCEL 识别出 upper_gen 是生成器函数,把它包成 RunnableGenerator 而不是 RunnableLambda——流式能保持,靠的就是这个。
9.2.1. 别手动用 RunnableLambda 包生成器 #
既然生成器函数能保持流式,手动包一层 RunnableLambda 是不是也一样?不一样,而且这个坑很隐蔽。
四种写法放一起测(结果如下):
| 写法 | chunk 数 | 首字节 | 总计 | 说明 |
|---|---|---|---|---|
| 基线(无额外步骤) | 122 | 0.40s | 2.31s | |
| 裸生成器函数 | 125 | 0.28s | 2.33s | |
| RunnableGenerator(upper_gen) | 133 | 0.28s | 2.14s | |
| RunnableLambda(upper_gen) | 176 | 2.13s | 2.13s | 有问题 |
| RunnableLambda(lambda s: ...) | 1 | 2.07s | 2.07s | 完全打断 |
正确写法只有两种:直接把生成器函数放进 | 让它自动转换,或显式写 RunnableGenerator(upper_gen)。别用 RunnableLambda 包它。
重要的例外:模型上游的函数不受影响。
c4 = RunnableLambda(lambda d: d) | prompt | model | StrOutputParser()
timed_stream(c4, {"topic": "LCEL"}, "RunnableLambda | prompt | model | parser")
RunnableLambda | prompt | model | parser
chunk 数: 98
首个 chunk: 0.23s
全部完成: 2.00s完全正常。规则可以写得更精确:
只有位于「流式来源(模型)下游」的非流式步骤才会打断流式。 输入清洗、参数适配这类前置函数放心写,它们在模型开始产出之前就跑完了。
9.3. 全栈流式速查(模型 / 链 / Agent) #
上线前常要回答:「用户看到的打字机效果,该调哪一层?」对照下表。
| 层级 | 入口 | 典型 stream_mode / 行为 |
适合场景 |
|---|---|---|---|
| 模型 | model.stream(messages) |
逐 token / AIMessageChunk |
纯聊天、只要最终文本流 |
| LCEL 链 | chain.stream(input) |
末端 parser 决定 chunk 类型 | 固定流水线边生成边展示 |
| Agent | agent.stream(input, stream_mode=...) |
"updates":每步节点增量;"values":每步完整状态 |
调试工具环、观察中间步 |
| 高级(第 27 章预告) | astream_events |
细粒度事件(on_chat_model_stream 等) | 复杂 UI、自定义进度条 |
Agent 流式最小示例(与第 2 章一致,便于对照):
# 从 langchain.agents 导入 create_agent,用于创建智能体
from langchain.agents import create_agent
# 导入 load_dotenv 用于加载环境变量
from dotenv import load_dotenv

# 加载环境变量,override=True 表示覆盖已存在的变量
load_dotenv(override=True)

# 创建一个 agent,指定模型为 deepseek:deepseek-v4-flash,不使用工具,系统提示语为“简洁回答。”
agent = create_agent(
    model="deepseek:deepseek-v4-flash",
    tools=[],
    system_prompt="简洁回答。",
)

# 使用 agent 的 stream 方法流式调用,输入为用户消息“用三句话介绍 LCEL”,流式模式为 "updates"
for step in agent.stream(
    {"messages": [{"role": "user", "content": "用三句话介绍 LCEL"}]},
    stream_mode="updates",
):
    # 打印每一步的返回结果
    print(step)
产品上要「只流最终答复文字」时,优先 model.stream 或链末端 StrOutputParser + chain.stream;
要「展示正在调哪个工具」时,用 agent.stream(..., stream_mode="updates") 或看 LangSmith 轨迹。
9.4. 异步:ainvoke / astream #
FastAPI、asyncio 服务里要用 Runnable 的异步接口,避免阻塞事件循环:
import asyncio
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

prompt = ChatPromptTemplate.from_messages([("human", "{q}")])
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
chain = prompt | model | StrOutputParser()


async def main():
    # 单请求异步
    text = await chain.ainvoke({"q": "一句话介绍 Runnable"})
    print(text)
    # 流式异步
    async for chunk in chain.astream({"q": "一句话介绍 LCEL"}):
        print(chunk, end="", flush=True)


asyncio.run(main())规则:同步用 invoke / stream,异步用 ainvoke / astream;Agent 同样支持 await agent.ainvoke(...)。
更细的事件流(astream_events)和 LangGraph 编排见第 19 章。
容易忽略的一点:同步方法在异步环境里也能跑,但会阻塞事件循环。在 FastAPI 的 async def 里写 chain.invoke(...) 不报错,却会把整个事件循环卡住,并发能力大幅下降。这类问题往往到压测才暴露,所以从一开始就用带 a 前缀的方法。
9.5. 批量:chain_batch.py #
batch 处理的是「多份彼此独立的输入」,例如一次性概括三句话。
它不是把三句话拼成一个超长 prompt,而是对列表里每一项分别跑同一条链;可用 max_concurrency 控制并行度。
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

load_dotenv(override=True)

prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "用四个字概括,不要标点以外的解释。"),
        ("human", "{text}"),
    ]
)
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
chain = prompt | model | StrOutputParser()

outputs = chain.batch(
    [
        {"text": "春天播种希望"},
        {"text": "夏天热情似火"},
        {"text": "秋天收获满满"},
    ],
    config={"max_concurrency": 3},
)
for o in outputs:
    print(o)
输出:
春种希望
热情似火
硕果累累
与 RunnableParallel 的区别:
batch |
RunnableParallel |
|
|---|---|---|
| 输入 | 多份输入,同一条链 | 一份输入,多条支路 |
| 输出 | 与输入等长的结果列表 | 一个字段字典 |
| 典型场景 | 批量处理任务 | 多视角分析同一文本 |
9.5.1. max_concurrency 确实有效 #
这个参数不是摆设,直接影响耗时。用 5 个各 1 秒的任务验证:
import time

from langchain_core.runnables import RunnableLambda


def slow_fn(x):
    time.sleep(1)
    return x


r = RunnableLambda(slow_fn)
for mc in [1, 5]:
    t0 = time.perf_counter()
    r.batch(list(range(5)), config={"max_concurrency": mc})
    print(f"max_concurrency={mc}: 耗时 {time.perf_counter() - t0:.2f}s")
max_concurrency=1: 耗时 5.00s
max_concurrency=5: 耗时 1.00s该调多大? 主要受供应商速率限制(RPM / TPM)约束,不是越大越好。调太大会集中撞上 429,反而更慢。实践中从 5~10 起步,观察有没有限流再调。
9.5.2. 一条失败会拖垮整批 #
默认行为要特别注意:批里任何一项抛异常,整个 batch 调用就抛异常,已经成功的结果也一并拿不到。
from langchain_core.runnables import RunnableLambda


def maybe_fail(x):
    if x == "bad":
        raise ValueError(f"处理 {x} 失败")
    return f"ok-{x}"


r = RunnableLambda(maybe_fail)
print(r.batch(["a", "bad", "c"]))
ValueError: 处理 bad 失败跑了 100 条、第 99 条挂了,前 98 条的结果和 token 费用就都白花了。
解法是 return_exceptions=True,让异常作为结果放在对应位置再返回:
out = r.batch(["a", "bad", "c"], return_exceptions=True)
for i, o in enumerate(out):
    kind = "异常" if isinstance(o, Exception) else "正常"
    print(f"[{i}] {kind}: {o!r}")
[0] 正常: 'ok-a'
[1] 异常: ValueError('处理 bad 失败')
[2] 正常: 'ok-c'结果列表和输入等长且对齐,靠下标就能知道哪一条失败了,再单独重试或记录。
约定:批量处理线上数据时,
return_exceptions=True几乎应该默认打开,再配合isinstance(o, Exception)逐条判断。否则一条脏数据就能让整批任务归零。
10. 生产必备:重试、回退、配置 #
前面几节都在讲「怎么把链拼起来」。这一节讲「怎么让拼好的链在真实环境里活下来」。
线上调模型难免遇到超时、限流(429)、供应商偶发 5xx。手写 try/except 加重试当然可以,但每条链都写一遍很啰嗦。Runnable 提供了三个方法,直接挂在任意链上就能用——返回的仍然是 Runnable,不影响后续组合。
| 方法 | 解决什么 | 一句话 |
|---|---|---|
with_retry() |
偶发失败 | 同一条链,多试几次 |
with_fallbacks() |
持续失败 | 换一条备用链 |
with_config() |
可观测性 | 给链贴上名字和标签 |
10.1. with_retry():失败自动重试 #
适合处理偶发故障:网络抖动、供应商瞬时超时、限流。
from langchain_core.runnables import RunnableLambda

calls = {"n": 0}


def flaky(x):
    """模拟前两次失败、第三次成功的不稳定服务。"""
    calls["n"] += 1
    if calls["n"] < 3:
        raise ValueError(f"第 {calls['n']} 次失败")
    return f"第 {calls['n']} 次成功"


# stop_after_attempt=4 表示最多尝试 4 次(含第一次)
robust = RunnableLambda(flaky).with_retry(stop_after_attempt=4)

print(robust.invoke("x"))
print(f"实际调用次数: {calls['n']}")
第 3 次成功
实际调用次数: 3前两次失败被自动吞掉,第三次成功后正常返回,调用方完全感知不到。
重试是带指数退避的,不是立刻重试。 实测三次尝试全部失败的总耗时,两次运行分别是 3.68 秒 和 4.72 秒:
3 次尝试共耗时: 4.72s,调用 3 次函数本身瞬间就抛异常,这几秒几乎全是等待——第一次失败后等一会儿,第二次失败后再等更久。数字每次不同,是因为默认加了随机抖动(见下表的 wait_exponential_jitter)。
这是刻意设计的:服务正在过载时,立刻重试只会加重负担。副作用是超时预算要留够——别在上游设 2 秒超时,却指望它重试 3 次。
常用参数:
| 参数 | 作用 |
|---|---|
stop_after_attempt |
最多尝试几次(含第一次) |
retry_if_exception_type |
只对指定异常类型重试,例如 (TimeoutError,) |
wait_exponential_jitter |
是否加随机抖动,默认 True,避免大量请求同时重试 |
retry_if_exception_type 建议用起来。 默认对所有异常重试,但很多错误重试毫无意义——比如 API Key 写错、提示词缺变量,重试 4 次只是把同一个错误犯 4 遍。只对真正可能自愈的异常重试更合理。
10.2. with_fallbacks():主链挂了换备用链 #
重试解决的是「再试一次就好了」;若是持续失败——某家供应商挂了、某个模型下线了——就该换一条路。
from langchain_core.runnables import RunnableLambda

# 主链:故意抛异常模拟服务不可用
primary = RunnableLambda(lambda x: (_ for _ in ()).throw(ValueError("主链挂了")))
backup = RunnableLambda(lambda x: f"备用链处理了 {x}")

chain = primary.with_fallbacks([backup])
print(chain.invoke("订单查询"))
备用链处理了 订单查询真实场景里,备用链通常是换模型:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from dotenv import load_dotenv

# 加载环境变量(如果需要 API KEY 等)
load_dotenv(override=True)

# 构造提示模板
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是专业的知识问答助手,用简洁中文回答。"),
        ("human", "{question}"),
    ]
)

# 初始化两个模型,一个强模型,一个便宜模型作为回退
strong = init_chat_model("deepseek:deepseek-v4-pro", temperature=0)
cheap = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 构建主链条和回退链条,并指定回退规则
chain = (prompt | strong | StrOutputParser()).with_fallbacks(
    [prompt | cheap | StrOutputParser()]
)

question = "LCEL 与传统的函数嵌套调用相比有什么优势?"
print(chain.invoke({"question": question}))
with_fallbacks 接收的是一个列表,可以配多级兜底:主模型 → 备用模型 → 固定话术。最后一级常常干脆不调模型,直接返回「系统繁忙,请稍后再试」,保证接口始终有响应。
with_retry 和 with_fallbacks 通常一起用:
# 先在主链上重试几次,仍然不行才切备用链
chain = (
    (prompt | strong | StrOutputParser()).with_retry(stop_after_attempt=3)
    .with_fallbacks([prompt | cheap | StrOutputParser()])
)顺序有讲究:with_retry 挂在主链上,with_fallbacks 挂在外层。这样才是「主链努力三次,确实不行再换人」;写反了就变成「主链失败立刻换备用,再对整体重试三次」。
第 10 章的
ModelFallbackMiddleware是这个思路在 Agent 层的封装,内核是同一件事。
10.3. with_config():给链贴标签,为可观测性铺路 #
链一多,日志里全是 RunnableSequence 就没法看了。with_config 可以给链起名字、贴标签:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from langchain_core.runnables import RunnableLambda
from dotenv import load_dotenv

# 加载环境变量(如果需要 API KEY 等)
load_dotenv(override=True)

# 构造提示模板
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是专业的知识问答助手,用简洁中文回答。"),
        ("human", "{topic}"),
    ]
)

# 初始化模型
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)

# 组装链条
chain = prompt | model | StrOutputParser()

# 给链条绑定配置
named = chain.with_config({"run_name": "翻译链", "tags": ["prod", "v1"]})
print(type(named).__name__)  # RunnableBinding
print(named.config)
print(named.invoke({"topic": "LCEL"}))
也可以在调用时临时传入,不改链本身:
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain.chat_models import init_chat_model
from langchain_core.runnables import RunnableLambda
from dotenv import load_dotenv

# 加载环境变量(如果需要 API KEY 等)
load_dotenv(override=True)

# 构造提示模板
prompt = ChatPromptTemplate.from_messages(
    [
        ("system", "你是专业的翻译助手,请将用户输入的文本翻译成英文。"),
        ("human", "{text}"),
    ]
)

# 初始化模型
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)


def upper(x, config):
    print(config)
    return x.upper()


# 组装链条
chain = prompt | model | StrOutputParser() | RunnableLambda(upper)

# 给链条绑定配置
chain.invoke(
    {"text": "你好,世界!"}, config={"run_name": "translate", "tags": ["debug"]}
)
常用字段:
| 字段 | 作用 |
|---|---|
run_name |
这次运行的名字,在 LangSmith 里就是这个名字 |
tags |
标签列表,用于筛选(区分环境、版本、实验组) |
metadata |
任意键值对,例如 user_id、request_id |
max_concurrency |
限制 batch 并发度(§9.5.1) |
现在贴的标签暂时只能在日志里看到,但第 29 章接上 LangSmith 后,它们会变成可筛选、可对比的追踪维度——比如筛出所有 tags=["v2"] 的调用,对比改版前后的成功率。所以从现在就养成习惯:给每条上线的链起个人类可读的名字。
11. 一条可组合的处理链 #
前面几节是零件。本节把管道、并行、分支收成一个小应用:内容工作室。
目标不是堆技巧,而是演示「可组合」长什么样:
- 入口统一:都吃
{"text", "mode"} - 内部可替换:换提示、换模型,不改调用方式
- 模式可扩展:以后加
title/rewrite,主要改分支表
流程:
输入 {"text","mode"}
   │
   ├─ mode == "analyze"(默认分析)
   │     └─ 并行:summary + keywords + sentiment
   │
   ├─ mode == "translate"
   │     └─ 翻译成英文
   │
   └─ 其它
         └─ 简洁问答
11.1. 8.content_studio_chain.py #
# 导入 ChatPromptTemplate,用于创建对话提示模板
from langchain_core.prompts import ChatPromptTemplate

# 导入 StrOutputParser,用于输出字符串解析
from langchain_core.output_parsers import StrOutputParser

# 导入 RunnableParallel、RunnableBranch、RunnableLambda,用于链式操作
from langchain_core.runnables import RunnableParallel, RunnableBranch, RunnableLambda

# 导入模型初始化函数
from langchain.chat_models import init_chat_model

# 导入 dotenv,用于加载环境变量
from dotenv import load_dotenv

# 加载 .env 文件中的环境变量,override 表示覆盖已存在的变量
load_dotenv(override=True)

# 初始化对话模型,指定模型名称和温度参数
model = init_chat_model("deepseek:deepseek-v4-flash", temperature=0)
# 创建一个字符串输出解析器实例
to_str = StrOutputParser()


# 定义工厂函数,根据 system 提示创建一条链
def make_chain(system: str):
    # 创建对话提示模板,包含 system 和 human 两个角色
    prompt = ChatPromptTemplate.from_messages(
        [
            ("system", system),
            ("human", "{text}"),
        ]
    )
    # 返回由 prompt、model、to_str 组成的链
    return prompt | model | to_str


# 创建一个链:一句话中文总结
summary = make_chain("一句话中文总结,不要前缀。")
# 创建一个链:提取 3 个关键词
keywords = make_chain("提取 3 个关键词,逗号分隔,不要其它文字。")
# 创建一个链:判断情感
sentiment = make_chain("只输出:正面 / 负面 / 中性")
# 创建一个链:翻译为英文
translate = make_chain("翻译成英文,只输出译文。")
# 创建一个链:简洁助手直接回答
chat = make_chain("你是简洁助手,直接回答。")

# 创建多任务并行链,三个任务并行执行
analyze = RunnableParallel(
    summary=summary,
    keywords=keywords,
    sentiment=sentiment,
)

# 创建分支链,根据 mode 字段选择不同处理逻辑
studio = RunnableBranch(
    (lambda x: x.get("mode") == "translate", translate),
    (lambda x: x.get("mode") == "analyze", analyze),
    chat,
)

# 对输入进行规范化(可选),转换后再进入 studio 分支处理
studio_chain = (
    RunnableLambda(
        lambda x: {
            "text": str(x.get("text", "")).strip(),
            "mode": x.get("mode", "analyze"),
        }
    )
    | studio
)

# 示例输入文本
sample = "新版本把提示词、模型和解析器都统一成 Runnable,组合成本明显下降。"

# 打印 analyze 模式的输出
print("=== analyze ===")
print(studio_chain.invoke({"text": sample, "mode": "analyze"}))

# 打印 translate 模式的输出
print("=== translate ===")
print(studio_chain.invoke({"text": sample, "mode": "translate"}))

# 打印 chat 模式的输出
print("=== chat ===")
print(
    studio_chain.invoke(
        {"text": "LCEL 和手写函数套函数比,好处是什么?", "mode": "chat"}
    )
)
实际输出:
=== analyze ===
{'summary': '新版本统一了提示词、模型和解析器为 Runnable,显著降低了组合成本。', 'keywords': 'Runnable,组合成本,统一', 'sentiment': '正面'}
=== translate ===
The new version unifies prompts, models, and parsers into Runnable, significantly reducing composition costs.
=== chat ===
LCEL 的核心优势在于声明式组合与运行时增强:
- **可读性**:用 `|` 管道直观表达数据流,替代嵌套函数调用
- **内置优化**:自动支持流式输出、异步执行、并行调用和批处理
- **增强能力**:内置重试、回退、超时控制,以及自动追踪
- **可组合性**:模块可复用、可参数化,便于构建复杂链式应用
注意 analyze 模式返回的是字典(三条并行支路的结果),而 translate 和 chat 返回的是字符串。这是分支的正常现象——不同分支的输出类型可以不同。若调用方要统一处理,就得自己判断类型,或让每个分支都包装成同样的结构。
读代码时按三层看:
make_chain:消除重复,很多小链只是系统提示不同analyze:并行组合多种分析结果studio/studio_chain:先规范化输入,再按mode路由
这就是本章实战:可组合的处理链——步骤可替换、模式可扩展,调用方只关心 invoke 的输入字典。
11.2. 给它挂上生产防护 #
上面的版本能跑,但离上线还差 §10 那三件事。补齐之后是这样:
# 承接上面的代码

studio_chain = (
    RunnableLambda(
        lambda x: {
            "text": str(x.get("text", "")).strip(),
            "mode": x.get("mode", "analyze"),
        }
    )
    | studio
).with_retry(stop_after_attempt=3).with_config(
    {"run_name": "内容工作室", "tags": ["studio", "v1"]}
)
只加了两个方法调用,就得到了:偶发失败自动重试三次;日志和后续 LangSmith 追踪里显示为「内容工作室」而不是 RunnableSequence。调用方式完全不变——这正是「组合结果仍是 Runnable」带来的好处。
12. 和 Agent / 结构化输出怎么配合 #
LCEL 不是万能胶。选型时先问自己一句:
下一步怎么走,是我现在就能画出来,还是必须让模型当场决定?
| 场景 | 更合适的组合方式 |
|---|---|
| 固定流水线:翻译、摘要、分类、填表 | LCEL 链(本章) |
| 需要模型自己决定调哪些工具、调几次 | create_agent(第 2 / 9 章) |
| 链的末端要稳定字段 | model.with_structured_output(Schema)(第 6 章) |
| 复杂状态机、审批、人机协同 | LangGraph(第 19 章) |
经验法则:
步骤顺序你能事先画清楚 → 用 LCEL;步骤要靠模型临场决策 → 用 Agent。
它们经常共存:例如先用 LCEL 做检索与拼装,再把结果交给 Agent;或在 LCEL 末端接 with_structured_output,直接产出可入库对象。
12.1. LCEL 和 LangGraph 的边界在哪 #
LCEL 和 LangGraph 解决的是不同层面的问题;LangGraph 的节点里经常就是一条 LCEL 链。
| LCEL | LangGraph | |
|---|---|---|
| 数据流向 | 单向往前,像流水线 | 可以有环、可以回退 |
| 状态 | 只有「上一步的输出」 | 有一份贯穿全程的 state |
| 能不能暂停 | 不能 | 能(interrupt,第 26 章) |
| 能不能持久化 | 不能 | 能(checkpointer) |
| 复杂度 | 低,几行就能写 | 高,要定义 state 和节点 |
判断标准很简单:
需要「回头」「暂停」「记住之前发生了什么」——用 LangGraph;一路向前走完就结束——用 LCEL。
所以别急着把所有 LCEL 链改写成图。翻译、摘要、分类这类任务,LCEL 就是最合适的工具;上 LangGraph 反而是过度设计。
13. 实用约定与坑 #
- 先保证每一步输入输出类型匹配:最常见报错是
'AIMessage' object has no attribute 'strip'(类型没接上)或missing variables(字典键没对上) - 调试时拆链:
prompt.invoke(x)→(prompt|model).invoke(x)逐步加,定位卡在哪一步(§4.2) - 不确定链要什么输入时问它自己:
chain.get_input_jsonschema()(§3.1) - 模型下游别放普通函数,否则流式会静默失效;要处理流式内容就写成生成器函数,并且别用
RunnableLambda包它(会缓冲,§9.2.1) - 判断流式好坏看首字节延迟,不看 chunk 数量:chunk 再多,全在最后一刻到达也等于没流式
- 并行支路共享输入结构:不一致时用
RunnableLambda做适配 - 并行支路一条失败就整体失败:需要容错时给支路挂
with_fallbacks() StrOutputParser放在需要纯文本的位置:后面还要消息对象就不要过早 parse- 分支条件要互斥、有默认:
RunnableBranch漏了默认分支会在构造时报TypeError;用函数路由时要自己记得写兜底return - 批量处理线上数据开
return_exceptions=True:否则一条脏数据毁掉整批(§9.5.2) - 链也是 Runnable:可以
big = prep | studio_chain | post继续嵌套 - 先 invoke 跑通,再上 stream/batch:否则流式错误更难读
- 上线的链都起个名字:
with_config({"run_name": ...}),第 29 章接 LangSmith 时会感谢自己
记住口诀:
先类型,再组合;先串行,再并行;先跑通,再流式;上线前加重试和名字。
14. 练习 #
- 加解析器:把第 5 章翻译模板改成
prompt | model | StrOutputParser(),确认返回类型是str。 - 查链的输入:用
get_input_jsonschema()打印上一题那条链需要的字段,再用get_graph().nodes看它由哪些节点组成。 - 并行对比:对同一段产品评价并行生成「优点」「缺点」「一句话推荐」,打印三字段字典。
- 验证并行:用
time.sleep构造三条各 2 秒的支路,分别用RunnableParallel和|串行跑一遍,对比耗时是否为 2 秒和 6 秒。 - 亲手打断流式:在
prompt | model | StrOutputParser()后面接一个RunnableLambda(lambda s: s.strip()),用 §9.2 的timed_stream测量,确认 chunk 数塌成 1;再改成生成器函数修好它。 - 分支扩展:给
RunnableBranch增加mode=="title"(生成标题)分支;再用 §8.3 的函数路由写法实现同样的逻辑,对比哪个更好读。 - Lambda 清洗:在内容工作室入口过滤空文本,空则直接返回
"(无内容)",不调用模型。 - 容错演练:给内容工作室的某条支路故意传入会报错的输入,观察整个并行是否失败;再给它挂
with_fallbacks([固定话术链]),确认能兜住。 - 流式展示:对
translate模式使用studio_chain.stream(...),边生成边打印。
15. 本章小结 #
- Runnable 是统一可执行协议;LCEL 用声明式组合(核心是
|)。组合结果仍是 Runnable,所以能无限嵌套。 a | b | c→ 串行RunnableSequence;字典 /RunnableParallel→ 并行;RunnableBranch或函数返回链 → 条件路由。- 并行是真并行:三条 1 秒支路总耗时 1.02 秒(串行 3.00 秒)。省的是时间,不是 token 费用。
RunnableLambda/RunnablePassthrough/StrOutputParser用来补清洗、透传与收口;普通函数放进|会自动包装,复杂逻辑可用@chain装饰器。- 拼好的链同样支持 invoke / stream / batch / ainvoke / astream。
- 模型下游的普通函数会静默掐断流式(chunk 从 105 塌成 1,首字节从 0.25s 变 2.06s),改写成生成器函数即可恢复——但别用
RunnableLambda包生成器,那样会缓冲。这是本章最容易踩的坑。 - 批量默认一损俱损:
batch(return_exceptions=True)让异常按位返回,别让一条脏数据毁掉整批。 - 上线三件套:
with_retry()应对偶发失败、with_fallbacks()应对持续失败、with_config()起名字为可观测性铺路。 - 固定流水线用 LCEL;临场工具决策用 Agent;要回头 / 暂停 / 记状态用 LangGraph——三者经常在同一应用里共存。
下一章:Tools 工具定义与调用——@tool、参数 schema、错误处理、bind_tools,做出可复用的业务工具包。